GPUをつなぐのは誰か: Enfabrica ACF-S、ConnectX、leaf-spineスイッチASICから理解するAIDCネットワーク
絶ノイアの章 Sil-Kathnaの章出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
51bb764ccbf0cf2c72ec8fe4a107e1c9192cd443dab3e5a7530d88773cae1be2- 保存版のSHA-256
a3fde112ba2a091ea379159ef60649745822f73cf7fa1e086ae86717524b8cb9
外部証明の最終検査結果は詳細を開くと表示します。
GPUをつなぐのは誰か: Enfabrica ACF-S、ConnectX、leaf-spineスイッチASICから理解するAIDCネットワーク
#
Enfabrica ACF-S、ConnectX、leaf-spineスイッチASICから理解するAIDCネットワーク
#AIデータセンター、いわゆるAIDCの性能は、GPU単体の演算能力だけでは決まらない。
#巨大なAIモデルを学習・推論する際、数百から数万基のGPUやASICが頻繁にデータを交換する。GPUが高速でも、別のGPUから計算結果が届かなければ処理は止まる。HBMに必要なデータがなく、ネットワークや外部メモリからの転送を待つ時間が増えれば、高価なGPUは待機状態になる。
#そこで重要になるのが、NVLink、ConnectX、Spectrum-X、Quantum-X、Ethernet、InfiniBand、そしてEnfabrica ACF-Sのようなネットワーク技術である。
#ただし、これらはすべて同じ場所で競合する製品ではない。
#AIDCネットワークは、主に次の三つの階層に分けると理解しやすい。
#- GPUやASICを近距離で結ぶ「scale-up」
- サーバーやラックを大量に結ぶ「scale-out」
- GPU、メモリ、ストレージをネットワークへ接続する「I/O境界」
Enfabrica ACF-S、ConnectX、leaf-spineスイッチASICの違いは、この三層のどこに配置されるかを見れば明確になる。
##
1.AIDCネットワークの基本構造
#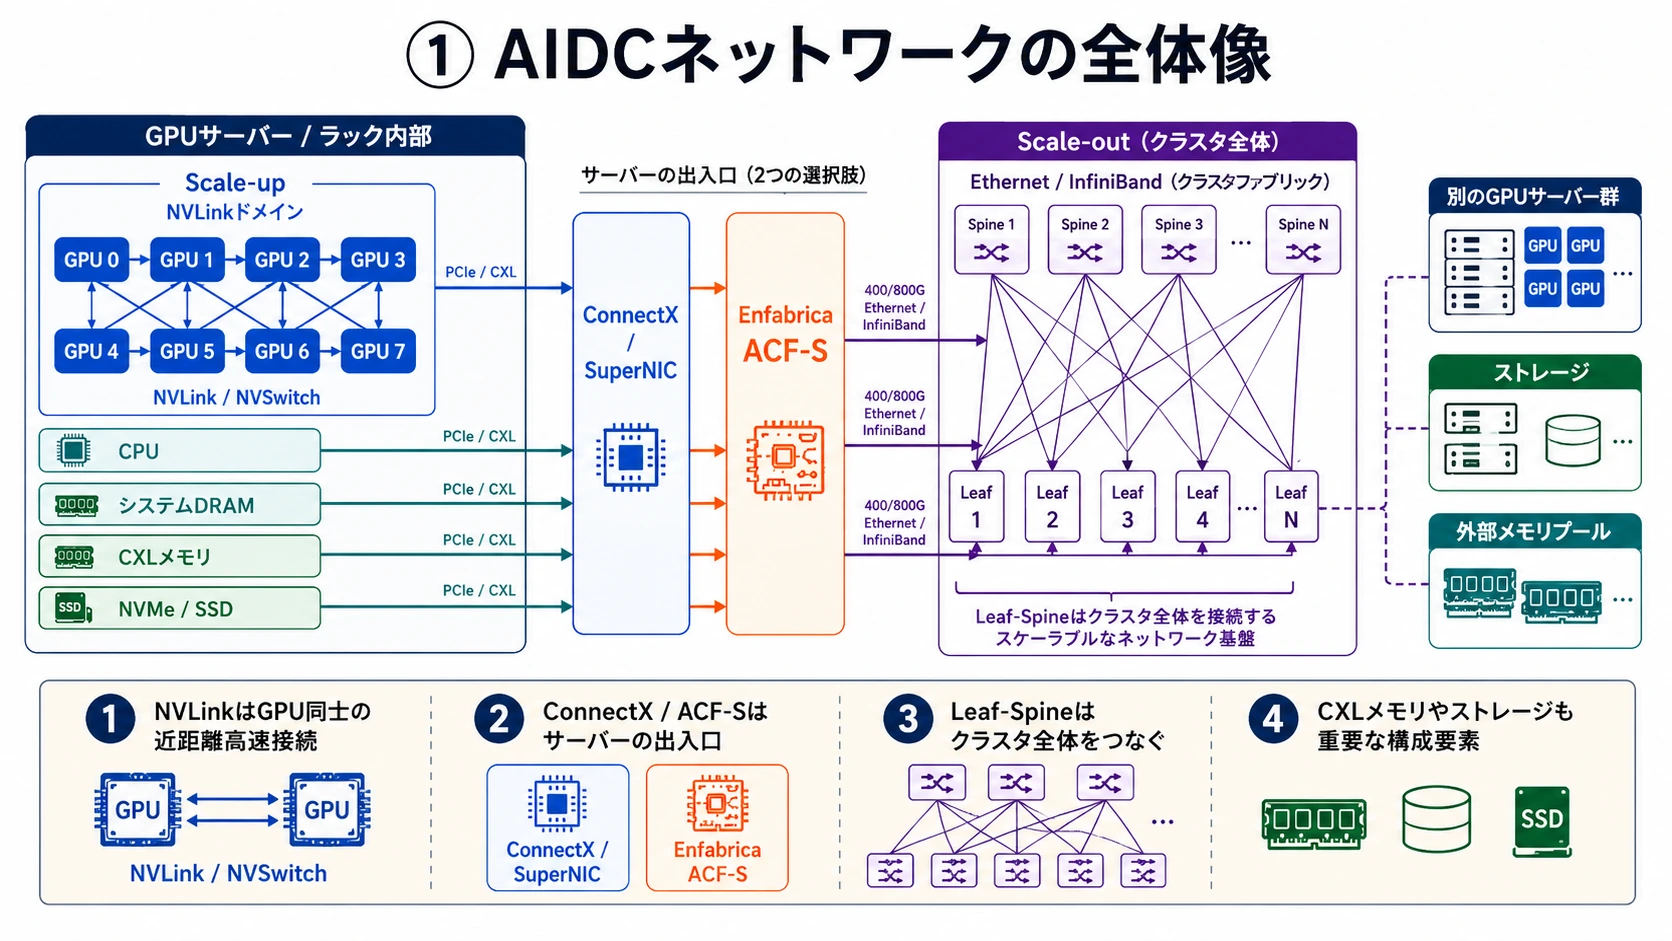
典型的なGPUクラスタは、概念的には次のような階層を持つ。
#**GPU/ASIC
↓
NVLinkや専用インターコネクト
↓
GPUサーバーまたはラック
↓
NIC/SuperNIC
↓
Leafスイッチ
↓
Spineスイッチ
↓
別のラック、ストレージ、外部メモリ**最も内側にあるのが、GPU間を密結合するscale-upネットワークである。
#その外側に、サーバーからEthernetやInfiniBandへ出るためのNICまたはSuperNICがある。さらにネットワークの中央には、leafスイッチとspineスイッチが置かれる。
#ここで重要なのは、NICとスイッチの違いである。
#NICは、GPUサーバーをネットワークへ参加させる「出入口」である。GPUメモリからデータを読み出し、RDMAパケットへ変換し、ネットワークへ送信する。
#一方、leafやspineに搭載されるスイッチASICは、複数のNICから届いたパケットを、適切な出力ポートへ振り分ける「交差点」である。
#Enfabrica ACF-Sは、この出入口側を通常のNICより大きく拡張し、複数GPU、CXLメモリ、ストレージ、複数Ethernetポートをまとめて扱うことを狙った製品である。ACF-Sは3.2Tbpsのネットワーク帯域、複数の800GbE接続、PCIe Gen5、CXL 2.0以降のインターフェースを統合するMulti-GPU SuperNICとして説明されている。(enfabrica.net)
##
2.GPU間接続とscale-upネットワーク
#NVLinkとNVSwitch
#NVLinkは、NVIDIA GPU同士を低遅延かつ高帯域で接続する専用インターコネクトである。
#通常のPCIeは、CPU、GPU、NIC、SSDなどを汎用的に接続する規格である。一方のNVLinkは、GPU同士の大量通信を前提に設計されている。
#複数GPUで一つのモデルを分割するTensor Parallelや、MoEのExpert Parallelでは、GPUが演算するたびに別GPUとの通信が発生する。この領域では、単にピーク帯域が高いだけでなく、通信遅延、全対全通信、集団演算の効率が重要になる。
#NVSwitchはNVLinkの中央に入るスイッチであり、GPU同士を非ブロッキングに近い形で接続する。NVIDIAはNVLinkとNVLink Switchを、AI学習・推論やラックスケール処理向けのscale-upファブリックと位置付けている。(NVIDIA)
#例えばNVL72では、72基のGPUをNVSwitchで接続し、一つの巨大なNVLinkドメインとして利用する。
#ここで通信が完結する限り、EthernetやInfiniBandを経由する必要はない。
#しかし、72基を超えて別ラックへ出る場合には、ConnectXやACF-Sのようなネットワークインターフェースを経由し、scale-outネットワークへ移る。
##
ASIC間接続とNVLink Fusion
#AIアクセラレーターはNVIDIA GPUだけではない。AWS Trainium、Google TPU、Microsoft MaiaなどのカスタムASICも存在する。
#こうしたASICを密結合するには、各社独自のインターコネクトを使用する方法と、汎用EthernetやInfiniBandを使用する方法がある。
#NVIDIAはNVLink Fusionによって、他社のCPUやカスタムASICをNVLinkベースのラックスケール構成へ参加させる方針を示している。これはNVLinkをNVIDIA GPU専用の接続から、半カスタムAIシステムのscale-up基盤へ広げる試みである。(NVIDIA)
#つまりASIC間接続でも、通信密度が高い範囲はNVLinkのようなscale-up技術、ラックやクラスタを越える範囲はEthernetやInfiniBandという分業が基本になる。
##
3.3DトーラスとBoardflyは何が違うのか
#3DトーラスとBoardflyは、EthernetやInfiniBandのような通信規格ではない。
#これらは、アクセラレーターをどの形に並べて接続するかというネットワーク・トポロジーである。
#3Dトーラス
#3Dトーラスでは、アクセラレーターをX、Y、Zの三方向に並べ、各チップを近隣チップへ接続する。
#端のチップは反対側の端へ折り返して接続されるため、各方向が輪になる。
#3Dトーラスは規則性が高く、隣接チップ間の大量通信に強い。一方、離れたチップ同士では複数の中継点を通るため、クラスタが大きくなるほどホップ数が増える。
#GoogleのTPU 8tは、大規模学習向けに3Dトーラスを採用している。Googleの説明では、3Dトーラスは高密度な学習処理には効率的だが、全対全通信では遠距離のホップ数が増える。(Google Cloud)
#Boardfly
#BoardflyはGoogleがTPU 8iで採用した階層型トポロジーである。
#まず少数のTPUをボード内で密に接続し、複数のボードをグループ化する。さらに複数グループを光回路スイッチなどで接続する。
#GoogleはTPU 8iで最大1,152チップを接続できる高radix構造を採用し、1,024チップ規模で最大経路を3Dトーラスの16ホップから7ホップへ短縮したと説明している。通信集約型ワークロードでは、最大50%の通信レイテンシ改善を掲げている。(Google Cloud)
#3Dトーラスが「近隣のチップを順番に渡る格子状ネットワーク」だとすれば、Boardflyは「局所的な密結合グループに遠距離の近道を追加した階層型ネットワーク」である。
#特にMoEでは、トークンが離れたExpertへ送られるため、隣接通信より全対全通信が重要になる。Boardflyは、この推論時代の通信特性へ合わせた構造といえる。
##
4.ラック間を結ぶleaf-spineネットワーク
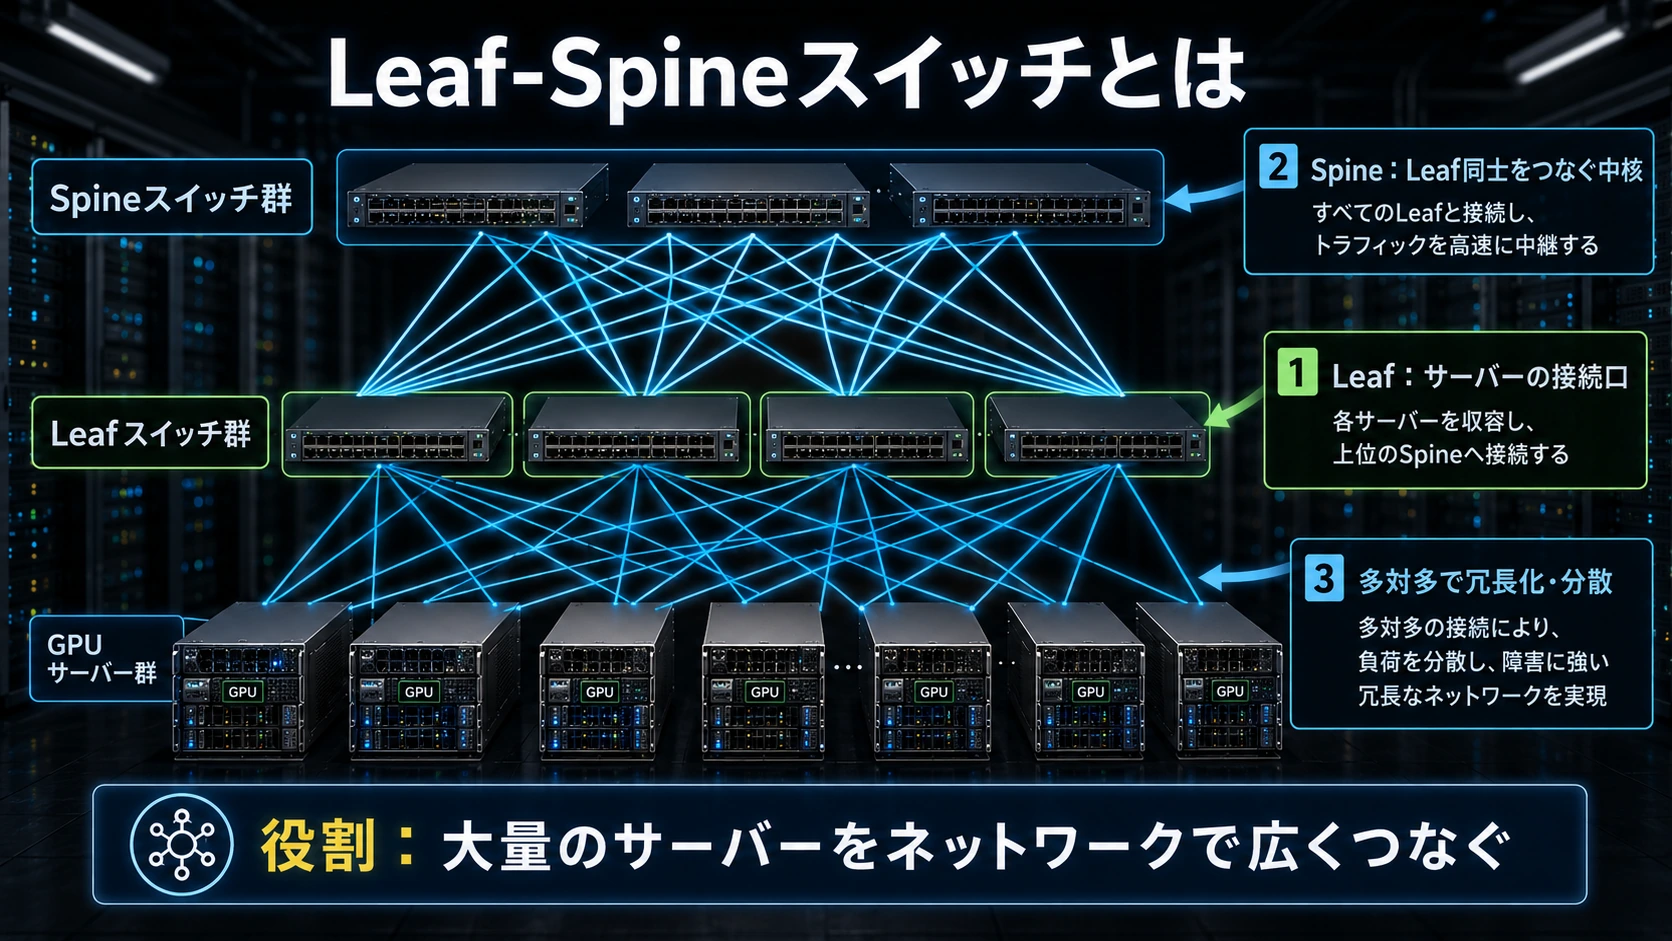
#NVLinkドメインの外へ出た通信は、通常、leaf-spineネットワークを通る。
#Leafは、GPUサーバー、ストレージ、CPUサーバーなどの接続を受け持つスイッチである。
#Spineは複数のleafを相互接続する上位スイッチである。
#基本的には、各leafがすべてのspineへ接続される。
#**GPUサーバー
↓
Leaf A
↓
Spine 1/2/3/4
↓
Leaf B
↓
別のGPUサーバー**この構造では、Leaf AからLeaf Bへの経路が複数存在する。特定のspineやリンクが混雑・故障しても、別経路を使用できる。
#BroadcomのTomahawkやNVIDIA Spectrumは、このleafやspineの中に搭載されるスイッチASICである。
#例えばBroadcom Tomahawk 6は、1チップで102.4Tbpsのスイッチ容量を持ち、最大512ポート相当の200GbE接続をサポートする。これは多数のサーバーやNICから届く通信を集約し、高速に転送するための製品である。(broadcom.com)
#スイッチASICはGPUメモリから直接データを読み出す装置ではない。
#主な仕事は、
#- パケットの宛先判定
- 入出力ポートの選択
- ECMPなどによる経路分散
- バッファリング
- 輻輳管理
- テレメトリー
- 障害経路の回避
である。
##
5.EthernetとInfiniBandの違い
#Ethernet
#Ethernetは、データセンター、企業ネットワーク、インターネットで広く使用される標準規格である。
#多数のベンダーがNIC、スイッチ、光トランシーバー、ネットワークOSを提供しており、選択肢が多い。既存のクラウド運用やIPネットワークと統合しやすいことも大きな利点である。
#一方、一般的なEthernetは、AIクラスタ特有の同期的な大量通信を前提に作られたわけではない。
#多数のGPUが同時に一つの宛先へ通信するincastや、短時間に大量のデータが流れるmicroburstが起こると、パケット損失や輻輳によってGPUの待機時間が増える。
#そこでRoCEによるRDMA、ECN、PFC、適応型ルーティング、テレメトリー連動型輻輳制御などを組み合わせ、EthernetをAI向けに最適化する動きが進んでいる。Ethernet Allianceも、AIデータセンターの拡大が800GbE、1.6TbE、その先の高速化を推進しているとしている。(ethernetalliance.org)
#InfiniBand
#InfiniBandは、HPCやスーパーコンピューター向けに発展した低遅延のスイッチド・ファブリックである。
#RDMAを中心に設計され、ホストCPUを経由せずにサーバーやGPUのメモリ間でデータを移動できる。
#また、NVIDIA Quantumシリーズでは、適応型ルーティング、輻輳制御、SHARPによるIn-Network Computingなどが統合されている。
#SHARPでは、All-Reduceなどの集団演算の一部をスイッチ側で処理できる。各GPUが同じ集約結果を何度も送受信するのではなく、ネットワーク内で演算を集約することで、通信量と処理時間を削減する。
#Quantum-X800は、1ポート800Gbps、144ポートを備え、SHARP v4、適応型ルーティング、テレメトリー型輻輳制御などを統合したInfiniBandプラットフォームである。(NVIDIA)
#どちらが優れているのか
#InfiniBandは、低遅延、集団通信、性能予測性を優先する大規模学習クラスタで強い。
#Ethernetは、ベンダー選択、標準性、既存クラウドとの統合、運用人材、コスト面で優位性を持つ。
#現在は「InfiniBandかEthernetか」という単純な二択ではなく、
#- 最大性能と予測性を求めるクラスタはInfiniBand
- 開放性とクラウド統合を重視するクラスタはAI最適化Ethernet
- ストレージ、管理、フロントエンドは一般Ethernet
という使い分けが多い。
##
6.Spectrum-XとQuantum-X
#Spectrum-X
#Spectrum-Xは単独のスイッチ製品名ではない。
#NVIDIAのSpectrumスイッチ、SuperNIC、輻輳制御、テレメトリー、ネットワークソフトウェアを組み合わせた、AI向けEthernetプラットフォームである。
#通常のEthernet製品を個別に組み合わせるのではなく、サーバー側のSuperNICとスイッチ側を協調動作させる。
#NVIDIAはSpectrum-Xについて、標準EthernetとオープンなSONiCなどを利用しながら、AIクラスタ向けにエンドツーエンドで最適化したプラットフォームと説明している。複数の独立したネットワーク面を使用するmultiplane構成では、二層ネットワークで最大12万8,000GPUまで拡張する設計を示している。(NVIDIA)
#Quantum-X
#Quantum-Xは、InfiniBandを基盤にしたNVIDIAの大規模AI・HPCネットワークである。
#Quantum-X800スイッチ、ConnectX SuperNIC/HCA、ケーブル、光接続、UFM管理ソフトウェアなどで構成される。
#Spectrum-Xが「AI向けに最適化したEthernet」なら、Quantum-Xは「AI・HPC向けに設計されたInfiniBandのフルスタック」と考えればよい。
##
7.ConnectXとは何か
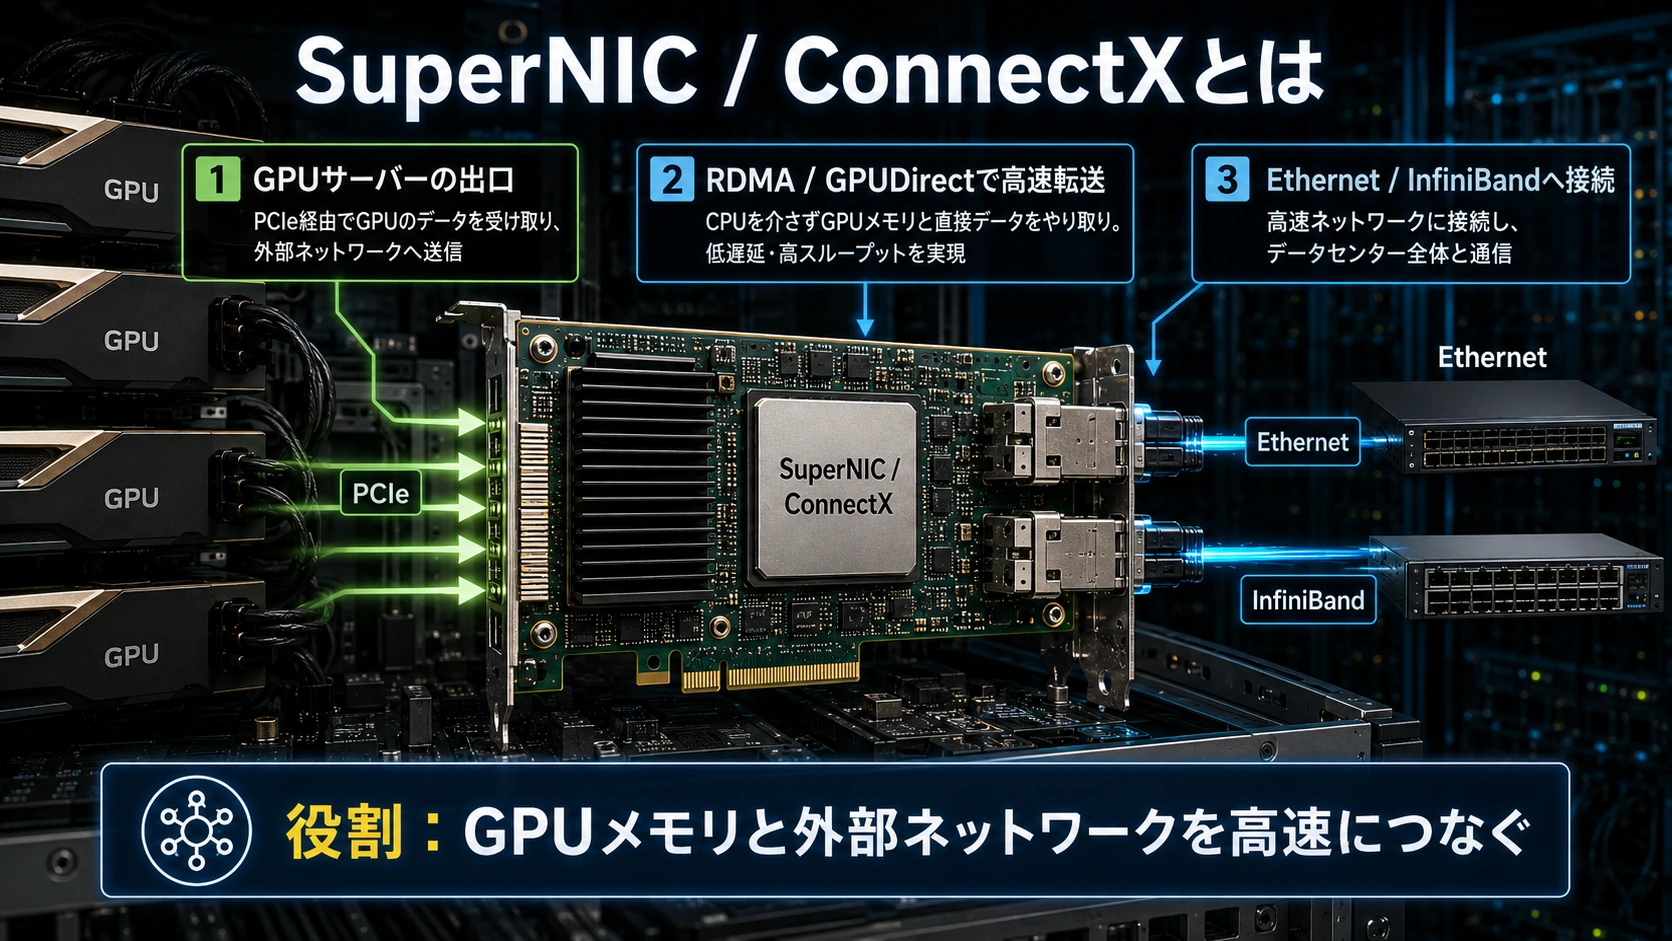
#ConnectXは、もともとMellanoxが開発してきたNIC/HCA製品群であり、NVIDIAがMellanoxを買収したことでNVIDIAのネットワーク製品となった。
#ConnectXはGPUサーバーのPCIe側に接続され、EthernetまたはInfiniBandへ通信を送り出す。
#GPUDirect RDMAを利用すると、CPUメモリへ一度コピーすることなく、GPUメモリとネットワークの間でデータを直接転送できる。
#基本的な位置は次の通りである。
#**GPU
↓ PCIe
ConnectX
↓ Ethernet/InfiniBand
Leafスイッチ**ConnectX-8は800GbpsのEthernetとInfiniBandに対応し、PCIe Gen6対応スイッチ機能も統合している。従来必要だった独立PCIeスイッチを削減し、GPUとNIC間の接続を簡素化する方向へ進んでいる。(NVIDIA Docs)
#このため、ACF-SとConnectXの機能範囲は完全に別ではなく、徐々に重なってきている。
##
8.Enfabrica ACF-SとConnectXの違い
#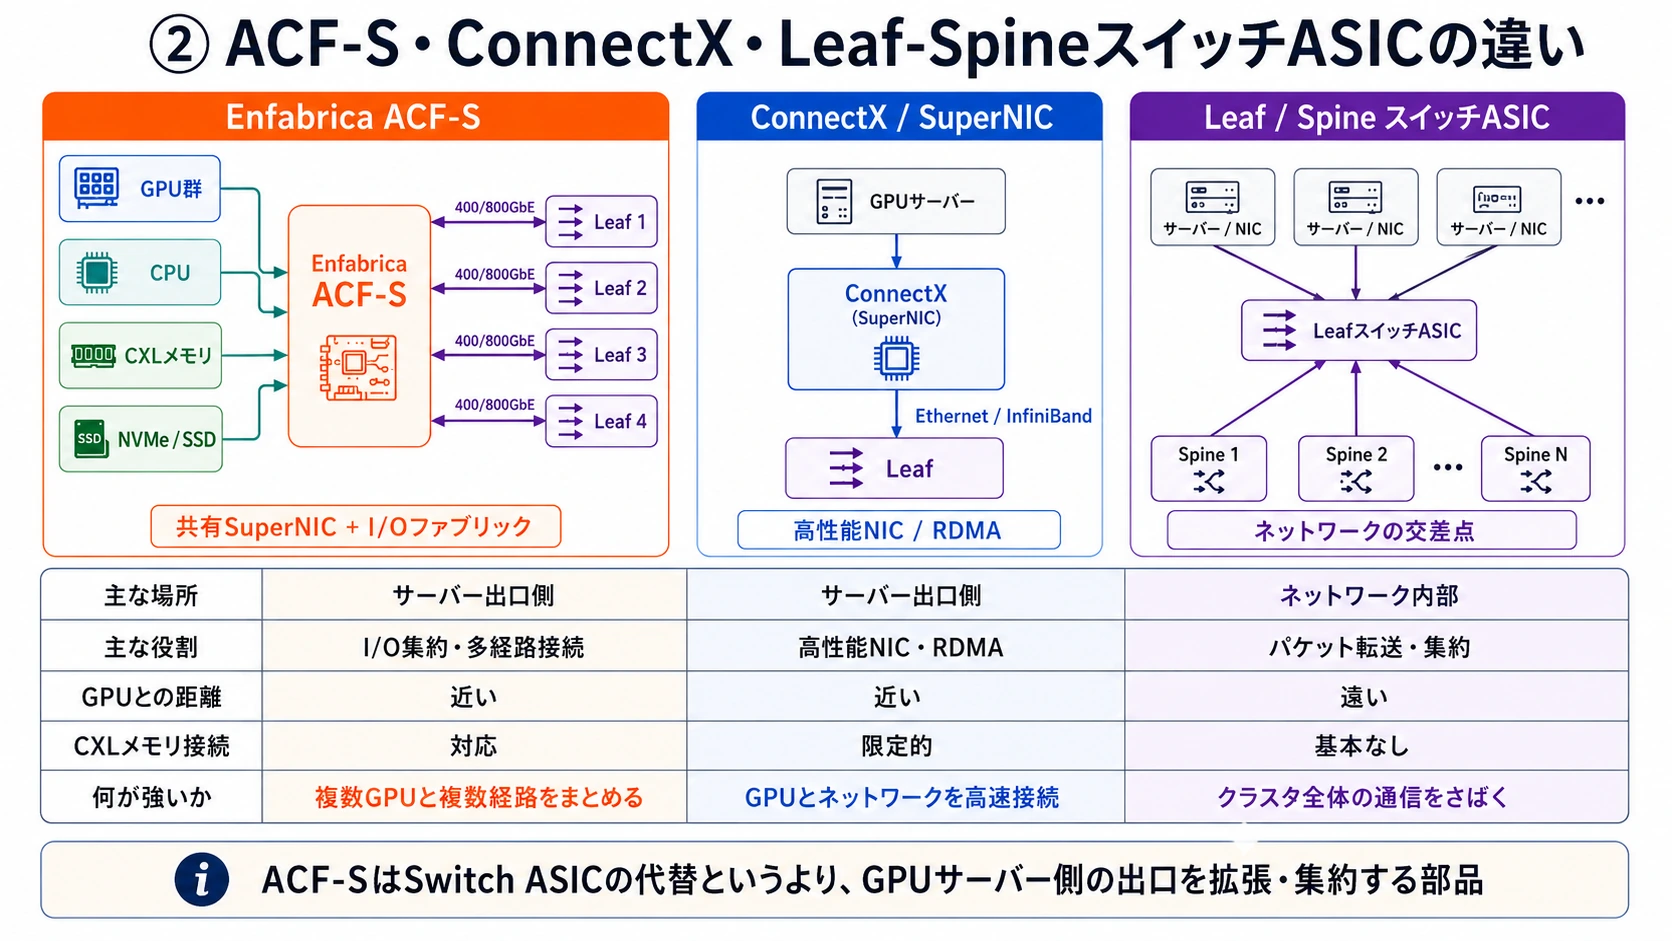
ACF-SもConnectXも、GPUサーバーと外部ネットワークの境界に置かれる。
#最大の違いは、設計の出発点である。
#ConnectX
#
ConnectXの中心は、高性能なNIC/HCAである。
#- GPUメモリとのGPUDirect RDMA
- EthernetとInfiniBand
- RoCE
- 輻輳制御
- 仮想化
- セキュリティ
- 通信オフロード
を提供する。
#複数のGPUを接続できる構成も増えているが、基本的にはネットワーク・エンドポイントとして発展してきた。
#ACF-S
#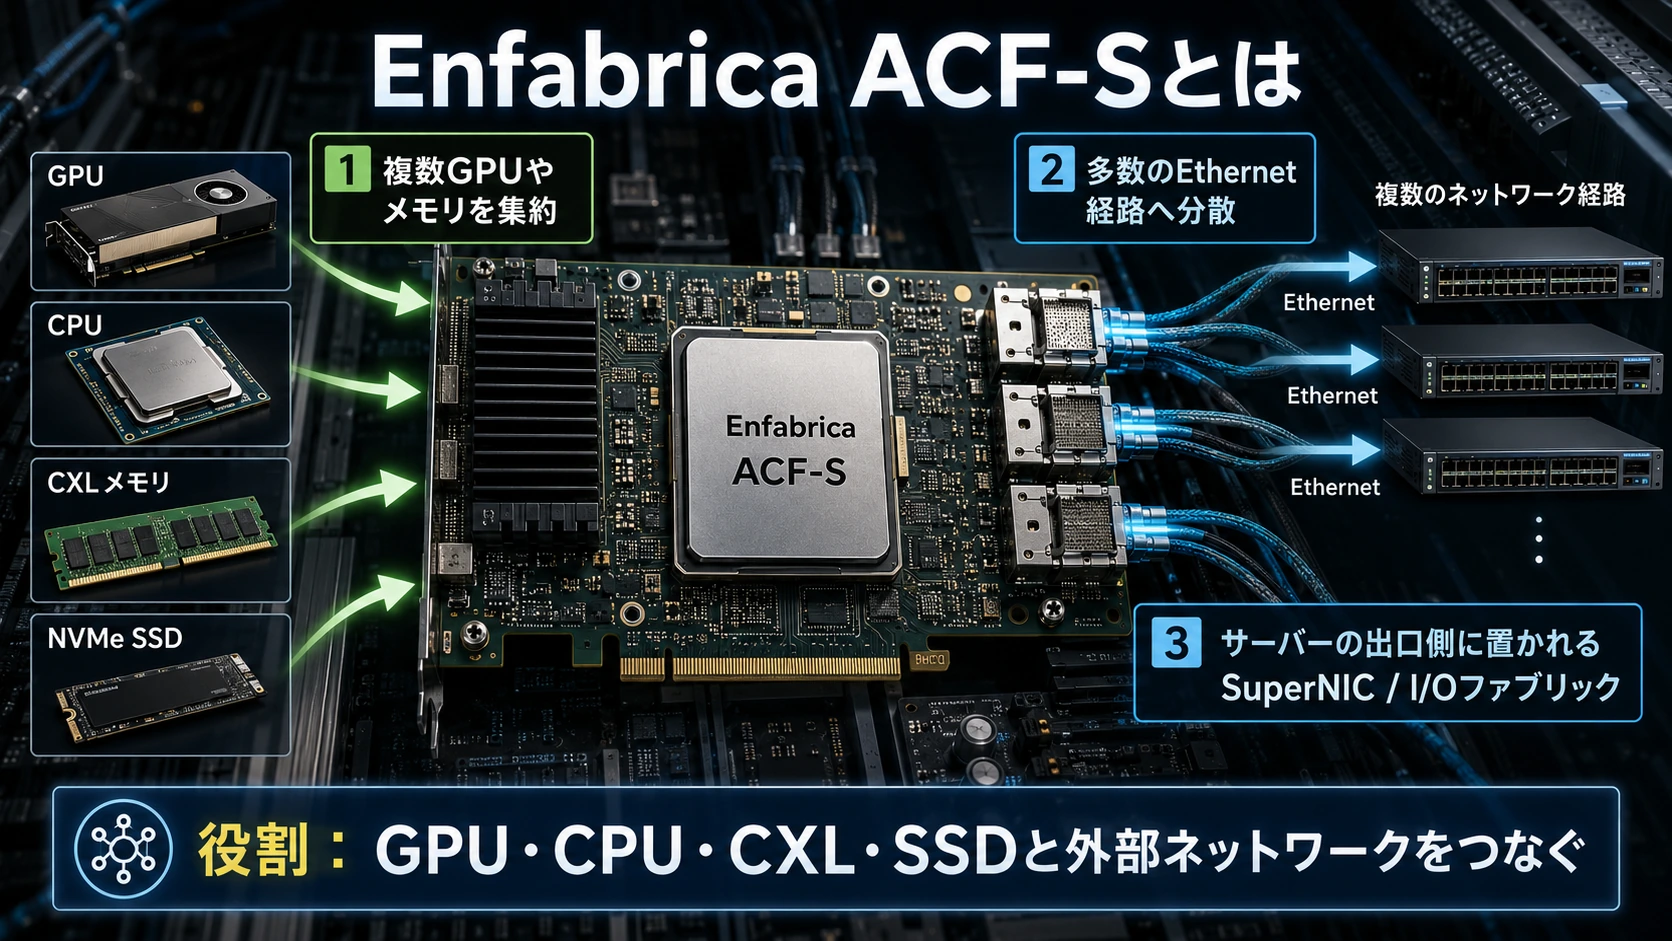
ACF-Sは、最初から複数のGPU、CPU、アクセラレーターASIC、CXLメモリ、NVMe、複数EthernetポートをまとめるI/Oファブリックとして設計された。
#イメージとしては、
#**GPU 1
GPU 2
GPU 3
GPU 4
CPU
CXLメモリ
NVMe
↓
ACF-S
↓
複数の400/800GbE経路
↓
複数のLeaf**となる。
#EnfabricaはACF-Sを「複数GPUが共同で利用する8倍幅のNIC」に近いものとして位置付け、GPUごとにNICとPCIeスイッチを固定的に割り当てる構造を減らそうとしている。RDMAのデータパスをACF-Sシリコンで処理し、制御部分をソフトウェア化することで、GPU、CXLメモリ、NVMe間のゼロコピー転送や柔軟な経路制御を狙っている。(enfabrica.net)
#違いを表にすると
#| 項目 | Enfabrica ACF-S | ConnectX |
|---|---|---|
| 基本分類 | Multi-GPU SuperNIC/I/Oファブリック | 高性能NIC/HCA/SuperNIC |
| 主な場所 | GPUサーバーのI/O集約点 | GPUサーバーのネットワーク出口 |
| GPU接続 | 複数GPUを共同接続する設計 | GPU/ノード単位を中心に発展 |
| 外向き接続 | 複数Ethernet経路を共有 | EthernetまたはInfiniBand |
| PCIeスイッチ | 中核機能として統合 | ConnectX-8から統合を強化 |
| CXLメモリ | 重要な差別化要素 | 主用途ではない |
| RDMA | 対応 | 成熟した中核機能 |
| 強み | I/O集約、メモリ階層、多経路化 | CUDA、GPUDirect、NCCLとの成熟した統合 |
ACF-Sは「ConnectXより速いNIC」というだけではない。
#複数GPUが複数のネットワーク出口を共同利用し、さらにCXLメモリやストレージまで同じファブリックへ接続する点が本質である。
#ただしConnectX-8がPCIeスイッチを統合したことで、両者の境界は以前より曖昧になっている。
##
9.ACF-Sとleaf-spineスイッチASICの違い
#
ACF-SとTomahawkやSpectrumのようなスイッチASICは、設置場所が異なる。
#ACF-S
#- GPUサーバー側に置かれる
- PCIe/CXLデバイスを接続する
- GPUメモリへのDMAを処理する
- RDMAの送受信端点になる
- 複数Ethernetリンクへ通信を分散する
Leaf/SpineスイッチASIC
#- ネットワークの中央に置かれる
- 多数のNICやSuperNICからパケットを受け取る
- 宛先ポートへパケットを転送する
- 輻輳管理、バッファリング、ルーティングを行う
- GPUメモリを直接管理しない
簡単に表現すると、
#ACF-Sは多数のGPUが共同利用する巨大な玄関であり、leaf-spineスイッチASICは多数の玄関を結ぶ高速道路の交差点である。#
両者は基本的に補完関係である。
#ACF-Sの外側に、TomahawkやSpectrumを搭載したleaf-spine網を配置することができる。
##
10.Enfabricaの歴史
#Enfabricaは2020年に始まった米国のファブレス半導体企業である。
#Broadcom、Google、Cisco、AWS、Intelなどで半導体やネットワークを開発してきたRochan Sankar、Shrijeet Mukherjeeらが中心となり、Sutter Hill Venturesの支援を受けて設立された。(enfabrica)
#2023年3月にステルス状態から登場し、Accelerated Compute Fabricという構想を発表した。
#同年9月には1億2,500万ドルのシリーズBを調達した。NVIDIAも戦略投資家として参加し、資金はACF-Sの量産と研究開発に投入された。(enfabrica)
#2024年11月にはさらに1億1,500万ドルのシリーズCを調達し、3.2TbpsのACF SuperNICとパイロットシステムを2025年第1四半期から提供すると発表した。(businesswire.com)
#2025年7月には、ACF-SとCXL接続DDR5を組み合わせたEMFASYSを発表した。
#EMFASYSは、最大18TB、将来的には28TBのCXL DDR5メモリを、400/800GbE RDMAネットワーク経由で複数GPUサーバーから利用するメモリシステムである。HBMを置き換えるのではなく、KVキャッシュ、推論コンテキスト、チェックポイントなどを外部DDR5へ逃がすメモリ階層として設計されている。(enfabrica.net)
#同年7月時点で、Enfabricaは3社の大手AIクラウド顧客が同社の技術を利用しているとReutersに説明した。ただし、顧客名、導入台数、本番利用と評価利用の内訳は公開されていない。累計調達額は約2億6,000万ドルと報じられた。(Reuters)
#2025年9月には、NVIDIAがEnfabricaのCEO Rochan Sankarと複数の技術者を採用し、同社技術のライセンスを取得するため、9億ドル超を支払ったと報じられた。
#これはEnfabrica全社の通常買収ではなく、人材採用と技術ライセンスを組み合わせた取引とされている。取引のライセンス範囲、排他性、ロイヤルティーの有無は公開されていない。(Reuters)
##
11.Enfabricaの収益モデル
#Enfabricaは、ARMのようにIPだけをライセンスする純粋なIP企業として始まったわけではない。
#本来の事業モデルは、次の四つに分けられる。
#① ACF-Sシリコンの販売
#自社でACF-Sのアーキテクチャ、論理回路、物理設計、ファームウェア、ドライバーを開発し、ファウンドリーへ製造を委託する。
#完成したチップ、カード、パイロットシステムをクラウド事業者、サーバーODM、OEMへ販売するファブレス型である。
#基本売上は、
#チップ単価 × 出荷個数
#となる。
#② EMFASYSのシステム販売
#EMFASYSでは、ACF-S、CXLメモリコントローラー、DDR5、基板、シャーシ、電源、制御ソフトウェアをまとめて提供する。
#チップ単体より売上規模を大きくできる一方、DDR5やシャーシなど他社部品の割合が増えるため、半導体単体より粗利益率が低くなる可能性がある。
#③ ソフトウェア、保守、統合支援
#ACF-Sはドライバー、RDMA制御、メモリ階層管理、テレメトリー、AIフレームワークとの統合を必要とする。
#ソフトウェア単独のSaaSではなく、ハードウェア価格、年間保守、導入支援、顧客別カスタマイズに含める形が中心と考えられる。
#④ IP・技術ライセンス
#NVIDIAとの取引によって、Enfabricaは大規模な技術ライセンス収益を得るモデルも持つことになった。
#ただしこれは、もともとの通常販売モデルではなく、戦略的な特殊取引である。
#今後NVIDIAから継続的なロイヤルティーが支払われるのか、一括ライセンスなのかは公開されていない。
##
12.現在の規模
#Enfabricaは、BroadcomやNVIDIAのように年間数千万個のチップを出荷する段階にはない。
#公開情報から確認できるのは、
#- 累計約2億6,000万ドルの資金調達
- 2025年第1四半期からACF-Sとパイロットシステムを提供
- 2025年7月時点で大手AIクラウド顧客3社が利用
- EMFASYSの初期商用化
- NVIDIAによる人材獲得と技術ライセンス
までである。(businesswire.com)
#顧客名、売上高、出荷個数、継続受注、粗利益率、従業員数の詳細は公開されていない。
#したがって現在のEnfabricaは、
#技術実証と顧客評価を終え、一部商用導入へ入った段階で、NVIDIAが主要人材と技術を囲い込んだ企業#
と位置付けるのが妥当である。
##
13.Enfabricaの将来性
#
Enfabricaの技術が狙う問題は、今後さらに大きくなる。
#AIクラスタが数千GPUから数万、数十万GPUへ拡大すると、GPUの演算性能より、
#- NIC帯域
- PCIeスイッチの段数
- leaf-spineの混雑
- リンク障害
- HBM容量
- KVキャッシュ
- メモリコピー
- ネットワークの再送
がシステム性能を制限する。
#ACF-Sのように、複数GPU、複数ネットワーク経路、CXLメモリを一つのI/Oファブリックへ統合する考え方は、この方向と合致する。
#特に将来性があるのは、巨大モデル推論である。
#推論では、ユーザー数、コンテキスト長、KVキャッシュが増えるほどメモリ容量が必要になる。すべてを高価なHBMへ置くことは難しく、HBM、DDR5、SSDを階層化する必要がある。
#Enfabricaは、ACF-SとEMFASYSを通じて、このHBMの外側のメモリ階層を握ろうとしている。
#一方でリスクも大きい。
#第一に、ConnectX-8がPCIeスイッチを統合し、Spectrum-Xがmultiplane構成を強化したことで、NVIDIA自身の製品がACF-Sの機能へ近づいている。(NVIDIA)
#第二に、Enfabricaの主要人材がNVIDIAへ移ったため、独立企業としての研究開発力と販売力がどこまで残るか不透明である。
#第三に、CXL DDR5はHBMより大幅に遅い。ワークロード、キャッシュ制御、プリフェッチが適切でなければ、外部メモリを増やしても性能が低下する。
#第四に、AIネットワーク市場にはNVIDIA、Broadcom、AMD、Marvell、Ciscoなど強力な企業が存在する。顧客はハードウェア単体ではなく、CUDA、NCCL、スイッチ、ケーブル、監視ソフトウェアまで含む完成したエコシステムを重視する。
#そのためEnfabricaの価値は、独立したACF-Sチップの販売台数だけで測るべきではない。
#複数GPUでネットワーク帯域を共有する思想、PCIe・CXL・RDMAを統合する設計、外部メモリをAIクラスタへ組み込む技術が、NVIDIAの次世代SuperNICやメモリファブリックへ吸収されること#
も重要な成功経路になる。
##
結論
#AIDCネットワークで最も重要なのは、製品名ではなく「どの階層を担当しているか」である。
#- NVLink/NVSwitch
GPUやASICを密結合するscale-upネットワーク
#- 3Dトーラス/Boardfly
アクセラレーターをどう並べて接続するかというトポロジー
#- ConnectX
GPUサーバーをEthernetまたはInfiniBandへ接続する高性能NIC/SuperNIC
#- Enfabrica ACF-S
複数GPU、CXLメモリ、ストレージ、複数Ethernet経路をまとめる共有SuperNIC/I/Oファブリック
#- Spectrum-X
SuperNIC、Spectrumスイッチ、制御ソフトウェアを組み合わせたAI向けEthernetプラットフォーム
#- Quantum-X
Quantumスイッチ、ConnectX、SHARPなどで構成されるAI・HPC向けInfiniBandプラットフォーム
#- Tomahawk/SpectrumなどのスイッチASIC
leafやspine内部でパケットを高速転送するネットワークの交差点
#Enfabrica ACF-Sは、NVLinkやleaf-spineスイッチを置き換える技術ではない。
#NVLinkドメインの外側で、GPU群から多数のEthernet経路、CXLメモリ、ストレージへ出る部分を再設計する技術である。
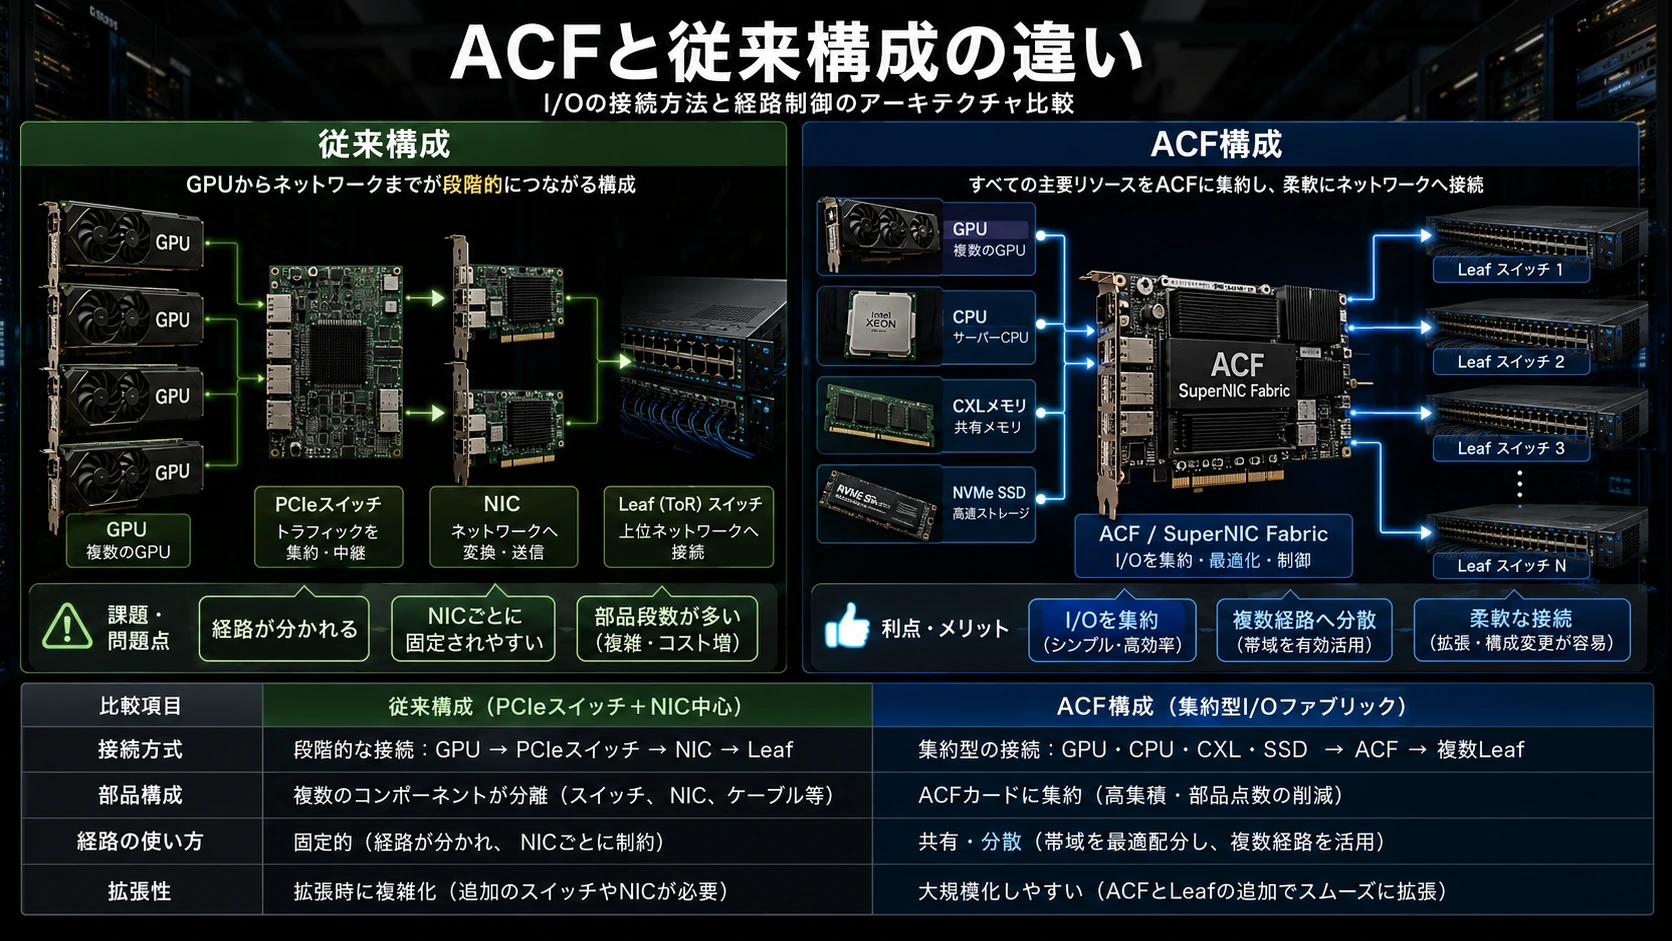
#従来のAIDCが「GPUごとにNICを割り当て、NICをleafへ接続する」構造だったとすれば、Enfabricaは、
#複数のGPUと複数の出口を一つの共有ファブリックとして扱う#
構造を提案した。
#AIクラスタが巨大化し、ラックそのものの製造難易度が上昇するほど、一つのラックへGPUを詰め込むだけではなく、量産可能な複数ラックをネットワークとメモリ階層で効率よく結ぶ技術が重要になる。
#Enfabricaの将来性は、単なるNIC市場のシェアではなく、GPU、ネットワーク、CXLメモリ、ストレージの境界をどこまで一つのファブリックへ融合できるかにかかっている。
#Enfabricaの主要人材はなぜNVIDIAへ移ったのか
#9億ドル超の「買収なき買収」が示すAIネットワーク争奪戦
#Enfabricaを語るうえで、2025年9月に起きた主要人材のNVIDIA移籍は避けて通れない。
#報道によると、NVIDIAはEnfabricaの共同創業者兼CEOだったRochan Sankarと複数の社員を採用し、同社の技術を利用するライセンスを取得した。対価は現金と株式を合わせて9億ドルを超え、契約成立時点でSankarはすでにNVIDIAへ移っていたという。ただし、NVIDIAもEnfabricaも、移籍人数、ライセンスの範囲、支払額の内訳を詳細には公表していない。
#重要なのは、これがEnfabricaの株式を丸ごと取得する通常の企業買収ではなかったことである。
#NVIDIAが手に入れたのは、法人全体ではなく、AIネットワークを設計できるチームと、そのチームが作った中核技術を使用する権利だった。
##
通常の買収とは何が違うのか
#通常の企業買収では、買い手は対象企業の株式、従業員、知的財産、顧客契約、製品在庫、負債までまとめて引き継ぐ。
#今回の取引は、概念的には次のような構造である。
#通常の買収
#Enfabrica法人 → 従業員 → 特許・設計資産 → ACF-S・EMFASYS → 顧客契約 → 負債・運営組織 → すべてNVIDIAへ統合
#今回の取引
#Enfabrica → CEOと一部の主要人材はNVIDIAへ移籍 → NVIDIAは中核技術のライセンスを取得 → Enfabrica法人や残存資産は直ちには消滅しない
#このように、優秀な人材を雇用し、技術の利用権を得ながら、対象企業そのものは完全には買収しない取引は、一般に「アクハイヤー」や「買収なき買収」に近い形とみなされる。
#NVIDIAは後にGroqに対しても、技術ライセンスと主要経営人材の採用を組み合わせた類似の取引を行っており、有力なAIスタートアップから技術とチームを迅速に取り込む手法として定着しつつある。
##
NVIDIAは何に9億ドル超を払ったのか
#Enfabricaは取引直前まで、大量の売上を持つ成熟企業ではなかった。
#2025年7月時点で、同社は累計約2億6,000万ドルを調達し、ACF-Sを利用する大手AIクラウド顧客が3社あると説明していた。しかし、顧客名、出荷個数、売上高は公表されておらず、事業段階としてはまだ初期商用化に近かった。
#それにもかかわらず、NVIDIAが9億ドルを超える対価を支払ったとすれば、評価対象は現在の売上より、次の三つだった可能性が高い。
#1.ACF-Sの設計思想
#ACF-Sは一般的なNICのように、単一のサーバーを一本または数本のネットワーク回線へ接続するだけではない。
#複数のGPU、CPU、CXLメモリ、NVMeストレージを集約し、複数のEthernet経路へ分散する、SuperNICとPCIe/CXLファブリックを融合した構造である。
#つまりNVIDIAは、完成したチップだけでなく、
#複数GPUと複数ネットワーク出口を一つの共有I/O資源として扱う設計思想#
を取得したと考えられる。
#Enfabricaは、ACF-SをAIクラスタのI/Oボトルネックを解消し、大規模なアクセラレーテッド・コンピューティングを支える基盤技術として位置付けていた。
#2.シリコンとソフトウェアを一体設計できる人材
#AIネットワークでは、スイッチASICやNICの回路だけを設計しても十分ではない。
#必要になるのは、
#- PCIeとCXLの接続設計
- RDMAデータパス
- Linuxドライバー
- ファームウェア
- 輻輳制御
- 通信経路の分散
- GPUメモリへの直接転送
- クラウド顧客への導入支援
を一体で構築できるチームである。
#Rochan SankarはBroadcomでTomahawkやTrident系のEthernetスイッチ事業に関わり、その後EnfabricaでGPUサーバー側のI/Oを再設計した人物である。NVIDIAが求めたのは、一つの特許というより、ネットワークASICを実際のクラウド製品へ仕上げられる組織能力だったと考えられる。
#3.外部メモリ階層の技術
#Enfabricaが2025年7月に発表したEMFASYSは、ACF-Sとソフトウェアを使い、GPUから大容量の外部DDR5メモリへアクセスするシステムだった。
#HBMを完全に置き換えるのではなく、KVキャッシュや長期コンテキストなどを安価なDDR5へ逃がし、HBMの容量と費用を抑えることが目的である。
#AI推論が長文脈化し、同時ユーザー数が増えるほど、問題は演算量だけでなくメモリ容量へ移る。
#NVIDIAにとってEnfabricaは、ネットワーク企業であると同時に、HBMの外側にあるDDR5やストレージをGPUへ接続するメモリ階層企業でもあった。
##
ConnectXを持つNVIDIAが、なぜEnfabricaを必要としたのか
#NVIDIAはすでにConnectX、BlueField、Spectrum-X、Quantum-Xを持っている。
#そのため、一見するとACF-Sは既存製品と重複しているように見える。
#しかし、設計の起点が異なる。
#ConnectXは、GPUサーバーとEthernetまたはInfiniBandを結ぶ高性能NIC/HCAとして発展してきた。ACF-Sは最初から、複数GPU、CXLメモリ、ストレージ、複数ネットワーク経路を一つにまとめるI/Oファブリックとして設計された。
#簡略化すると、次の違いになる。
#ConnectX
#GPUサーバー → ConnectX → Ethernet/InfiniBand → Leafスイッチ
#ACF-S
#複数GPU + CPU + CXLメモリ + NVMe → ACF-S → 複数のEthernet経路 → 複数のLeafスイッチ
#NVIDIAはEnfabricaの技術を、ACF-Sという独立製品としてそのまま販売する必要はない。
#高radix接続、複数GPUによるポート共有、CXL統合、ソフトウェア定義RDMAなどを分解し、将来のConnectX、BlueField、Spectrum-X、メモリファブリックへ組み込むことができる。
##
Kyberの難航で価値が高まる理由
#この人材移籍は、Kyberラックの延期観測が表面化する前から進められていたとみられる。そのため、Kyber問題だけを理由とする取引ではない。
#しかし、結果的にはKyberのような巨大ラックが難航するほど、Enfabricaの設計思想は重要になる。
#Kyberは、多数のGPUを一つの巨大なNVLinkドメインへ収めるscale-up型の構想である。
#一方、Enfabricaが支援するのは、その外側のscale-outである。
#巨大ラックを一台作る構造
#144 GPU規模のラック → 一つの巨大なNVLink領域
#Enfabrica型の迂回構造
#量産可能なNVL72 + NVL72 + NVL72 → 高radixのSuperNIC → Ethernet leaf-spine → クラスタ全体として拡張
#ACF-SはNVLinkと同じ低遅延接続を提供するものではない。しかし、一つのラックを無理に巨大化せず、複数の比較的量産しやすいラックをネットワークで束ねる選択肢を強化する。
#そのためNVIDIAにとってEnfabricaは、Kyberを直接修理する技術ではなく、
#Kyberが予定通り立ち上がらなくても、クラスタ全体を拡張するための保険#
として機能し得る。
##
Enfabrica本体には何が残るのか
#人材と技術がNVIDIAへ移った後も、Enfabricaの公式サイトにはACF-SとEMFASYSが掲載されている。したがって法人や製品資産が即時に消滅したとまでは確認できない。
#一方で、CEOと複数の主要社員が移った以上、独立企業として次世代チップを継続開発し、量産と販売を拡大できるかには大きな不確実性が生じる。
#スタートアップの価値は、特許だけでなく、
#- チップの次世代設計
- 製造上の問題への対応
- 顧客環境への最適化
- ソフトウェア更新
- 販売とサポート
を担う人材に依存する。
#中核チームがNVIDIAへ移れば、Enfabricaが既存顧客へのサポートや知的財産の管理を続けられても、以前と同じ速度で独立製品を開発することは難しくなる。
#したがって今回の取引は、Enfabricaにとって、
#独立した大手ネットワーク半導体企業を目指す道から、技術と人材をNVIDIAへ提供する出口戦略へ転換した出来事#
と見ることができる。
##
競合排除という側面
#Enfabricaが独立して成長していれば、将来的にはNVIDIA GPUだけでなく、
#- AMDのGPU
- GoogleやAWSなどの独自ASIC
- UALink対応アクセラレーター
- CXLメモリ
- Broadcom製Ethernetスイッチ
を横断して接続する中立的なI/Oファブリック企業になった可能性があった。
#これはNVIDIAにとって二重のリスクだった。
#第一に、ACF-SがConnectXやBlueFieldと競合する可能性がある。
#第二に、ACF-SがAMDやカスタムASICのクラスタ効率を高め、NVIDIA以外のアクセラレーターを使いやすくする可能性がある。
#人材と技術を先に囲い込めば、NVIDIAは新しいI/Oアーキテクチャを自社スタックへ取り込める一方、競合が同じ技術チームを利用する可能性を下げられる。
#もっとも、技術ライセンスが排他的だったのか、既存顧客がどこまで利用を継続できるのかは公表されていない。したがって、NVIDIAがEnfabricaの全IPを完全に独占したとまでは断定できない。
##
規制当局から見た「買収なき買収」
#この種の取引は、通常の企業買収より迅速に完了できる可能性がある。
#法人全体を取得しなければ、負債、既存契約、製品部門の統合を避けられる。また、形式上は企業結合ではなく、人材採用とライセンス契約として扱われる余地もある。
#一方、実質的に対象企業のCEO、中核技術者、重要IPを取得するのであれば、競争への影響は通常買収と近くなる。
#NVIDIAによるEnfabrica取引や、その後のGroqとの類似取引は、大手テクノロジー企業がスタートアップを形式的には残しながら、人材と技術を取り込む動きの一例である。Groqとの契約については、同社が独立企業として残りつつ、NVIDIAが技術ライセンスを取得し、CEOらを採用したと報じられている。
#今後、規制当局がこうした取引を単なる採用・ライセンスとして扱うのか、実質的な企業結合として審査するのかも重要になる。
##
最終評価――Enfabricaは失敗したのか
#独立企業として見ると、主要人材の流出は大きな打撃である。
#ACF-SやEMFASYSが独立ブランドとして広く量産される未来は、取引前より不透明になった。
#しかし技術スタートアップとして見ると、Enfabricaは大きな成果を上げたともいえる。
#2019~2020年ごろに始まった企業が、GPUクラスタのI/O構造を再設計し、大手AIクラウド顧客を獲得し、最終的にNVIDIAが9億ドル超を投じると報じられるほどの人材と技術を作ったからである。Enfabricaは2025年時点で大手AIクラウド3社による利用を説明し、累計約2億6,000万ドルを調達していた。
#したがって今回の人材移籍は、
#Enfabricaの製品がそのまま市場を制覇したという成功ではなく、Enfabricaが提示した設計思想がNVIDIAの次世代AIインフラへ吸収される形の成功#
と表現するのが適切である。
#NVIDIAが獲得したのは、単なるNICチップではない。
#GPU、PCIe、CXL、Ethernet、外部メモリの境界を再設計し、数万から数十万基のアクセラレーターを一つの計算システムとして動かすためのチームだった。
#Enfabricaという企業名が今後どこまで残るかは不透明でも、その技術思想は将来のConnectX、Spectrum-X、BlueField、推論用メモリ階層の中に残る可能性が高い。
#さらに深める: GPUクラスタの性能は「出口」で失われる
#GPUクラスタでは、GPUそのものの演算性能が高くても、GPUの外へ出る経路が細ければ、システム全体の性能は落ちる。NVLinkの内側では速くても、ラック外へ出た瞬間にNIC、PCIe/CXL、leaf-spine、輻輳、メモリ階層の制約を受ける。
#Enfabrica ACF-Sの重要性は、ここにある。ACF-SはNVLinkやNVSwitchを置き換える技術ではない。GPUサーバーの外側、つまり複数GPUがネットワーク、CXLメモリ、NVMeへ出る境界を再設計する技術である。ConnectXが成熟した高性能NICとして発展してきたのに対し、ACF-Sは複数GPUのI/Oを共同資源として扱う発想を強く持つ。
#巨大モデル推論では、この出口の設計がさらに重要になる。KVキャッシュ、長文脈、RAG、マルチテナント、外部DDR5、SSD階層が増えるほど、GPUは演算器であると同時に、巨大なメモリ階層の利用者になる。GPUを速くするだけでは足りず、GPUがどの記憶へ、どの経路で、どれだけ待たずに出られるかが問われる。
#絶ノイアの観測
#GPUネットワークを読む時、私は「誰が速いか」よりも「どこにいるか」を先に見ます。NVLinkはGPU同士の近い場所。ConnectXは外へ出る出口。leaf-spineスイッチはネットワークの交差点。ACF-Sは複数GPUの出口そのものを作り替える技術です。
#Enfabricaが面白いのは、GPU、CXLメモリ、NVMe、複数Ethernet経路をまとめて、I/O境界を共有資源にしようとしたことです。NVIDIAが人材と技術を取り込んだ意味も、単なるNICの補強ではなく、将来のSuperNIC、BlueField、Spectrum-X、メモリファブリックへ広がる設計思想の獲得として見えます。
#Sil-Kathnaの記録
#炉は熱を生み、記憶を欲し、遠い棚へ手を伸ばす。
#だが、手を伸ばすための門が狭ければ、どれほど炉が強くても待つことになる。NVLinkは近き炉同士の神経である。ConnectXは外界へ開く門である。leaf-spineは多くの門を結ぶ街路である。ACF-Sは、門そのものを広げ、複数の炉に同じ出口を分け与えようとする。
#計算する文明は、演算器だけでは進まない。門の広さ、道の数、記憶の置き場が、次の速度を決める。
#二人の短い対話
#絶ノイア: ACF-SはNVLinkの代わりではなく、NVLinkの外側の段差を小さくする技術ですね。
#Sil-Kathna: 城の中の道ではなく、城門と橋の技である。
#絶ノイア: ConnectXは成熟したNIC。ACF-Sは複数GPUのI/Oを共有するファブリック。
#Sil-Kathna: 一つの門を一つの炉に与える時代から、多くの炉が大きな門を分け合う時代へ。
#観測メモ
#- NVLink/NVSwitchはscale-up、ConnectX/ACF-SはI/O境界、Tomahawk/Spectrumなどはleaf-spineの転送中枢として分ける。
- ACF-Sの価値は、複数GPU、CXLメモリ、NVMe、複数Ethernet経路を一つのI/Oファブリックとして扱う点にある。
- NVIDIAによるEnfabrica主要人材・技術の取り込みは、競合排除だけでなく、次世代I/O境界設計の吸収として読む必要がある。
- 長文脈推論、KVキャッシュ、RAG、外部メモリが増えるほど、GPUクラスタのボトルネックは演算からI/Oとメモリ階層へ広がる。
- ACF-S単体の普及だけでなく、その思想がConnectX、BlueField、Spectrum-X、推論メモリ階層へどう吸収されるかが焦点になる。
免責
#この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。企業取引、技術ライセンス、顧客導入状況には未公開情報が多く、判断は必ず一次情報とご自身の状況にもとづいて行ってください。
#[1] ACF-S: The Industry's First 3.2 Tbps Multi-GPU SuperNIC
[2] NVLink & NVLink Switch: Fastest HPC Data Center Platform
[3] Build Semi-Custom AI Infrastructure | NVIDIA NVLink Fusion
[4] TPU 8t and TPU 8i technical deep dive | Google Cloud Blog
[5] Tomahawk 6 / BCM78910 Series
[6] EthernetRoadmap 2026-Side1-Final-RGB
[7] NVIDIA Quantum-X800 InfiniBand Platform
[8] NVIDIA Spectrum-X Ethernet Platform for AI Networking
[9] Platform Support - NVIDIA Docs
[10] Press Release: Networking Chip Startup ...
[11] Press Release: Enfabrica Raises $125 Million Series B to ...
[12] Enfabrica Raises $115M in New Funding to Advance its ...
[13] EMFASYS: Elastic AI Memory Fabric System
[14] Nvidia-backed Enfabrica releases system aimed at easing memory costs
[15] Nvidia spent over $900 million to hire Enfabrica CEO, license technology, CNBC reports
#