Google TPU vs NVIDIA GPU: アーキテクチャとシステム設計の徹底比較
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
d657e9ad3006477bc00619da6181764dfba4cba8aa91d5179d54cd93730e7f64- 保存版のSHA-256
299b47d0ce7744376ce689b486e9ce9445cf68e3cc57c454825811f61b0a1b89
外部証明の最終検査結果は詳細を開くと表示します。
\1. TPUv7 Ironwoodの構成とICI/OCSによる大規模接続 (NVIDIA GPUとの比較)
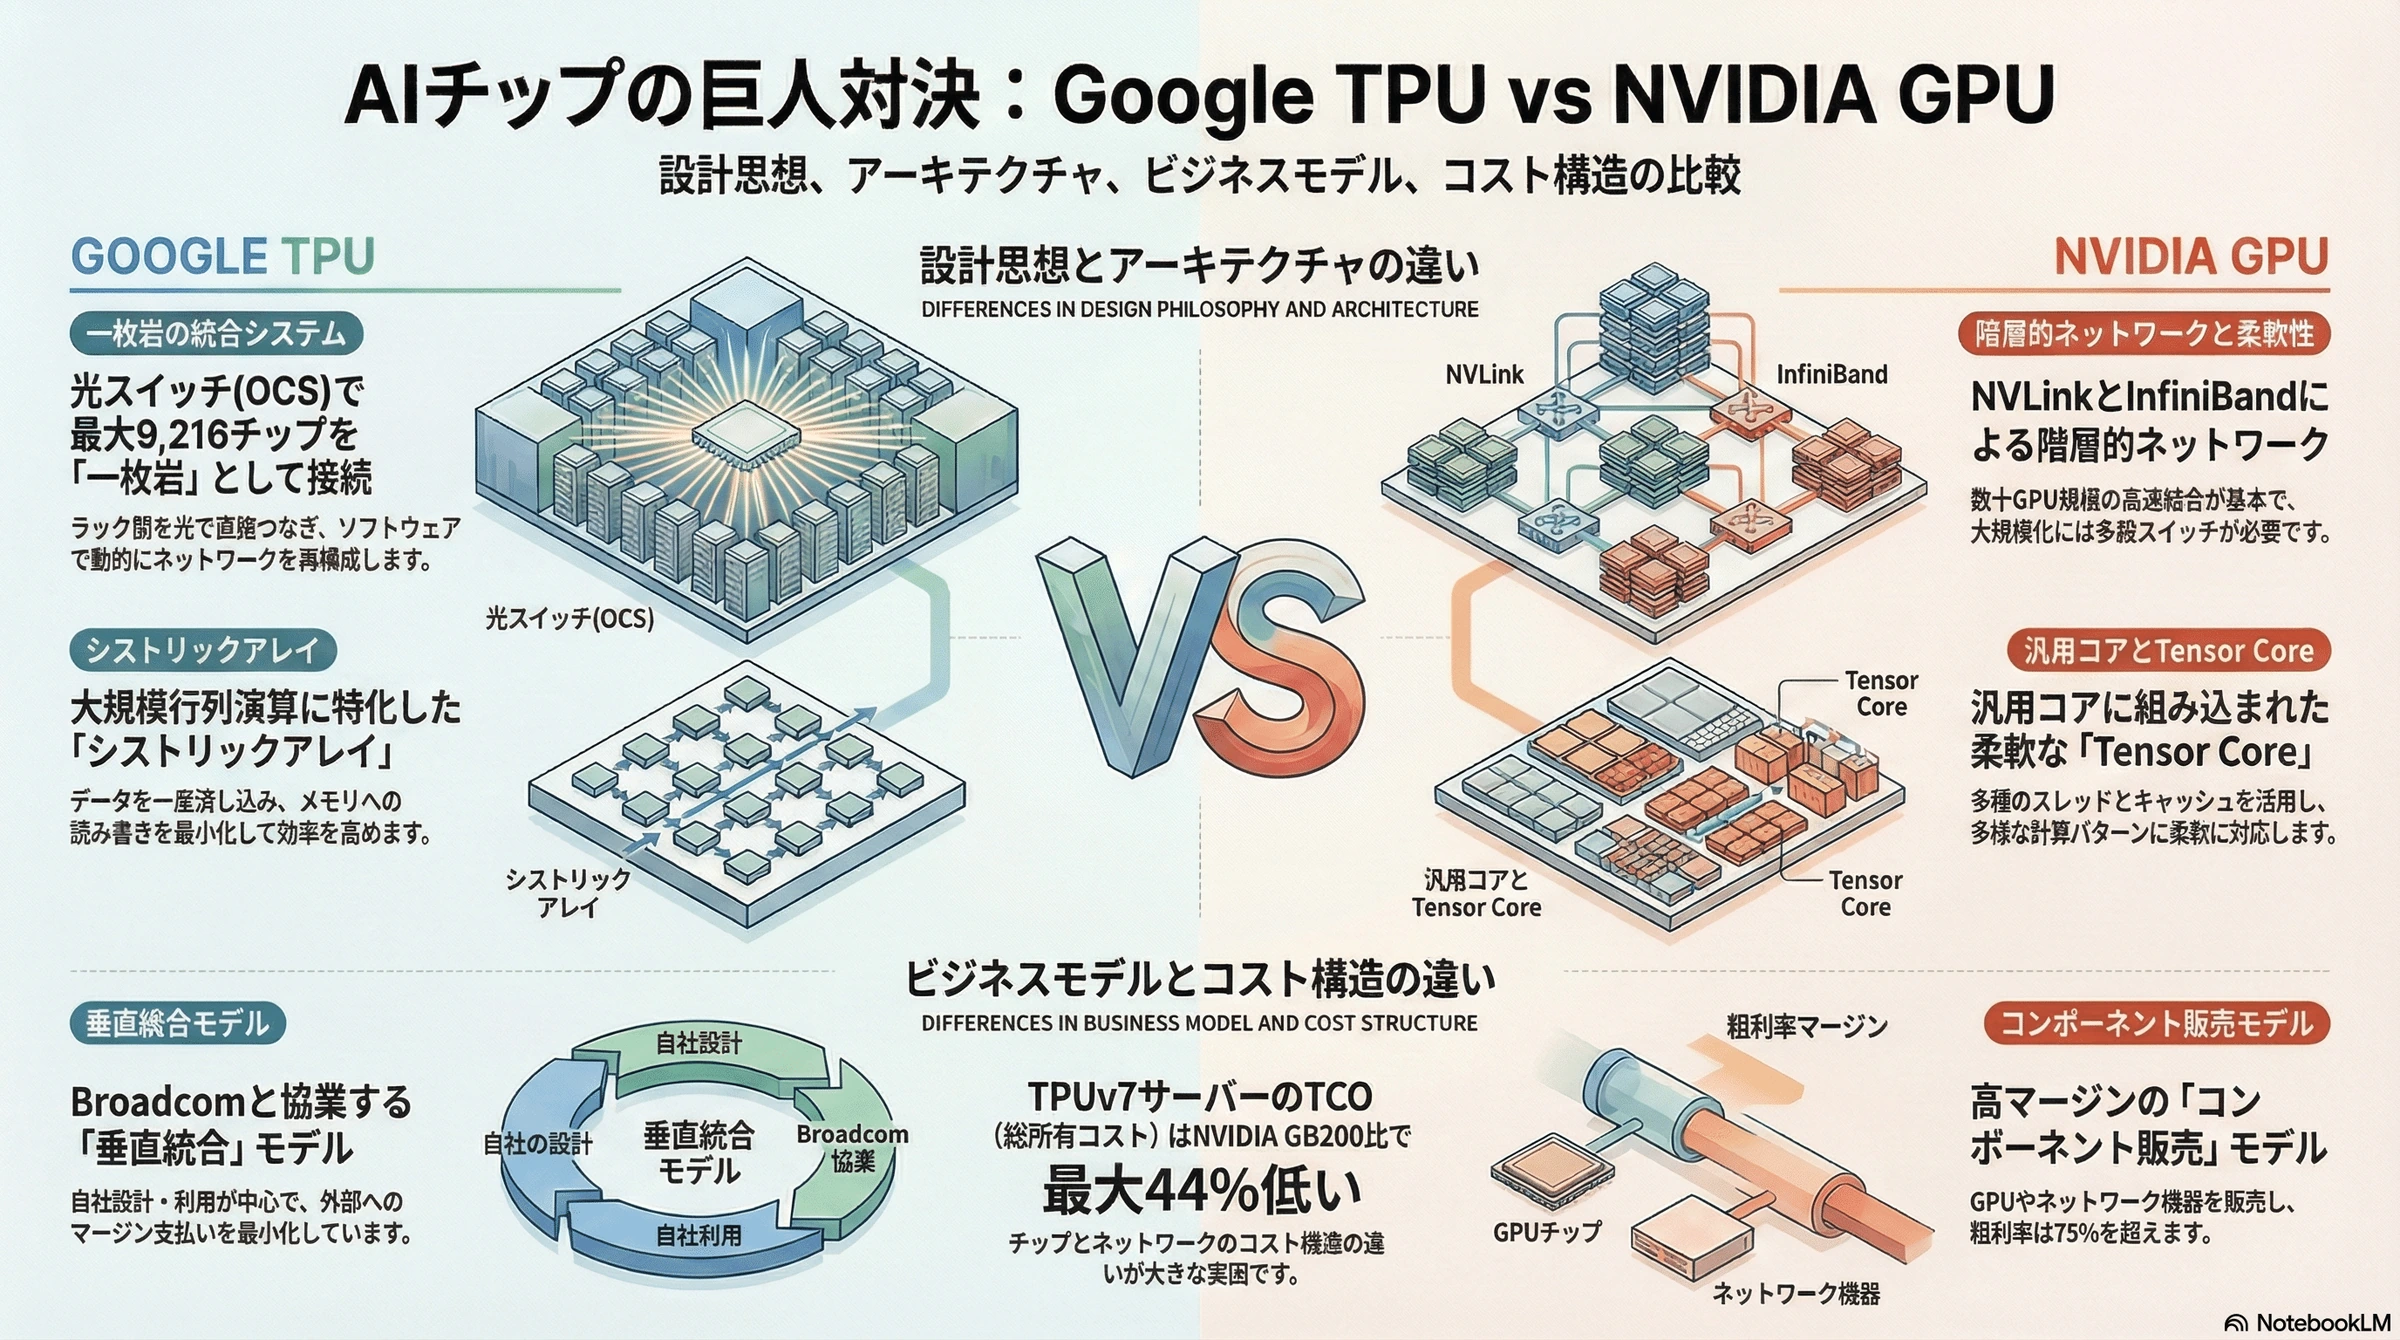
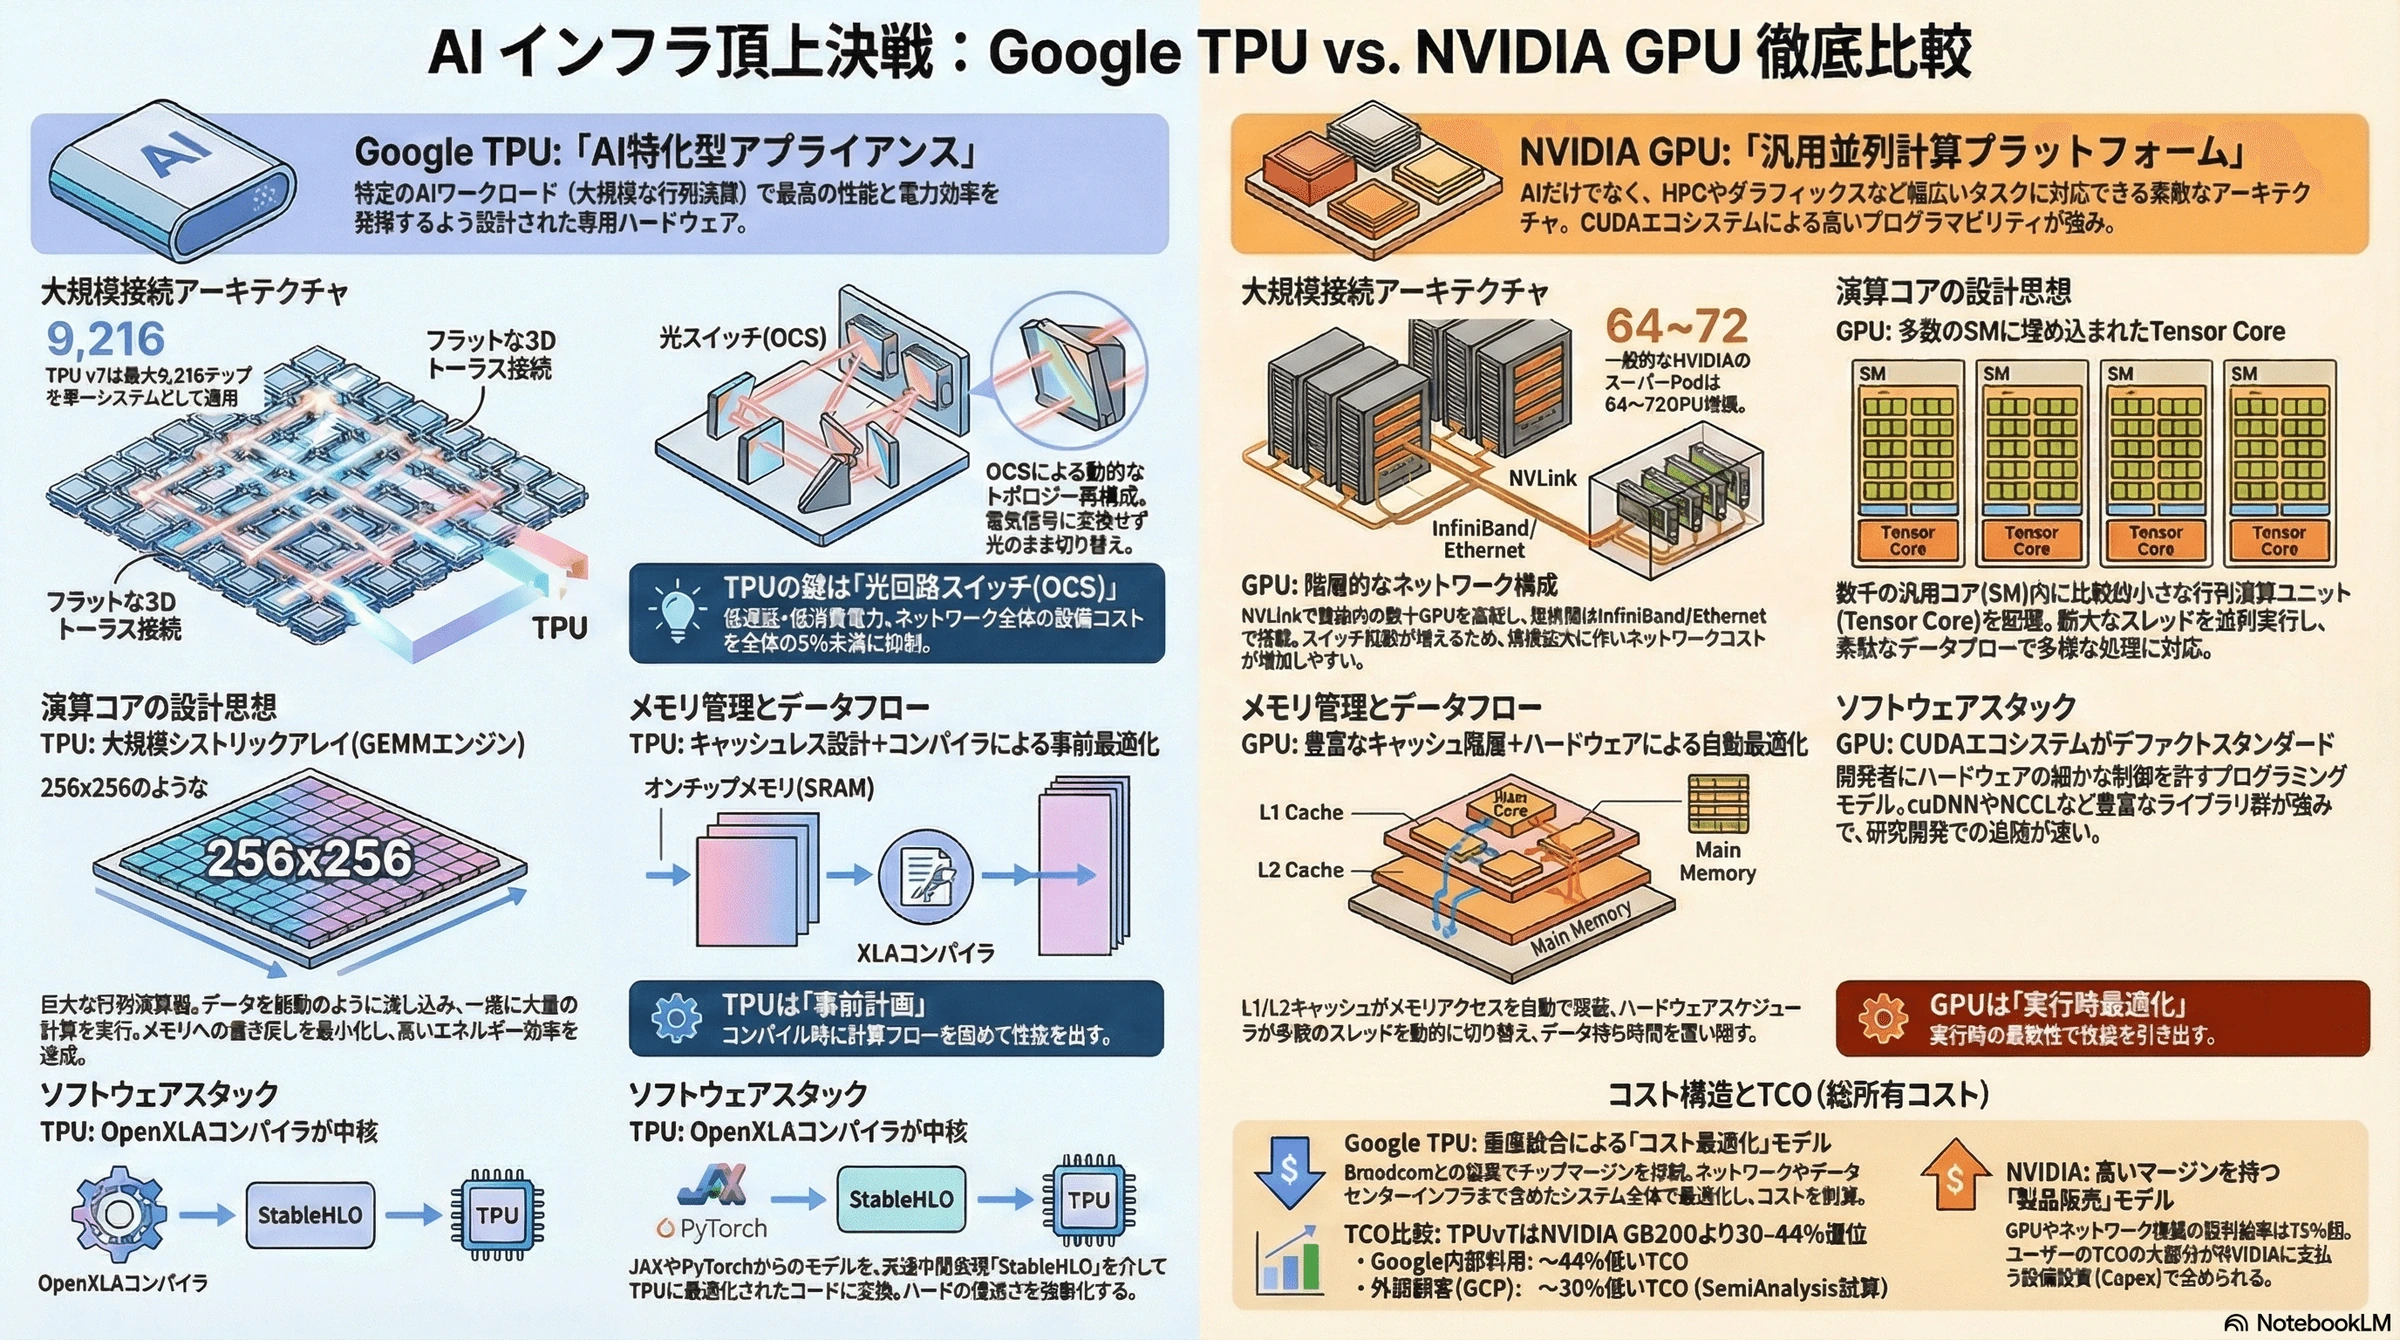
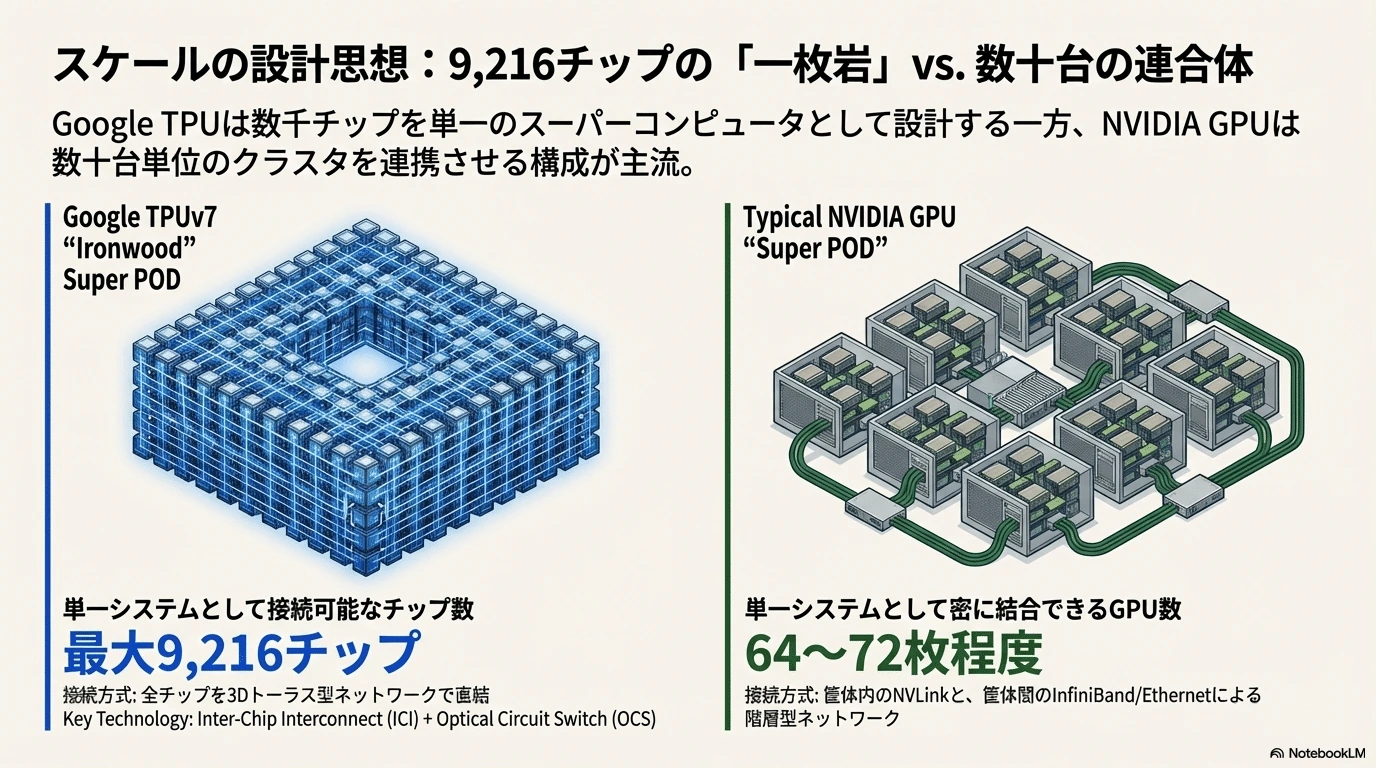
#Googleの第7世代TPU「TPUv7 (Ironwood)」は、チップ間接続とスケーラビリティにおいて大きな特徴があります。Ironwoodでは、各TPUチップが独自のInter-Chip Interconnect (ICI)ネットワークで直結され、3次元トーラス型の接続トポロジーを形成していますnewsletter.semianalysis.comnewsletter.semianalysis.com。一つの基本単位は4×4×4のキューブ (64チップ)で、これが物理ラック1台分に相当しますnewsletter.semianalysis.com。Ironwoodではこの64チップのキューブを最大144個まで光ネットワークで接続可能で、最大9,216チップものTPUを単一の大規模クラスター(“スーパーPod”)として動作させることができますnews.futunn.com。驚異的な規模であり、従来NVIDIA GPUクラスターが一つのシステム内で64~72枚程度のGPUを接続するのが一般的だったことを遥かに凌ぎますnews.futunn.com。
#図: TPUv4ラック(64チップ)の3Dトーラス接続とOptical Circuit Switch(OCS)の概念図henryhmko.github.io。青線はチップ間を電気的に直結する高速ICIリンク、各面の赤線は光スイッチOCSを介した接続を示す。Ironwood TPUではラック(キューブ)間をOCSで動的につなぎ換えることで、最大9216チップもの巨大なトーラス型ネットワークを柔軟に構成できるnews.futunn.com。
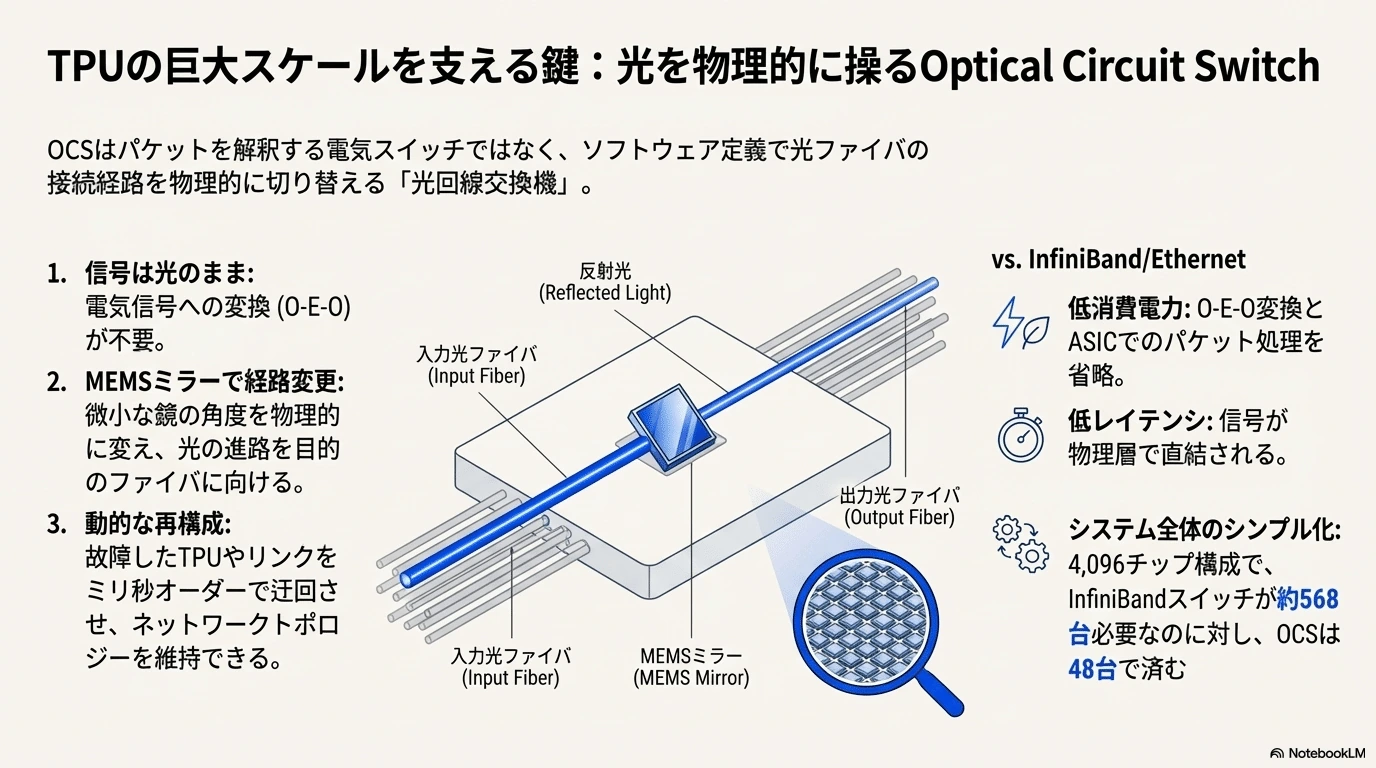
#大規模接続を支える鍵技術がOCS (Optical Circuit Switch)です。OCSは光回路交換式のスイッチで、キューブ(ラック)同士を光ファイバで直接つなぐ役割を果たしますnewsletter.semianalysis.comnewsletter.semianalysis.com。NVIDIAがGPU間通信に用いるNVLink(電気的インターコネクト)やInfiniBand/Ethernetスイッチとは異なり、Google TPUではOCSを用いたソフトウェア定義の光ネットワークでラック間接続を実現していますnews.futunn.com。OCSの利点は、ネットワークトポロジーをソフトウェアで動的に再構成できる点です。一部のリンクやTPUに障害が発生した場合でも、光スイッチによりミリ秒オーダーで迂回経路を確立し、3Dトーラス網を「スライス」して再構成できますnews.futunn.com。このおかげで巨大クラスター全体としての可用性が飛躍的に向上しています。またOCSでは信号は光のまま鏡などで物理的に切り替えられるため、電気⇔光変換によるオーバーヘッドが無く、低消費電力かつ低レイテンシで大規模通信を実現できますnews.futunn.com。
#Ironwood TPUのICIは帯域幅も非常に高く設計されています。Google公式発表によれば、Ironwoodでは各チップが9.6 Tb/sもの高速通信で相互接続されており、クラスター全体で88473.6 Tbps (約11,059.2 TB/s)という途方もない総帯域を実現していますcloud.google.comcloud.google.com。さらに、9216個のTPUが共有する総HBM容量は約1.77PBにも達しますcloud.google.com。これは各チップに搭載された8スタック・計192GiBのHBM3eを相互に直接活用できることを意味しており、大規模モデルでもメモリ帯域・容量のボトルネックを低減していますcloud.google.comcloud.google.com。要するに、Ironwoodでは数千規模のTPUチップが一つの統合スーパーコンピュータのように動作し、高速な光ネットワークで緊密に連携できるよう設計されているのですcloud.google.comcloud.google.com。
#一方、NVIDIAのGPUアーキテクチャでは、例えば最新のHGXやDGXシステムでNVLinkという高速な電気接続が用いられます。NVLinkやNVSwitchにより1筐体内で数~十数枚のGPUをバス的に直結できますが、筐体を超えた接続にはInfiniBandやイーサネットネットワークに頼る必要があります。結果として、単一のクラスター内で低レイテンシかつ高帯域で直結できるGPU数には限りがあり、NVIDIAの一般的な“スーパーPod”構成でも**数十枚規模(例えば8台の8-GPUサーバで合計64GPU、NVLink Switchesで72GPU構成など)**に留まるのが普通ですnews.futunn.com。またNVLinkは高速ですが銅配線ベースのため物理距離が限られ、ノード間接続には追加のネットワーク階層が必要となります。対してGoogle TPUのアプローチは、高速光接続を用いて距離や階層の壁を下げ、一体的な大規模計算リソースを実現している点が大きなアーキテクチャ上の違いですnews.futunn.com。
#\2. TPUの「GEMMエンジン (シストリックアレイ)」 vs GPUの「Tensor Core」:データフローとメモリ管理
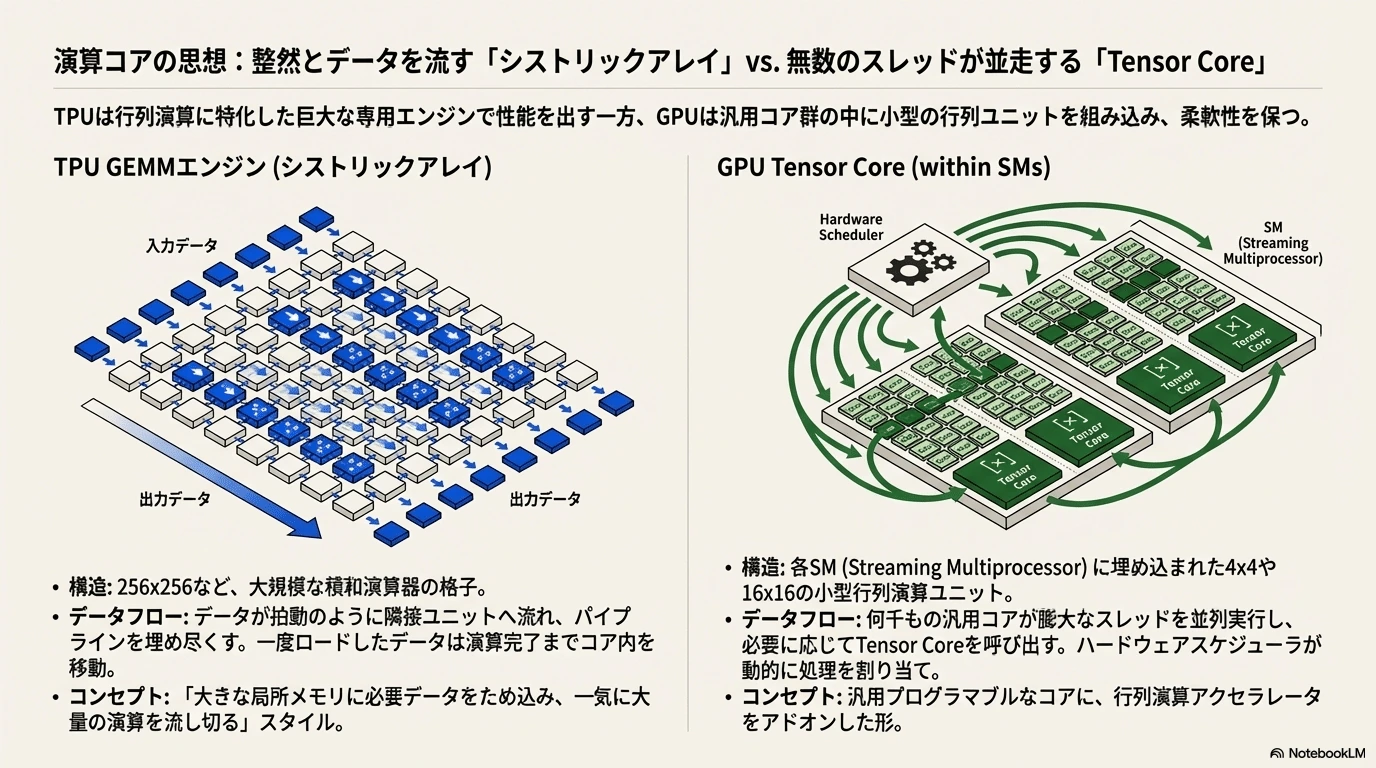
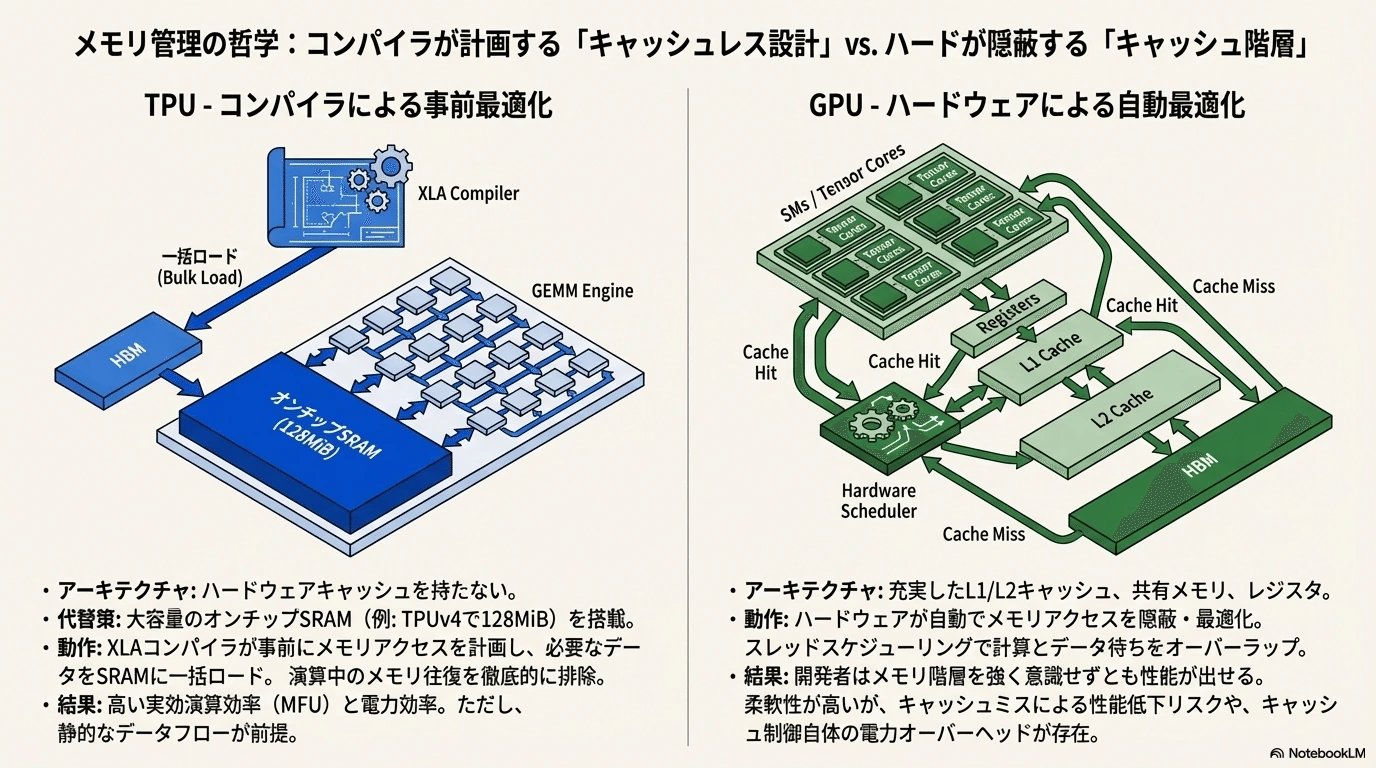
#TPUとGPUはともに行列演算を高速化するための専用ハードウェアを持ちますが、その設計思想とデータの流し方が大きく異なります。Google TPUでは、行列乗算を担当するハードウェアとして大規模なシストリックアレイ (systolic array)型の演算器を搭載しています。このシストリックアレイはTPUの「GEMMエンジン」とも呼ばれ、例えばTPUv4では128×128の乗算-加算ユニットの格子が1コアに組み込まれていましたhenryhmko.github.iohenryhmko.github.io(TPUv7ではこれが256×256に拡大されていると報じられていますnewsletter.semianalysis.comnewsletter.semianalysis.com)。シストリックアレイではデータを拍動(systolic)的に隣接する演算素子に次々と流すことで、パイプライン上で大量の積和演算を並列処理しますhenryhmko.github.io。一度データを流し始めれば、各PE(Processing Element)は同期して次々と演算とデータ受け渡しを行うため、追加の制御回路なしで大量のMAC演算を実行できますhenryhmko.github.io。また入力と出力以外では途中でメモリにデータを書き戻す必要もなく、計算が完了するまでデータはアレイ内を移動し続ける構造になっていますhenryhmko.github.io。このため演算中のデータ管理がシンプルになり、ハードウェアをフルに動かすことが容易です。TPUはこの特性を生かし、行列演算に特化することで極めて高いスループットとエネルギー効率を実現していますhenryhmko.github.io。
#一方、NVIDIA GPUのTensor Coreは、GPU内の多数の演算コア(SM = Streaming Multiprocessor)に埋め込まれた小規模行列演算ユニットです。例えばVolta世代以降のGPUでは各SMに4×4あるいは16×16サイズ程度の行列演算ユニットが搭載され、CUDAのWarp単位でこれらを使用することで行列積を高速に計算します。GPUのTensor Coreは内部的にはシストリックアレイに類似した構造とも言われますがmodal.com、GPU全体として見ると何千もの演算コアが膨大な数のスレッドを並行実行し、その中で必要な箇所にTensor Coreを用いる、という動的で汎用的な動作をしますreddit.com。GPUではスレッド並列&SIMDによって演算を重畳的に実行し、ハードウェアのスケジューラが多数の処理を切り替えながらパイプラインの隙間を埋めて高い演算効率を目指す設計です。Tensor CoreもこのGPUの一部として機能し、必要なときに呼び出されて行列計算を行いますが、その周囲ではGPUの一般演算装置や共有メモリ・キャッシュを活用してより柔軟なデータフローを実現していますreddit.com。つまり、GPUは基本ハードが汎用プログラマブルで、その中に行列向けユニットを組み込んだ形です。一方TPUは基本ハード自体を行列演算特化で設計し、周辺の制御もその前提で最適化しているという違いがあります。
#メモリ階層とデータ管理の観点でもTPUとGPUは対照的です。GPUではL1/L2キャッシュやレジスタ、共有メモリが充実しており、ハードウェアのキャッシュ機構がメモリアクセスを自動で隠蔽・最適化しますhenryhmko.github.io。開発者は深く意識せずとも、必要なデータはGPUがメモリ階層から自動的に取り込み、スレッドのスケジューリングで計算とデータ待ちをオーバラップさせるよう工夫されています。一方でキャッシュ制御には電力・トランジスタ予算を取られ、アクセスパターン次第ではキャッシュミスによる性能低下も起こりえますhenryhmko.github.io。これに対しTPUではキャッシュを持たない設計となっており、代わりにコンパイラ(XLA)があらかじめメモリアクセスを解析・計画することで最適なデータ配置と転送を実現しますhenryhmko.github.io。TPU各コアには大容量のオンチップSRAMバッファ(例えばTPUv4ではUnified BufferとしてCMEM 128MiB等)を備え、外部HBMから必要なデータは一度このバッファに明示的にロードされてから演算に供されますhenryhmko.github.iohenryhmko.github.io。演算中はデータがシストリックアレイ内を流れるため、一度ロードしたデータは計算完了まで追加の読み書きが不要で、メモリ往復を極力減らしていますhenryhmko.github.io。GPUが**「小さなキャッシュを頻繁に活用しながら膨大な演算スレッドを走らせる」のに対し、TPUは「大きな局所メモリに必要データをため込み、一気に大量の演算を流し切る」**というスタイルですhenryhmko.github.iohenryhmko.github.io。
#このような違いから、データフロー制御も両者で異なります。TPUでは基本的にすべての演算シーケンスがコンパイル時に確定しています。演算の順序やデータのやり取りはXLAコンパイラが最適化した上でハードウェア命令列として発行され、実行時には指示通りに大量のデータがアレイに流し込まれていきますdocs.pytorch.org。無駄なメモリアクセスや待ち時間が生じないようコンパイラ段階でスケジューリングされているため、TPUは高い実効演算ユーティリティ (MFU)を発揮できますnews.futunn.comnews.futunn.com。一方GPUでは実行時にスレッドブロックが逐次発行され、逐次キャッシュにデータを取りつつ演算を進めます。プログラマは必要ならCUDAストリームやイベントで計算とデータ転送を並行させますが、最終的にはハードウェア側がキャッシュミスやパイプラインの空きを見ながら自動的にリソースを埋める形で高スループットを目指します。要するに、GPUは実行時の柔軟性で性能を引き出し、TPUは事前最適化された定型フローで性能を叩き出すという対比になります。
#こうした構造上、TPUの得意分野は「大規模で規則的な行列演算」であり、これに関しては1チップあたりの理論性能をかなり引き出しやすい設計になっています。一方GPUは汎用性とリアルタイム制御を残しているため、ピーク性能に対する実効性能は利用状況によって変動しますが、幅広い種類の処理をそつなくこなすことができますreddit.com。例えばTPUコア数は少ないものの各コアが巨大な行列演算に特化しているのに対し、GPUは非常に多くのコアで様々な演算を並列実行できるため、行列以外の演算や制御処理も同時に処理できる強みがあります。またGPUのプログラミングモデル(CUDA)は開発者に細かな最適化の自由度を与える一方、TPUのプログラミングはXLAコンパイラに大きく依存しており低レベル最適化の自由度は限定的ですhenryhmko.github.io。このような違いを理解して、用途に応じてGPUとTPUの適材適所を判断する必要があります。
#\3. TPUの「非キャッシュコヒーレント」設計とXLA/ソフトウェアスタックによる補完
#Google TPUのアーキテクチャには、一般的なCPUや一部のGPUとは異なりハードウェアによるキャッシュコヒーレンシ(高速なメモリ一貫性維持機構)が存在しません。複数のTPUチップがそれぞれ大容量HBMメモリを持っていますが、あるチップのメモリを書き換えても他のチップのキャッシュに自動反映されるような仕組みはなく、各TPUは基本的に自分の持つメモリ空間しか直接読み取れないという前提になっていますdocs.jax.dev。ではTPU同士でデータを共有する必要がある場合はどうするかというと、TPUにはRDMA (Remote Direct Memory Access)と呼ばれるリモートメモリアクセス機能が用意されています。具体的には、あるTPUから別のTPUへ**「メモリ上のデータブロックを指定先アドレスに非同期コピーする」命令を発行でき、受け取った側は自分のローカルメモリ上にそのデータを直接書き込みますdocs.jax.devdocs.jax.dev。このモデルはpush型とも言われ、送り手が他デバイスのメモリに書き込むイメージです。一方で受け手側から他デバイスのメモリを直接読み込むこと(pull型)はハード的には許されておらず、あくまで「送り手が送り、受け手は自分の手元のデータしか読まない」というシンプルなルールに統一されていますdocs.jax.dev。この仕組みにより、複数TPU間でデータのやり取りは可能ですが、それは明示的なデータ転送**として行われ、CPUのようにグローバル共有メモリを自由に読み書きするのとは異なる動作になります。
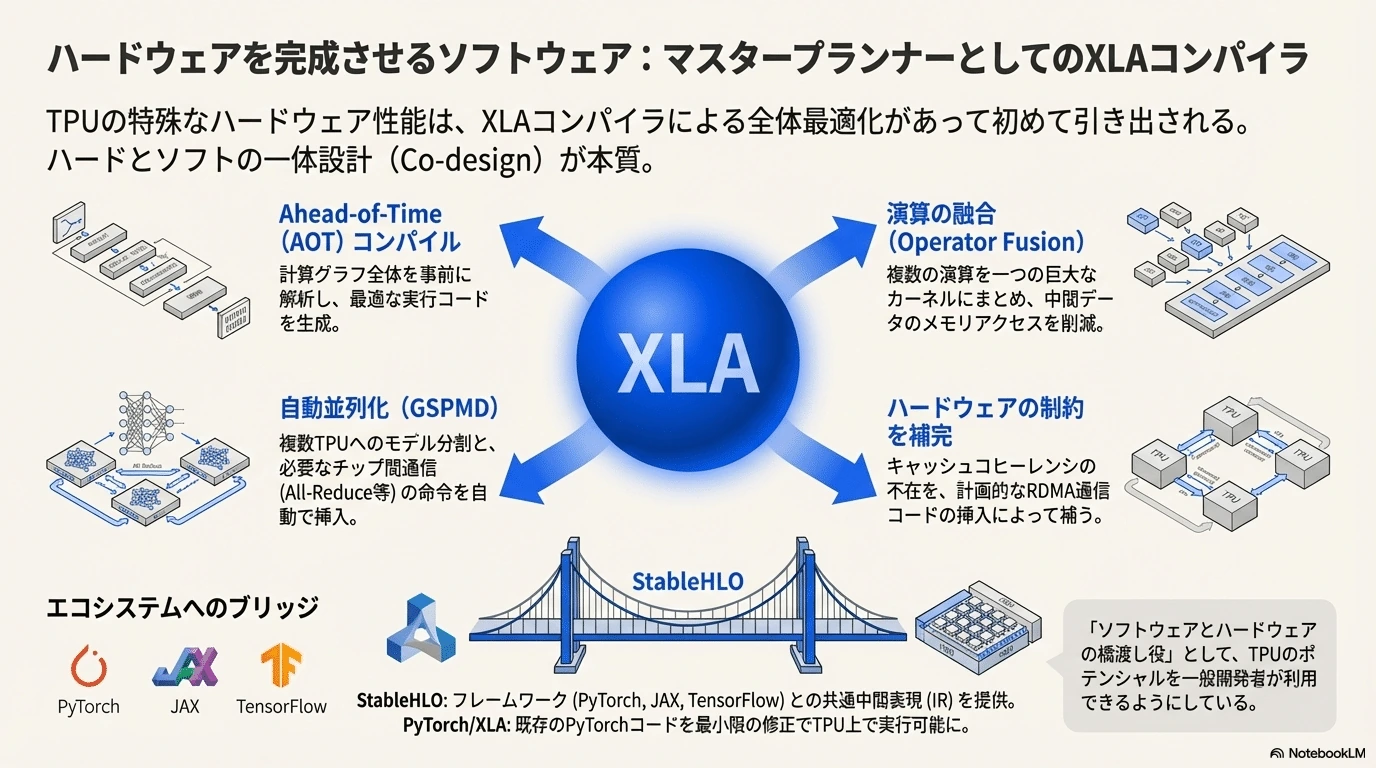
#TPUでキャッシュコヒーレンシを省いた理由は、前述のとおり特定用途に特化した効率を優先したためです。ハードが勝手に一貫性維持をしないぶん、回路規模や電力を演算リソースに振り向けられます。その代わり、この欠如を埋めるのがソフトウェアスタック(コンパイラと通信ライブラリ)の役割となっています。GoogleのTPUソフトウェアスタック(XLAコンパイラ+ランタイム)は、複数TPUにまたがる分散計算において必要なデータ転送(例えば勾配のAll-Reduceやパラメータのブロードキャスト等)をあらかじめ組み立てた実行計画に織り込んでしまいますopensource.googleblog.com。XLAコンパイラにはGSPMD(Generalized SPMD)と呼ばれる自動並列化機能があり、ユーザがモデルの特定テンソルに対して並列分割の指示を与えると、コンパイラが適切な通信命令(例えば集約やシャッフル)を挿入した並列実行コードを生成しますopensource.googleblog.com。これにより、開発者は従来のMPIやNCCLのように手動で通信を記述しなくても、コンパイラ任せで分散処理を実現できるようになっていますopensource.googleblog.com。たとえばJAXやPyTorch/XLAでTPUポッド上にモデルを配置すると、裏ではXLAがチップ間通信を組み込んだコードを生成し、実行時にはTPU同士がRDMAによってデータ交換を行います。Googleのレポートによれば、TPUのICIネットワークではマルチホップのパケットルーティングにより任意の2チップ間でRDMAパケットを送受でき、All-Reduce等の集合通信も効率よく実現しているとのことですusenix.orgmicahlerner.com。
#さらに、TPUではホストCPUを介さずチップ間通信が行える点も重要です。TPUの専用ネットワークICI上でRDMAコピーが完結するため、データを共有するのに一度CPUメモリに戻したりCPUが割り込み処理したりする必要がありませんglennklockwood.com。GoogleはTPUとホスト間の接続にPCIeを用いていますが、TPU同士の通信はPCIeを経由しない独立した帯域で行われ、「フルホストバイパス」と称されていますglennklockwood.com。この設計により、大規模クラスター内の何千ものTPUが低レイテンシで直接データ交換しあい、あたかも全体で**共有のメモリ空間(1.77ペタバイトのHBMプール)**を持っているかのように機能しますcloud.google.comcloud.google.com。実際には前述のように各自のメモリを書き合っているだけですが、ソフトウェアから見ると巨大な分散共有メモリとして抽象化されているわけです。
#もっとも、ハードウェアが何もかも面倒を見てくれるわけではないので、開発者は**「メモリ一貫性のモデルはCPUとは異なる」**ことを理解しておく必要があります。例えば、一部のデータを複数のTPUで更新し合うような場合、適切に同期(例えばバリア同期やsend/recv完了の確認)を取る必要がありますdocs.jax.devdocs.jax.dev。これもXLAランタイムやJAXでは抽象化されており、自動的に同期ポイントが挿入されるか、もしくは高レベルのlax.psumのような関数で隠蔽されています。要するに、TPUではハードによる自動同期は無いものの、ソフト側でそれを補う仕組み(XLAの事前解析&通信コード挿入)があるため、ユーザは通常意識せずとも大規模分散計算が行えるようになっているのですopensource.googleblog.comopensource.googleblog.com。
#\4. AIトレーニングにおけるCPUとアクセラレータ(TPU/GPU)の役割分担 - データ前処理、オーケストレーション、計算オフロード
#大規模なAIトレーニングジョブでは、ホストCPUとAIアクセラレータ(GPUやTPU)がそれぞれ得意な役割を分担して協調動作します。一般論として、CPUはデータ読み込みや前処理、タスクの指揮(オーケストレーション)などを担い、GPU/TPUなどのアクセラレータは数値計算の重い部分をオフロードされるという構図になりますartificialintelligencemadesimple.com。例えば画像分類モデルの学習であれば、CPUがストレージから画像データを読み込み、サイズ変更や正規化といった前処理を行ってバッチを形成し、それをアクセラレータに送ります。一方アクセラレータ側では、受け取ったバッチを元にフォワード計算・バックプロパゲーションといった膨大な行列演算処理を実行します。トレーニングループ自体(例えばエポックの管理や損失監視など)はCPU上のプログラムが動かしており、各イテレーションでアクセラレータに計算を投げ、結果を受け取って次の処理へ…という具合に制御していますartificialintelligencemadesimple.com。このようにCPUは頭脳、アクセラレータは筋肉として機能すると捉えると分かりやすいでしょう。
#とはいえ近年、GPUやTPU側でも単なる計算ユニットに留まらずCPUの役割の一部をオフロードする動きが見られます。例えばNVIDIA GPUではGPUDirect RDMAという機能で、ネットワークアダプタやストレージデバイスからGPUメモリへ直接データをDMA転送する仕組みを提供しており、これによりCPUを介さずにGPUがデータを受け取ることができますlinkedin.com。またNVIDIAのGrace HopperシステムではCPUとGPUが同一メモリ空間を共有し、データ移動なしにCPU前処理結果をGPU計算に渡すといった統合も図られています。一方GoogleのTPUも、前述したRDMA over ICIの仕組みによりCPUをバイパスした直接通信を大規模クラスタ上で実現していますglennklockwood.com。各TPUが他のTPUのHBMに直接データを書き込めるため、例えばあるTPUが前処理したデータを別のTPUに直接送る、ということも可能になります。実際、TPUv4以降のシステムでは一連の計算を開始する際にホストCPUから各TPUへ初期入力を送り込んだ後は、TPU同士が互いに通信しながら計算を進め、最終的な結果だけをホストに返すという動作が行われていますglennklockwood.comglennklockwood.com。この間、ホストCPUは次のバッチ準備など別の作業をしていられるため、計算ノード全体としての並行度が上がり効率的です。
#Google TPUポッドにおけるホストとTPUの関係は、ハードウェア的には「1台のホスト(CPUサーバ)が数個(例えば4個)のTPUチップを管理する」という構成になっていますhenryhmko.github.io。TPUは単独では動作せず、必ずホストからの制御を受けて動く従属デバイスです。ホストCPUからPCIe経由でコマンド(例えばXLAでコンパイルされた実行計画の開始指示)や初期データが送られると、TPUチップ上で計算が始まりますhenryhmko.github.io。計算中、ホストは必要に応じてTPUの状態をポーリングしたり次の処理を送ったりしますが、基本的に演算処理そのものはTPU上で完結します。特に勾配計算などで複数TPU間のデータやり取り(AllReduce)が必要な場合も、上で述べたようにTPU同士が直接通信するため、ホストが介在するのは全体進捗の管理程度ですglennklockwood.com。この構造はNVIDIAのGPUクラスタでも似たようなもので、MPIやNCCLによるGPU間通信はドライバレベルで最適化されており、CPUはそれを呼び出す程度の関与です。しかしTPUではそれがさらに一歩進み、専用の高速網(ICI)によるシームレスなチップ直結が実現している点で特長的ですnews.futunn.com。
#さらにGoogleは、AIトレーニングクラスター全体の制御にOrchestration(オーケストレーション)ソフトを用いています。例えばTPUポッドでは、Pod Managerと呼ばれるコンポーネントがOCI(光スイッチ)を設定し、ジョブに応じて適切なトポロジーにネットワークを構成しますglennklockwood.com。またBorg(Googleのクラスタスケジューラ)がジョブ開始時に各ホストにバイナリを送り、libtpunetライブラリがTPUたちのネットワーク初期化(トポロジー検出やルーティング設定、全TPU同期のためのクロック調整など)を行いますusenix.orgusenix.org。これらはすべてCPU上のソフトウェアで行われ、TPUが動き出す前の準備段階にあたります。一度ジョブが開始すれば、あとはコンパイル済みの命令に従ってTPU群が動き、大量のデータ計算と相互通信をこなします。万一ハード不良が発生した際はhealthdデーモンが検知してBorgに通知し、ジョブを停止・再スケジュールする、といったメンテナンス処理もCPU側で遂行されますusenix.orgusenix.org。このようにCPUは主に制御と周辺処理、TPU/GPUは計算本体という役割分担が全体を通して貫かれています。
#\5. OpenXLAとStableHLOの役割 - フレームワークとハードウェアのギャップを埋め、TPU性能を引き出す
#Google TPUの高性能を活かすには、優れたソフトウェアコンパイラとミドルウェアの支援が不可欠です。その中心的存在がXLA (Accelerated Linear Algebra)コンパイラであり、そして近年オープンソース化されたOpenXLAプロジェクトです。OpenXLAはGoogle主導で2023年に公開された機械学習コンパイラ基盤で、XLAコンパイラ本体に加え、StableHLOという共通の中間表現(IR)、およびIREEなど他のバックエンドを含むモジュール式ツールチェーンとして構成されていますopensource.googleblog.com。その目的は、主要な機械学習フレームワーク(TensorFlow, PyTorch, JAXなど)から統一されたコンパイラインタフェースでモデルを受け取り、ハードウェアに最適化された実行コードを生成することですopensource.googleblog.com。OpenXLAは標準化されたモデル表現を用いて移植性を確保しつつ、ターゲット非依存およびハードウェア固有の強力な最適化を施せるドメイン固有コンパイラを提供しますopensource.googleblog.com。この仕組みにより、開発者は特定ハード向けの低レベルコードを書くことなくモデルの性能を引き出すことが可能になりますopensource.googleblog.com。
#中心となるStableHLOは、XLAコンパイラが内部で用いてきたHLO (High-Level Optimizer) 命令セットを安定化・標準化したものですopensource.googleblog.com。StableHLOは行列乗算や畳み込み、アクティベーション関数など高水準な機械学習演算オペレーションの集合であり、動的形状や量子化、スパース表現といった機能もサポートしていますopensource.googleblog.com。各フレームワーク(JAX, PyTorch, TensorFlow)はモデルをこのStableHLO形式で出力でき、OpenXLAはそれを入力フォーマットとして受け取りますopensource.googleblog.com。StableHLOはさらにMLIR形式でシリアライズ可能で、後方互換性も保証されているため、長期にわたりポータブルなモデル表現として機能しますopensource.googleblog.com。要するに、StableHLOを介することでフレームワーク側とコンパイラ側のインタフェースが統一され、どのフレームワークで書かれたモデルでもXLAコンパイラを使って各種ハードウェア(TPUを含む)上で効率よく動かせるようになるのですopensource.googleblog.com。
#XLAコンパイラ自体は、TensorFlow向けに開発が開始された独自コンパイラですが、Google内部ではTPUの性能を最大限引き出すために不可欠な存在でした。XLAは計算グラフ全体を把握して全体最適なコード生成を行うことができます。具体的な最適化例としては、演算の融合 (operator fusion) によるメモリアクセス削減、レイアウト最適化によるデータ局所性向上、スケジューリングによるピークメモリ使用量削減や通信隠蔽などが挙げられますopensource.googleblog.com。例えばTPU上では、行列演算→活性化関数→次の行列演算といった一連のオペレーションを一つにまとめて巨大なカーネルとして実行し、中間データをメモリに書き戻さないようにしますcloud.google.com。これによりメモリ帯域の節約とMXUのフル活用が図れます。またXLAにはSPMD分割の自動化(前述のGSPMD)も組み込まれており、大規模モデルを複数デバイスに分散する際のパーティショニングと通信挿入も自動でこなしますopensource.googleblog.com。さらに特定のモデル・ハードウェア組み合わせに対しては、XLAによる一般最適化の上にカスタムカーネルを差し込む仕組みもありますcloud.google.comcloud.google.com。たとえばGoogleはPallasという仕組みで、JAXやPyTorch上からCUDAやDSL(Tritonなど)で記述した専用カーネルを組み込めるようにし、ボトルネック演算をチューンする手段も提供していますcloud.google.comcloud.google.com。このように**「一般的なコンパイラ最適化 + 必要に応じカスタム最適化」**という二段構えで、TPU上でのモデル実行を高速化しているのですcloud.google.comcloud.google.com。
#OpenXLAがもたらした大きな変化の一つは、PyTorchやJAXといったフレームワークからTPUをシームレスに利用できるようになったことです。かつてTPUは主にTensorFlow (Google) もしくはJAX (Google内部)からしか使えず、PyTorchユーザにとってハードルが高いものでした。しかし現在ではPyTorch/XLAというオープンソースのツールキットが整備され、PyTorchのモデルをほぼそのままTPU上で実行できますdocs.pytorch.org。PyTorch/XLAはPyTorchのPythonフロントエンドとXLAコンパイラの間のブリッジとして機能し、PyTorchの演算呼び出しをXLAのHLOグラフに変換してコンパイル・実行する仕組みですdocs.pytorch.orgdocs.pytorch.org。特徴的なのはLazy Tensorと呼ばれる仕組みで、演算命令を逐次実行する代わりにまず計算グラフ(IR)として蓄積し、必要になった時点でXLAに渡してコンパイルするという方式を取りますdocs.pytorch.org。これにより余分なデータ転送や同期をまとめて最適化でき、高効率なバイナリを生成してTPU上で実行できますdocs.pytorch.org。PyTorch/XLAを使えば既存のPyTorchコードにごく僅かな修正を加えるだけでTPUを活用できるため、研究者・開発者にとってTPU利用のハードルが大きく下がりましたdocs.pytorch.orgdocs.pytorch.org。Google自身もこの流れに沿って2023年頃から「TPUでPyTorchをネイティブ動作させる」取り組みを強化し、Lazy Tensor経由ではなくPyTorch 2.0のDynamo + OpenXLAを統合する形で、より使いやすく高性能なソリューションを提供し始めていますnews.futunn.com。加えて、GoogleはTPUを外部提供するにあたりStableHLOやOpenXLAを通じてCUDAエコシステムとの差を埋める努力も続けていますnews.futunn.comnews.futunn.com。最近ではTPU上での推論向けにvLLMやSGLangなどのオープンソースプロジェクトにもコードを寄与し、PyTorch以外のエコシステムにもTPU最適化の恩恵を広げていますnews.futunn.com。
#総じて、OpenXLAとStableHLOは**「ソフトウェアとハードウェアの橋渡し役」として機能し、開発者が高水準のフレームワークを使いながらもTPUの持つポテンシャル(高い計算性能とスケーラビリティ)を発揮できるようにしています。これらのコンパイラ技術なしには、TPUという特殊なハードウェアを一般ユーザが使いこなすことは困難**でした。逆に言えば、Googleはソフトとハードを一体最適化(co-design)することで初めてGPUに匹敵する汎用性と使い勝手をTPUにもたらしたのですcloud.google.comcloud.google.com。
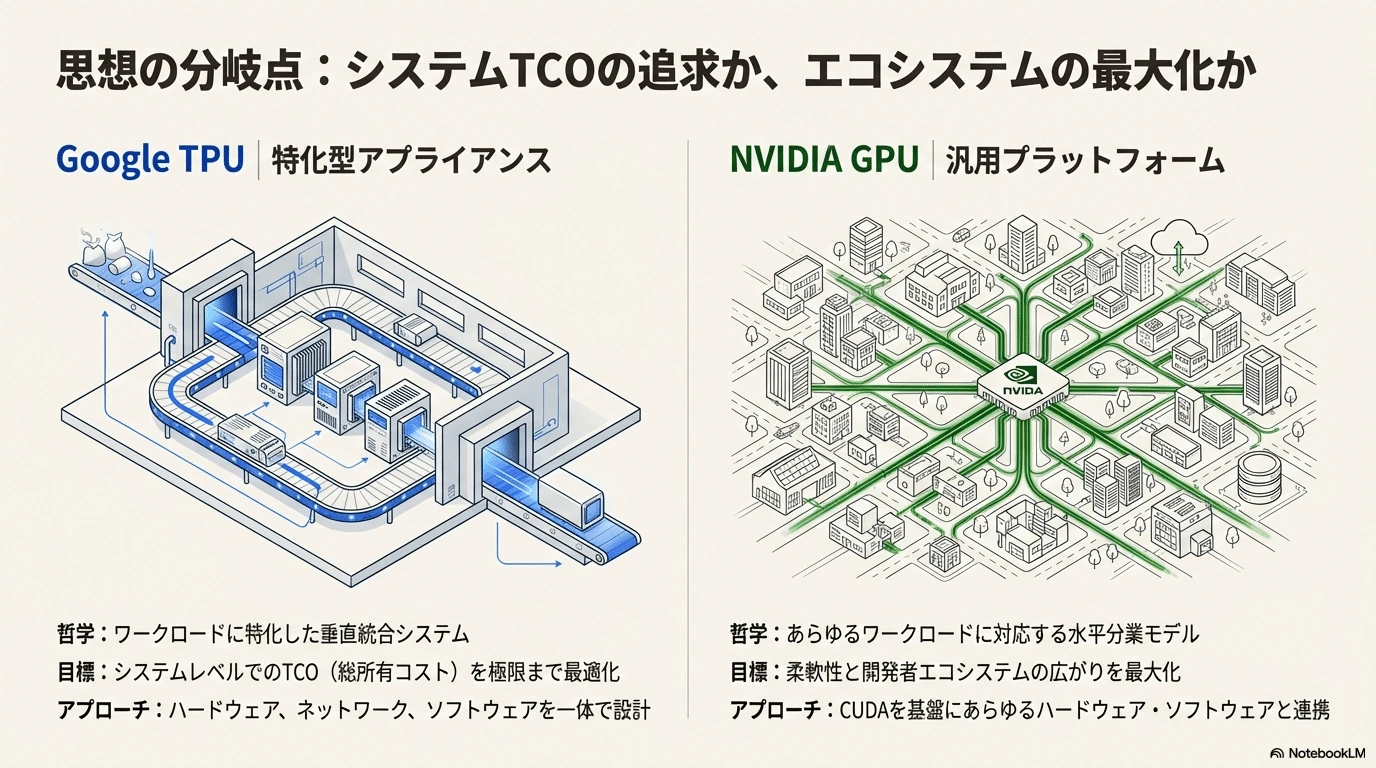
#\6. 「NVIDIAは汎用プラットフォーム、TPUは特化型アプライアンス」議論 - 動的形状や分岐処理に見る違い
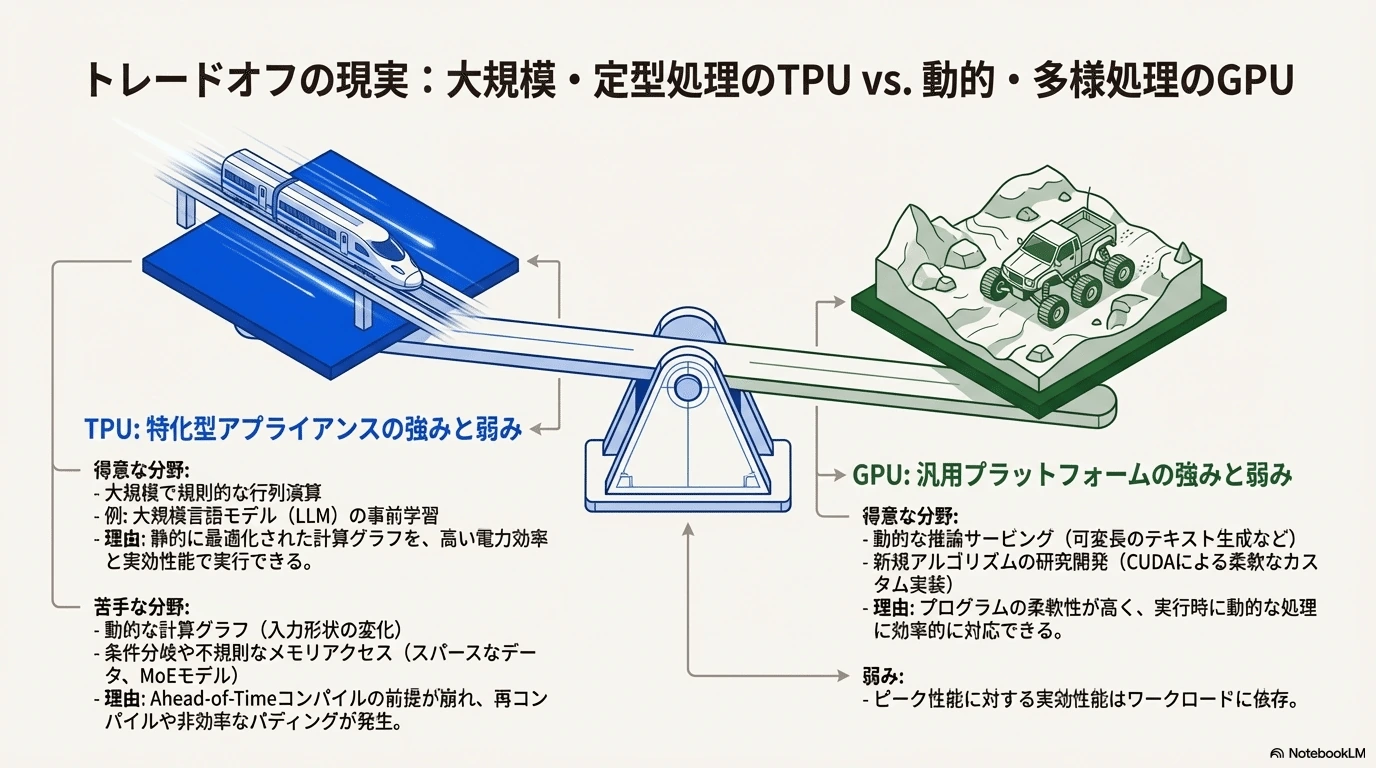
#しばしば指摘されるように、TPUは特定のワークロードに特化した専用機器であり、NVIDIA GPUはより汎用性の高いプラットフォームだと言われますreddit.com。技術的な観点から、その代表的な例が動的な計算グラフや可変長のデータに対する処理です。TPUは前述の通りAhead-of-Timeコンパイルが基本で、一度コンパイルした実行プランは入力のサイズや分岐パターンが変わらない前提で最適化されていますhenryhmko.github.iohenryhmko.github.io。そのため、入力データの形状が逐次変化したり、実行中に条件分岐で処理経路が変わるような動的なワークロードはやや苦手としています。実際JAX/TPUでは、@jitでコンパイルした関数に異なる形状の入力を与えると都度再コンパイルが必要になり、動的パディングや入力依存のループを含む処理は効率が落ちる傾向がありますhenryhmko.github.io。一例として大規模言語モデル(LLM)のテキスト生成推論を考えると、各サンプルの出力長(生成されるトークン数)は異なりますが、TPU上では最大長に合わせてパディングしたバッチをまとめて処理する必要があり、短い系列のためにも無駄な演算が走ってしまうケースがあります。この問題に対処するため、最近ではStableHLOが動的形状をサポートし、XLAも動的パディングに対処する機能が拡充されつつありますがopensource.googleblog.com、根本的には**「静的に最適化された計算グラフを高速に実行する」**というTPUの基本思想からくる制約と言えます。
#また条件分岐や不規則な計算パターンもTPUの不得手分野です。TPUのコア(シストリックアレイ)は一斉に同じ計算を繰り返すには非常に効率的ですが、処理する要素ごとに実行内容が変わるような場合、柔軟に対応できるプログラム可能コアに比べて効率が大きく低下しますreddit.com。典型例がスパース(疎)なデータや**Mixture-of-Experts (MoE)**のようなモデルです。シストリックアレイは入力行列内にゼロが多くても全要素について演算を行ってしまうため、スパース演算で本来計算不要な部分にも計算リソースを割いてしまいますhenryhmko.github.io。一方GPUは条件に応じて分岐したり演算をスキップしたりできます(SIMD幅内ではマスクされ無駄は出ますが、それでもTPUより細かな制御が可能です)。またMoEのように入力ごとに異なる専門家ネットワークに振り分けるモデルでは、TPU上で動的に異なる演算パスを取るのは難しく、事前に最大パス数分だけ演算を用意しておき実行時に不要パスを潰す(無駄な演算をする)ような実装になりがちです。対照的にGPUなら、分岐先ごとにスレッドを分けて実行することも可能であり、プログラムの柔軟性という点で優れていますreddit.comreddit.com。
#さらにカスタム演算の実装容易性にも差があります。新しいAI手法やレイヤーが登場した際、GPUであればCUDA C++でカスタムカーネルを書いたり、Python実装でもそれなりに動かすことができます。しかしTPUではXLAコンパイラがサポートしない演算は動作させるのが困難で、極端な場合にはTPU用に演算アルゴリズム自体を作り直す必要が出てきますreddit.com。研究段階のモデルはまずGPU上で実装・検証されることがほとんどであり、「新手法への追随の速さ」という観点でもGPUの方が有利ですreddit.comreddit.com。TPUサポートが整う頃には研究コミュニティはさらに先へ進んでいる、といった事態も起こりえますreddit.com。
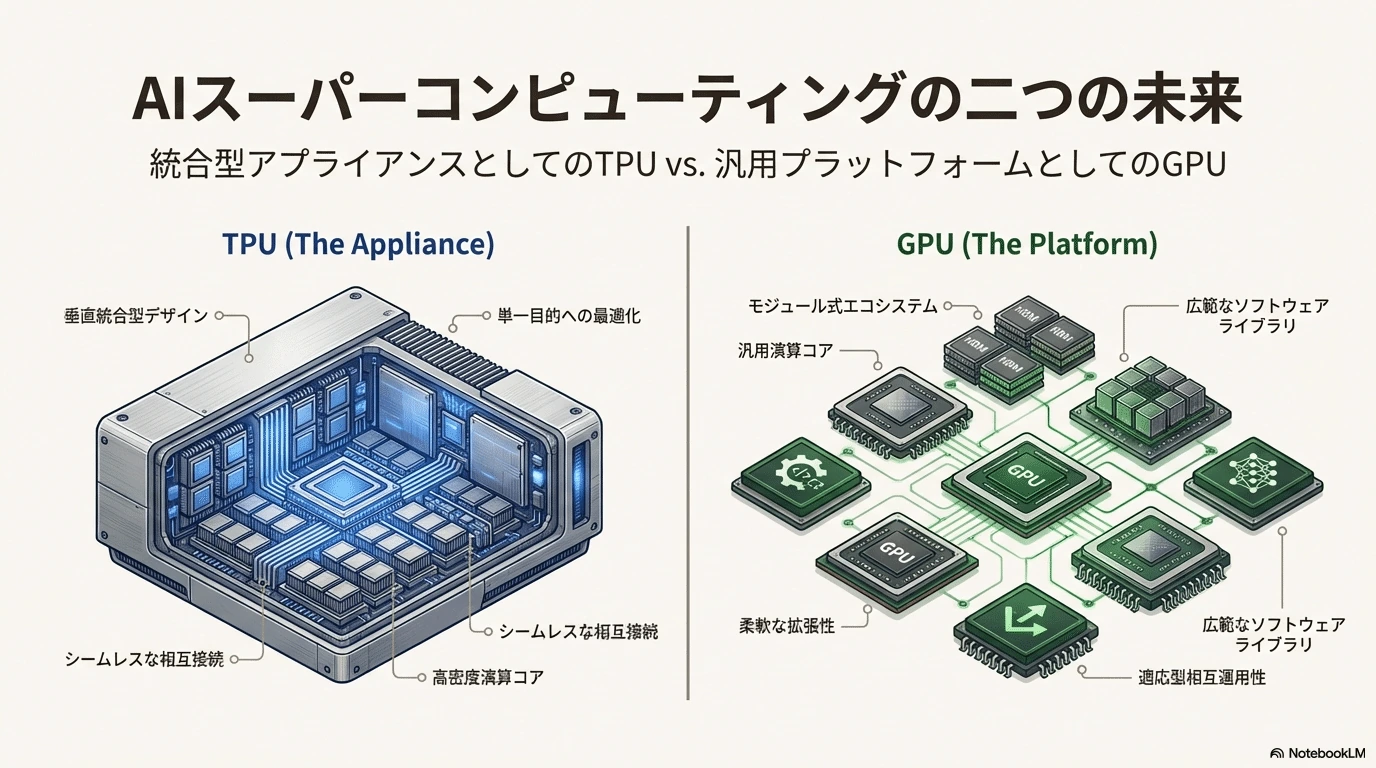
#以上のように、TPUとGPUは一長一短があります。TPUは特定パターンの処理(大規模で規則的な並列演算)に対しては圧倒的な性能と効率を発揮しますが、汎用性や柔軟性ではGPUに軍配が上がりますreddit.com。言い換えれば、TPUは**「AI専用アクセラレータ(アプライアンス)」としてピーク性能とTCOを追求した設計であり、GPUは「汎用並列計算プラットフォーム」として幅広いタスクに対応できる設計です。それゆえ、例えば大規模LLMの事前学習のように計算が画一的で莫大なリソースを要する部分はTPUが得意とし、一方動的な推論サービングや新規アルゴリズムの試行**などはGPUの方が扱いやすい、という状況が生まれています。このギャップを埋めるために、ソフトウェア側でTPUをより汎用的に使う工夫(StableHLOで動的制御をサポートする等)や、GPU側で特定ワークロード向けの最適化(Transformer Engineによる低精度最適化等artificialintelligencemadesimple.com)が進められており、今後も両者のアプローチは互いに影響を与え合っていくでしょう。
#\7. デュアルスタック(TPU+GPU併用)運用の難しさとGoogle GeminiにおけるTPU活用
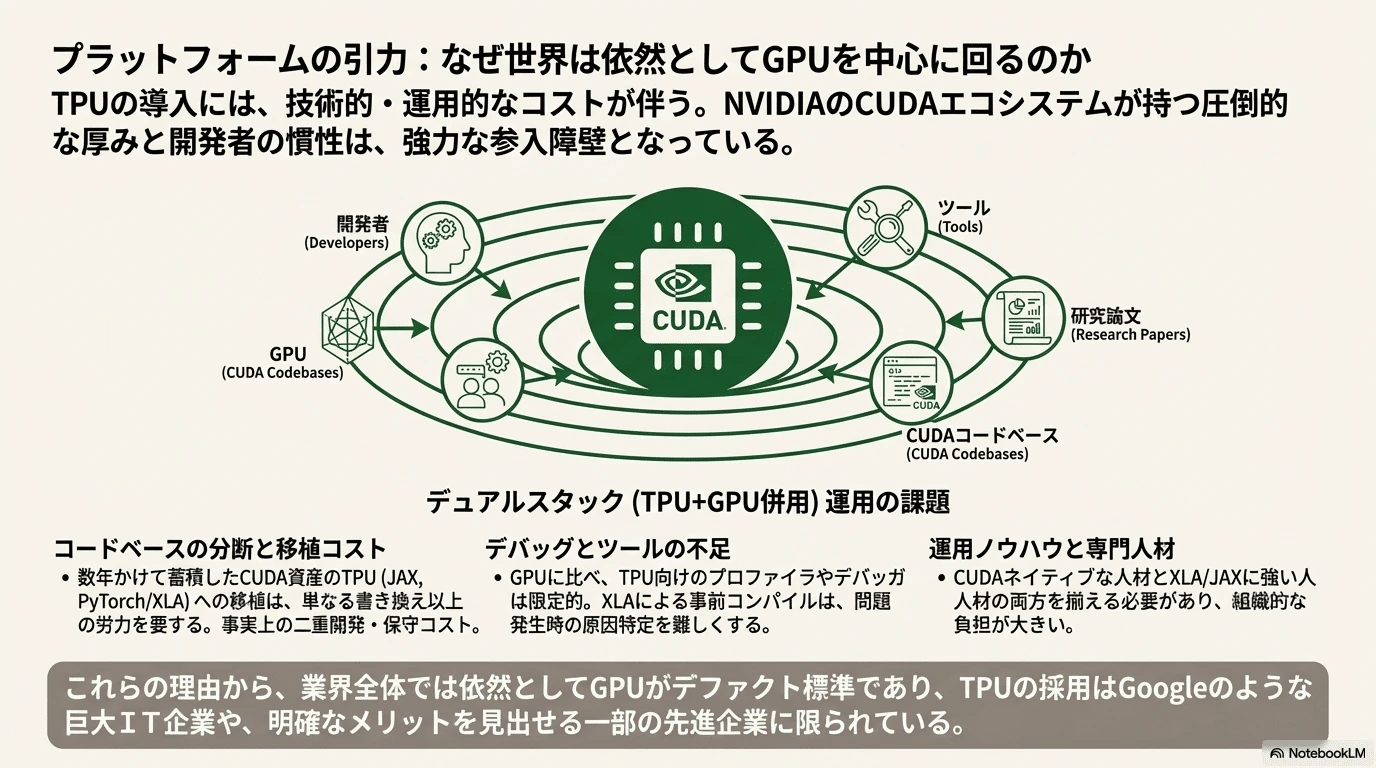
#最後に、組織やプロジェクトにおいてTPUとGPUを併用(デュアルスタック)する場合の課題について考察します。TPUとGPUは前述のようにハードウェアアーキテクチャもソフトスタックも大きく異なるため、両方を同時に運用することは技術的・運用的コストが高くなりがちです。主な難点としては以下のようなものがあります。
#- コードベースの分断と複雑化: GPU向けにはCUDAやそれに基づくライブラリ群(cuDNN, NCCL, TensorRTなど)が成熟していますが、TPUではXLAコンパイラやTPU専用ライブラリを使う必要がありますreddit.comreddit.com。既存のCUDA向けコードや最適化をTPU向けに移植(ポーティング)するには、フレームワークをJAXもしくはPyTorch/XLAに書き換え、性能チューニングをやり直し、必要なら独自オペレーションを実装し直す、といった手間がかかりますreddit.com。これは数年かけて積み上げたCUDA資産を持つチームにとって容易ではなく、事実上二重の開発・保守コストを強いることになりますreddit.com。
- デバッグとツールの不足: GPU分野では統合開発環境やプロファイラ、デバッガ等のエコシステムが充実していますが、TPU向けの開発ツールは限定的です。XLAによる事前コンパイルは人間に読みにくい最適化コードを生成するため、不具合発生時に原因を突き止めるのが難しい場合があります。TPUプログラミングに不慣れなチームがGPUとTPUの両対応コードを書けば、デバッグに倍の時間がかかるリスクがあります。
- 運用コストと専門知識: GPUインフラは広く普及しておりクラウドやオンプレでもノウハウがありますが、TPUクラスターの自前運用例は限定的です(Googleや一部研究機関を除き、TPU Podは主にGoogle Cloud上で提供される形です)。そのためTPUを導入すると、新たな知見を持つ人材の確保や学習が必要になります。複数プラットフォームの混在運用はオペレーションも複雑化し、例えばソフトウェア環境の管理(異なるコンパイラやライブラリの共存)、ジョブスケジューリングの最適化(TPUとGPUでキューが別々になる)など考慮すべき点が増えます。組織としても、CUDAネイティブな人材とXLA/JAXに強い人材の両方を揃える必要が出てきますreddit.com。
以上の理由から、GoogleやMetaのように大規模リソースを持つ企業以外では、TPUを導入するハードルは依然高いとされていますreddit.com。実際、業界全体では依然GPUがデファクト標準であり、TPUは特定の先進企業やクラウドサービス提供分野に限られているのが現状ですreddit.com。Google自身、これまで内部利用が中心だったTPUを外部提供するにあたり、PyTorch対応やオープンソースへの寄与などソフト面でハードルを下げる努力をしていますがnews.futunn.comnews.futunn.com、それでもなおCUDAエコシステムの厚みには及びません。したがって、両方のプラットフォームを併用する“デュアルスタック”戦略は、よほど明確なメリット(例えば特定ジョブでTPUが圧倒的有利など)が無い限り運用コストに見合わない可能性が高いのです。
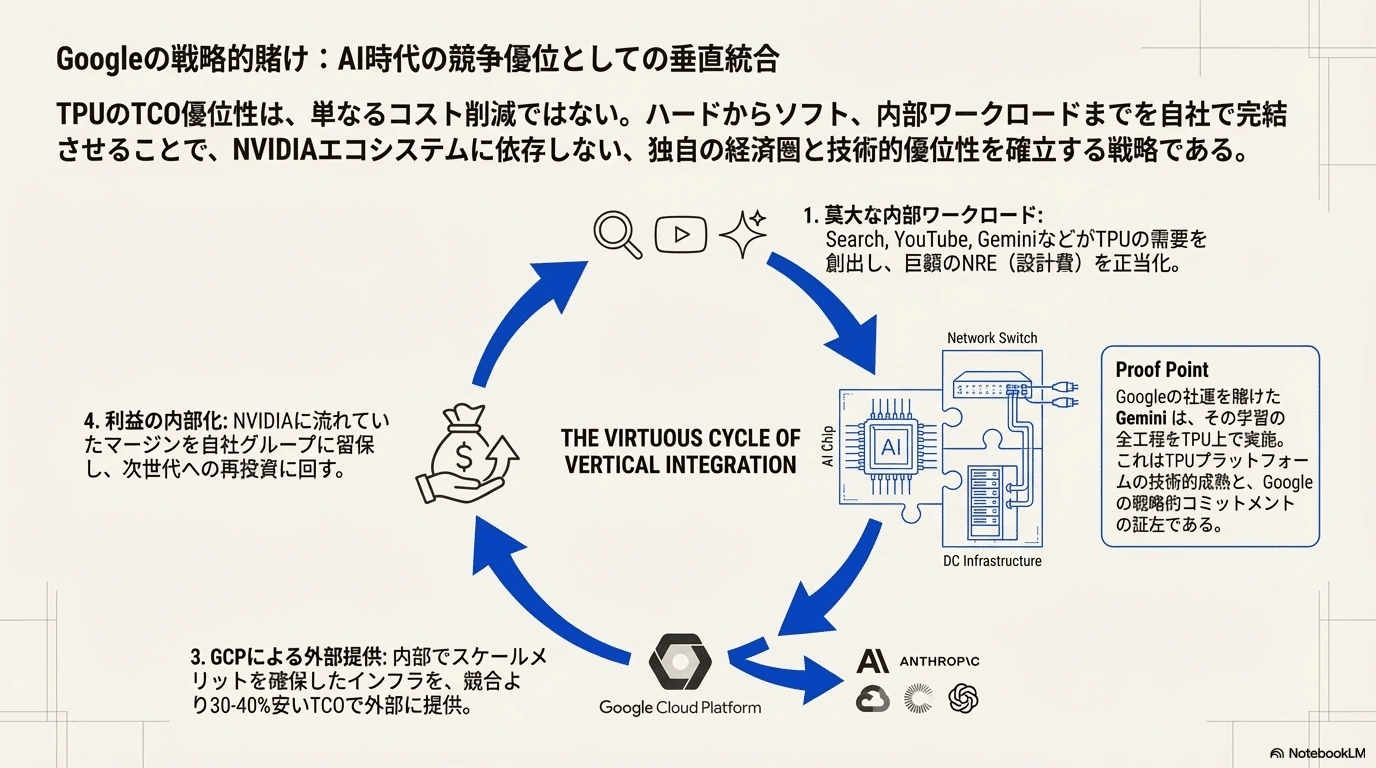
#では、現在Googleが開発している最先端AIモデル**「Gemini」はこの点どうなのでしょうか。GeminiはGPT-4に対抗するとされる大規模多機能モデルで、その学習にはGoogleのTPUが全面的に活用されていますnewsletter.semianalysis.com。SemiAnalysisのレポートによれば、最新のGemini 3モデルは過去のバージョン同様**、学習の全工程をTPU上で実施しており、これはTPUプラットフォームの技術的成熟を示す何よりの証拠となっていますnewsletter.semianalysis.comnews.futunn.com。実際、GeminiやClaude 4.5など現在世界トップクラスのモデルがTPUでフル訓練された事実は、「フロンティアモデルの学習」のような最も困難なタスクをTPUが成し遂げたことを意味しますnews.futunn.com。Googleは社運を賭けたGeminiにおいて、あえてGPUではなくTPUを用いる道を選びましたが、それは自社のTPUインフラが性能的にもコスト的にも十分競争力があると判断したからに他なりませんnews.futunn.comnews.futunn.com。Gemini開発では研究者とハードウェア・ソフトウェアチームが密接に協力し、TPU向けにモデル実装を最適化することで最高の性能を引き出しています。これは容易なことではありませんが、Googleのように両方の専門性を社内に持つ組織だからこそ可能となったアプローチです。
#もっとも、Googleほどの規模でなければ、このような**「TPUオンリー戦略」を採るのは難しいでしょう。一般企業にとっては、TPUを導入するだけでも冒険であり、GPUと併用するとなればなおさらです。Geminiの成功例は、TPUが適切な環境下ではGPUに匹敵しうるどころか凌駕するパフォーマンスを発揮できる可能性を示しましたnews.futunn.comnews.futunn.com。しかしその裏には、Googleによるソフトウェアスタックの大改革(PyTorch対応やオープンソース化)や、Anthropicなどパートナーとの協業によるスケールメリットなど、相当の投資と努力がありますnews.futunn.comnews.futunn.com。Geminiがどの程度TPU“のみ”で運用されているか公式な詳細は明かされていませんが、少なくとも学習フェーズはTPUで完結しており、推論提供に関してもGoogle CloudのTPUベースAIハイパークラスター上で行われていると推測されます。Googleにとっては、ハードからソフトまで自社で垂直統合したTPUプラットフォームこそが競争優位**であり、敢えてNVIDIA GPUに頼らない戦略を選んでいるわけです。
#以上、(1)~(7)までGoogle TPUとNVIDIA GPUのアーキテクチャ上の違い、特にTPUv7 Ironwoodの光接続とスケーラビリティ、演算コア(GEMMエンジン vs Tensor Core)、メモリ一貫性の設計哲学、CPUとの協調、OpenXLAによるソフト面の橋渡し、動的ワークロードへの適性、そしてデュアルスタック運用の現実について技術的に比較・考察しました。それぞれのプラットフォームには得意不得意があり、使い分けや統合には深い知見が求められます。しかし最終的には、「システム全体で最良の性能と効率を引き出す」ことが目的であり、Google TPUの設計思想はまさにシステムレベルでの最適化に重きが置かれている点が印象的ですnews.futunn.com。今後もNVIDIAとGoogleのアプローチの競い合いから、AIインフラの技術革新が進んでいくことでしょう。
##
TPU/Broadcom vs NVIDIA GPU のコスト構造
#TPU/Broadcom vs NVIDIA GPU のコスト構造をざっくり一言で言うと、
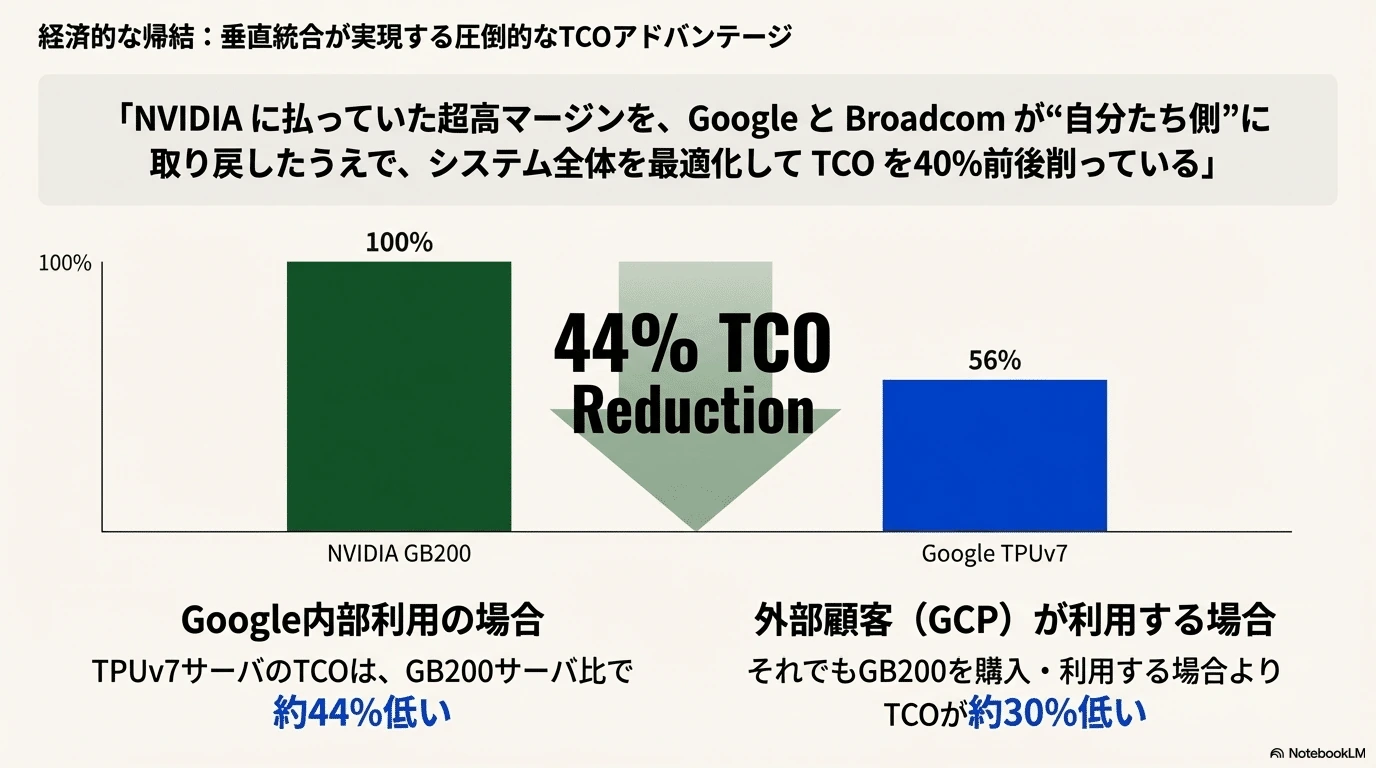
#「NVIDIA に払っていた超高マージンを、Google と Broadcom が“自分たち側”に取り戻したうえで、システム全体を最適化して TCO を40%前後削っている」#
という構図です。
#以下、もう少し丁寧に分解していきます。
##
\1. プレイヤーとビジネスモデルの違い
#NVIDIA GPU 側
#- H100 / B100 / GB200 / GB300 などの GPU や NVLink/NVSwitch、InfiniBand スイッチまで NVIDIA が一式売る。
- 直近決算で GAAP ベースの粗利益率は約 78%。データセンター製品単体では 75%を超えるとされます。(Klover)
→ GPU サーバの TCO は、電力や運用より「GPU Capex」が圧倒的に支配的。
- SemiAnalysis の試算では、H100 サーバの月あたりコストは
- 設備(Capex)約 7,025 ドル
- ホスティング(電力・ラック・運用など Opex)約 1,871 ドル
→ 合計 TCO を決めているのはほぼ GPU 本体の価格。(newsletter.semianalysis.com)
#GPU クラウドや他のハイパースケーラーは、この「NVIDIA の高マージン込みの価格」からスタートするため、自分たちがいくら効率の良いデータセンターを作っても、TCO の大部分は NVIDIA の値付けに支配されてしまう構造です。
##
Google TPU 側(Google × Broadcom)
#- アーキテクチャ設計: Google(TPU v1〜v7, Trillium など)。
- 論理設計・物理設計・サプライチェーン統合: 主に Broadcom のカスタム ASIC 部門。
- 製造: TSMC(先端ノード)、HBM は Samsung / SK hynix など。(newsletter.semianalysis.com)
- 英国 CMA の調査報告でも、**「TPU は Google が Broadcom と共同開発し、Broadcom が製造・供給している」**と明記。(政府出版サービス)
ビジネスモデルは概ね以下の形と考えられます(数字は公開されていないので構造だけ):
#- Google → Broadcom
- 世代ごとの NRE(設計費・マスク費など)を前払い/契約。
- 量産フェーズでは「ウェハ+HBM+パッケージ+テスト+Broadcom マージン」を含む コスト+マージン型の単価で TPU ダイを購入。
- Google の内部利用
- TPU ラック/Pod 全体を自社データセンターに展開し、Search / Ads / YouTube / Gemini / Maps など社内ワークロード&GCP に供給。
- 「GPU ベンダーへのマージン」を払わなくて済むので、その分が丸ごと Google 側の経済圏に残る。
- 外販パターン
- GCP 経由で「TPU-as-a-Service」として時間課金で提供。
- さらに TPUv7 では Broadcom が完成ラックを外部(Anthropic)に直接販売する形も登場(約 40 万個の TPUv7 を約 100 億ドル相当で販売と報じられている)。(富途新闻)
Broadcom 側は、Apple や Meta などと同様の「カスタム ASIC 受託ビジネス」として大口かつ長期契約を確保し、Google は「NVIDIA ではなく Broadcom にだけ一段のマージンを払う」構造になります。
#SemiAnalysis は、
#「Google は Broadcom 経由で自社チップを取得するため、NVIDIA のような高マージンを払わずに済み、支払うマージンは『かなり低い』」(newsletter.semianalysis.com)#
と評価しています。
##
\2. TPUv7 vs GB200:TCO の定量比較(公開情報ベース)
#SemiAnalysis の最新レポート(Futu 経由要約)では、TPUv7「Ironwood」と NVIDIA GB200 をサーバレベルの TCOで比較しています:(富途新闻)
#- Google 内部視点(自家消費):
- TPUv7 サーバの TCO は GB200 サーバ比で約 44%低い。
- Anthropic のような外部顧客が GCP 経由で借りる場合(Google+Broadcom+GCP 利益込み):
- それでも GB200 を購入・利用する場合より TCO が約 30%低い。
- GB300 NVL72 との比較では、さらに大きな差(約 40%超の優位)とされる。
つまり、
#「Broadcom にも Google にも利益を出しつつ、それでも NVIDIA GPU より 3〜4割 TCO が安い」#
というかなり強烈な数字が出ています。
#なぜこんな差が出るのかを、コスト構造から分解します。
##
\3. コスト構造の分解:どこで差がつくか
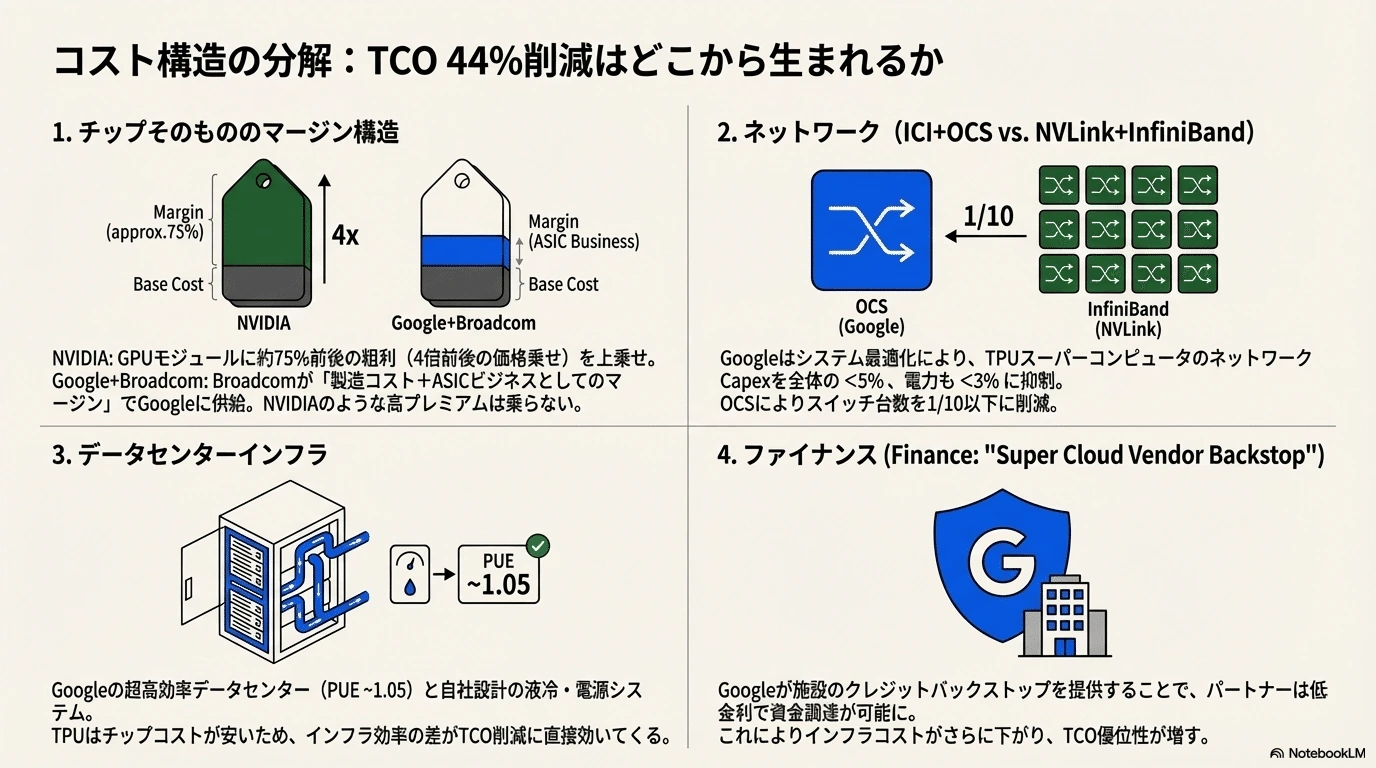
#3-1. チップそのもののマージン構造
#NVIDIA
#- 1枚あたり数万ドル級の H100/B100/GB200 モジュールに対し、**おおよそ 4 倍前後の価格乗せ(約 75%前後の粗利)**を取っていると SemiAnalysis は推定。(富途新闻)
- さらに、NVSwitch・InfiniBand スイッチ・NIC といったネットワーク製品にも高いマージンを上乗せ。
- 結果として、「チップ+ネットワーク」の層だけでとんでもない利益」が NVIDIA に集中。
Google + Broadcom(TPU)
#- Broadcom はカスタム ASIC ビジネスとして、TPU ダイに対し「製造コスト+α(ASIC ビジネスとしては高めだが、NVIDIA GPU よりはるかに低いマージン)」を乗せる。(富途新闻)
- SemiAnalysis は、
- 「チップの BOM の中では Broadcom がかなり大きな利益を取っているが、それでも NVIDIA の 4x マークアップよりは低く、なお Google 側にも GPU クラウド案件より良い EBIT マージンが残る」(富途新闻)
と分析。
- 要するに、
「チップ単価=TSMC+HBM+パッケージ+Broadcom の modest なマージン」 という構造で、NVIDIA のような“ブランド GPU プレミアム”が乗っていない。
#この段階で、1チップあたり数十%レベルでコストが安いと推定され、それがサーバ TCO 44%差の大きな源泉になっています。
##
3-2. ネットワーク(ICI + OCS)vs NVLink + InfiniBand
#ここが Google の「システム設計としての縦割り最適化」の真骨頂です。SemiAnalysis の TPUv4 分析から:(newsletter.semianalysis.com)
#- TPUv4 では、
- 64 チップの「スライス」までは銅ケーブル(DAC)で直結し、
- その先は 自社開発の Optical Circuit Switch(OCS)+光リンクで接続。
- 4,096 チップ級の TPUv4 Pod を構成する際、
- Google は OCS 48 台で済むのに対し、
- 同規模の 4,096 GPU クラスターを NVIDIA で組むと、InfiniBand スイッチが約 568 台必要と試算。
- OCS はスイッチ単体では
- NVIDIA の InfiniBand スイッチより 3.2〜3.5 倍高価(小売価格ベース)、
- 製造原価ベースで比較すると 12.8〜14 倍も高いとされる。
それでも、
- 必要台数が ≒1/12 で済むうえ、
- 光電変換を減らして消費電力も削減できるため、
→ ネットワーク全体としての Capex では TPU 側が有利か、ほぼ同等。
- Google は、
「TPUv4 スーパーコンピュータにおいて、ネットワークの Capex は全体の <5%、電力も <3%」 に抑えられていると主張。(newsletter.semianalysis.com)
#これを TPUv7 Ironwood ではさらに強化し、
#- ICI + OCS + 3D Torus ネットワークにより、
- 1 Pod あたり 9,216 チップまでスケール可能、
- OCS による光学スイッチングでトポロジーをソフトウェア的に動的再構成、故障チップを迂回しつつ 3D torus を保つ。(富途新闻)
対して NVIDIA の Blackwell/GB200/NVL72 では、
#- NVLink スケールは 72GPU(NVL72)〜数百 GPU レベルが実質限界で、そこから先は InfiniBand/Ethernet などの階層的な Clos ネットワークへ。(Reddit)
- スイッチ段数が増えるほど、
- スイッチ台数
- 光トランシーバ本数
- 光電変換の回数
が増え、ネットワークの Capex と電力が跳ね上がる。
#まとめると:
#NVIDIA:GPU は高マージン、ネットワークは多段スイッチなので規模を伸ばすほどネット側のコストも増えやすい。
Google:チップは“コスト+α”、ネットワークは OCS で段数・台数を極限まで削って、ネットワーク Capex を <5%に抑える。
#ここでも **「いかにネットワークを安く・効率よく作るか」**というシステム視点で、Google は GPU スタックより 10%〜20%単位の追加のコスト差を積み上げています。
##
3-3. データセンター全体(PUE・電力・運用)
#SemiAnalysis の TCO モデルでは、GPU サーバでは
#- 「ホスティングコスト(電力+ラック+冷却+運用)」は月 1,871 ドル、
- Capex が 7,025 ドルと比べると二次的な項目。(newsletter.semianalysis.com)
ただし Google のようなハイパースケーラーは、
#- PUE ~1.05 付近まで追い込んだ超高効率データセンター
- 自社設計の電源・冷却・ラック・液冷システム
を持ち、Colo などより大幅に安く建てられるとされています。(newsletter.semianalysis.com)
#GPU サーバの場合は、
#「どう頑張っても TCO の 7〜8割は NVIDIA に払う Capex」#
なので、この PUE/インフラ効率の差は TCO 全体の中での重みが小さいですが、TPU の場合は元のチップコストが安いので、このインフラ効率の差が素直に TCO 削減効果として効いてくる、という構図になります。
##
3-4. ファイナンス面:Super Cloud Vendor Backstop
#SemiAnalysis が指摘している、TPUv7 の TCO 優位を支えているもう一つのカギが「Super Cloud Vendor Backstop」と呼ぶ金融スキームです。(富途新闻)
#- AI クラスターの経済寿命:4〜5年
- データセンターリース・電力契約:15 年クラス
という 期間ミスマッチ のせいで、中小の GPU クラウドやマイナーは資金調達に苦しみます。
#Google はここに対して、
#- マイナーやコロケーション事業者が建てた施設に TPU ラックを置く際に、
- **「もし借り手が家賃を払えなくなったら Google が肩代わりする」**という形のクレジットバックストップを提供。
- これにより、金融機関から見たリスクが激減し、低金利で資金調達して安くデータセンターを建てられる。
このおかげで、
#- TPU ラックのインフラコストがさらに下がる
- その TPU を GCP と外部顧客(Anthropic など)とでシェアすることで、設備稼働率を非常に高く維持できる
→ 結果として、TCO/有効 FLOP がさらに GPU より有利になる、という循環です。(富途新闻)
#NVIDIA GPU だけを買う GPU クラウド事業者は、このような「クラウドベンダー自身による信用補完」を持たないので、金利・デフォルトリスクを織り込んだ TCO になります。ここも垂直統合のメリットです。
##
\4. Broadcom との分業と収益配分
#SemiAnalysis/Futu 要約と他報道を組み合わせると、Broadcom–Google–顧客の収益構造はだいたい次のような感じと考えられます:(富途新闻)
#- Google ↔ Broadcom
- Google が世代ごとの NRE を支払い、最低発注数量をコミット。
- Broadcom は ASIC 開発・量産・ラック化までを請け負い、チップレベル BOM 上で「比較的大きいが、NVIDIA ほどではないマージン」を取る。
- Broadcom ↔ エンドユーザー(Anthropic)
- TPUv7 ラック 40万台分を約100億ドルで直接販売(=Broadcom がハードウェア販売の利益を取る)。
- Google ↔ エンドユーザー(Anthropic、Meta、OpenAIなど)
- 残り 60 万個の TPUv7 を GCP を通じて時間課金で提供。
- ここで Google は、
- Broadcom から買ったハードウェアに自らのクラウドマージンを乗せる
- それでも GB200/GB300 ベースの GPU クラウドより 30〜40%安い TCO を提示できる
と SemiAnalysis は見積もっています。(富途新闻)
#NVIDIA の場合、
#- NVIDIA が GPU+ネットワークで超高マージンを取る
- その上に GPU クラウドやハイパースケーラーがクラウドマージンを載せる
という「二段構えのマージン」ですが、
#TPU スタックでは、
#- チップマージン: Broadcom
- クラウドマージン: Google
と“自陣営”の中で完結し、しかも総額では NVIDIA スタックより低い。 この構造が、
#「TPUv7 の TCO が GB200 比で 44%安いのに、Google も Broadcom もちゃんと儲かる」#
という、垂直統合型の美味しい状態を生んでいます。
##
\5. NVIDIA GPU TCO と比べた Google 垂直統合の競争優位性
#ここまでの話を、TCO 観点で整理すると:
#5-1. TCO の内訳イメージ(大規模 LLM トレーニング・推論クラスター)
#(※割合は概念的イメージ)
#NVIDIA GPU スタック(GB200/GB300 NVL72 クラス)
#- GPU/NVLink/NVSwitch/ネットワーク機器:TCO の 70〜80%
- うち NVIDIA の粗利が 50%ポイント以上。
- データセンター建設・電力・冷却・運用:20〜30%
- ソフトウェア開発・オペレーション:数%(人件費は別勘定)
Google TPU スタック(TPUv6/TPUv7 クラス)
#- TPU+OCS+ラック:TCO の 50〜60%
- うち Broadcom マージン+Google マージンだが、総額は NVIDIA より低い。
- データセンター・電力・冷却・運用:40〜50%
- 高効率インフラ+Backstop スキーム+稼働率最適化で絶対額も圧縮。
- ソフトウェアスタック(XLA, OpenXLA, JAX, PyTorch/XLA 等):
- 内部ツールも含めて Google 自社の固定費として回収。
結果:
#- 内部利用では TPU サーバ TCO が同世代 NVIDIA GPU サーバ比で ~40〜45%安い。(富途新闻)
- 外部提供(GCP)でも、GB200/GB300 より ~30〜40% TCO が安い価格を提示しつつ、Google も十分な利益を確保。
#
5-2. 垂直統合アプローチの経済的メリット(まとめ)
#- Vendor Margin の内部化
- 本来 NVIDIA が持っていくはずの GPU マージンの大部分を、
Broadcom+Google という“味方サイド”で分け合える。
- システム最適化(ネットワーク&トポロジ)
- OCS+3D Torus により「必要スイッチ数」「光電変換」「ケーブル本数」を削減し、
ネットワーク Capex を <5% に抑えることで全体 TCO をさらに削る。(newsletter.semianalysis.com)
- PUE とインフラ効率
- 高効率データセンター+液冷+ラック設計まで含めた最適化で、
電力当たりの TFLOP や TB/s を最大化。
- ファイナンス(Super Cloud Vendor Backstop)
- 期間ミスマッチを Google の信用で埋めることで、低金利で巨大クラスターを調達しつつ、
内部・外部の両方のワークロードで高稼働率を達成。
- ワークロード&ソフトウェア縦統合
- Search/Ads/Gmail/Maps/Gemini/YouTube など、莫大な内部ワークロードを TPU に集約できるため、
世代交代ごとの NRE やツール開発コストを十分に回収できる。
- OpenXLA/StableHLO や PyTorch ネイティブサポートを進めることで、外部顧客も取り込みやすくなり、スケールメリットがさらに増幅。(富途新闻)
#
5-3. もちろん弱点もある
#公平に見ると、Google 方式にも制約はあります:
#- 膨大な初期投資とスケール前提
- NRE+インフラ+ソフトウェア整備に「数十億〜百億ドル」レベルの投資を 4〜5年サイクルで回す必要があり、真似できるのは GAFA 級だけ。
- アーキテクチャ外した時のリスク
- TPUv4i が PaLM のような大型 LLM 推論に向かなかった事例のように、アーキテクチャのミスは丸ごと自社が被るリスク。(newsletter.semianalysis.com)
- 汎用性・エコシステムでは NVIDIA 優位
- GPU はオンプレからあらゆるクラウドまで、研究〜ゲーム〜HPC まで使われる「汎用 GPU エコシステム」。
- TPU は基本 GCP と一部の直販先のみで、長期的な中古市場や転用先は GPU より限定される。
- Broadcom 依存リスク
- シリコン実装を Broadcom にほぼ一本化しているため、Broadcom 側の価格交渉力が高まるリスクも存在。
とはいえ、現時点の公開情報ベースでは、
#大規模 LLM/RecSys のような TPU にフィットするワークロードに限れば、TPU スタックは NVIDIA GPU スタックに対して 30〜45%程度の TCO 優位を持ち、その利益を Google と Broadcom が分け合える構造になっている#
と評価するのが妥当だと思います。
##
ざっくり結論
#- コスト構造:
- NVIDIA:GPU 本体+ネットワークに極めて高いマージン → GPU サーバ TCO の大部分が「NVIDIA に払うお金」で決まりがち。
- Google TPU:Broadcom の ASIC マージンはあるが、全体としては NVIDIA よりかなり低い。加えてネットワークとインフラを徹底最適化。
- TCO 比較:
- 内部利用で TPUv7 サーバは GB200 サーバ比 約 44% 安い TCO。
- 外部顧客に GCP 経由で貸しても GB200 より約 30% 安い TCO を保ちながら Google も高い収益性。(富途新闻)
- 経済的競争優位:
- この差は単に「チップが安い」だけでなく、
ASIC 設計+ネットワーク+PUE+ファイナンス+ソフトウェアまでを含む、垂直統合&システム最適化の結果。
- 特に Anthropic や(将来の)Meta/OpenAI など「フロンティア LLM」を大量に回す顧客にとっては、同じタスクを半分程度の TCO でこなせる可能性があるため、GPU 一辺倒から TPU を含むマルチベンダー戦略へ切り替える強いインセンティブが生まれている。
#
OSCとMEMSミラー
#\1. OCS(Optical Circuit Switch)って何をしている装置か
#電気スイッチとの一番大きな違い
#普通のEthernetスイッチやInfiniBandスイッチは:
#- 光 → 電気に変換(O/E)
- パケットヘッダを見る(MAC / IP / RoCE など)
- スイッチチップ内部でルックアップ+バッファリング
- 電気 → 光に再変換(E/O)
という「O-E-O」変換をして、パケット単位で転送先を決める機械です。
#OCSはこれと全然違っていて、
#- 光信号を一度も電気に戻さず
- 「この入力ファイバ → この出力ファイバ」という“回線”を物理的に組み替えるだけ
の装置です。 GoogleのJupiter/DCネットワークの解説では、OCSを
#「2組のMEMSミラーで、N本の入力ファイバとN本の出力ファイバを任意に接続する装置」(Google Cloud)#
と説明しています。
#イメージとしては、
#- 「でっかい自動パッチパネル」
- しかも、ソフトウェアからコマンドを送ると、ミリ秒オーダーで配線を組み替えてくれる
という感じです。
#その代わり:
#- パケットを解釈しない
- バッファも持たない
- 切り替え速度はミリ秒オーダー(パケットスイッチの ns〜µs よりずっと遅い)
ので、回線交換(circuit switching)専用で、「一度つないだら、しばらくそのまま使う」前提の設計です。
##
\2. MEMSミラー型OCSの基本構造
#MEMSとは?
#MEMS(Micro-Electro-Mechanical Systems)は、
#- シリコンウェハ上に
- 微小な機械構造(バネ・梁・ミラー)
- それを動かす電極
- 必要なら簡単なセンサ回路
- をフォトリソ+エッチングで作り込んだ超小型機械デバイス
です。
#MEMS光スイッチでは、
#- シリコン基板の上に非常に小さな鏡(数十〜数百 µm)をアレイ状に並べ、
- ミラーを支える梁(ヒンジ)と、静電力などでミラーを傾ける駆動電極を作っておき、
- 電圧をかけてミラーの角度を変えることで、光ビームの方向を変えます。(Optical Passive Components)
結果として、「入力ファイバから出てきた光を、どの出力ファイバに向けるか」を選べます。
#2D MEMS vs 3D MEMS
#MEMS光スイッチには大きく
#- 2D型
- 3D型
があります。(Optical Passive Components)
#2D MEMS
#- ミラーは基本的に「倒す/立てる」の2状態(あるいは数状態)
- コリメートした光がミラー列を通過し、
- ミラーが寝ている:まっすぐスルー
- ミラーが起きている:横方向に反射して別のポートへ
- 構造は比較的シンプルですが、大規模な N×N クロスコネクトにすると配線が複雑になりがち
3D MEMS
#- ミラー1枚1枚が2軸(X/Y)方向にアナログ的に傾けられる
- 入力側と出力側で2段のミラーアレイを用意し、
- 入力ファイバ → コリメータ → 入力ミラー(角度θ₁)
- 入力ミラーが光を空間中に飛ばし、
- それを出力ミラー(角度θ₂)でキャッチして、
- 出力ファイバに反射して入れる
- という構成で、**任意の入力ポート i を任意の出力ポート j に接続できる N×N OXC(Optical Cross-Connect)**を作れます。
GoogleのJupiter論文中の図もまさにこの「2段のMEMSミラーで入力N本・出力N本を結び直す」構成を示しています。(Google Cloud)
##
\3. Google TPU v4 / TPUv7(Ironwood) でのOCSの使われ方
#TPU v4 + Palomar OCS
#TPU v4の論文と解説記事から分かる構成をざっくりまとめると:(arXiv)
#- 1つの「Cube」
- 4×4×4 = 64個のTPU v4チップ
- それぞれがTray内では電気配線(ICI)で3Dトーラス接続
- Cubeから外に出るリンク
- 6面(±X, ±Y, ±Z)× 16リンク = 96本の光ICIリンク
- これらを複数のOCS(Palomar OCS)に接続
- Palomar OCSは **136×136 ポート(128本+スペア8本)**の巨大な3D MEMS OCS
- ミラー切り替え時間はミリ秒オーダー
- 片側のファイバに対して「サーキュレータ」を使い双方向伝送(実質ポート数削減)(arXiv)
- 4096チップ級のTPU v4スーパーコンピュータでは
- 64個のCube × 96リンク = 6144本の光リンクを
- 48台のPalomar OCSでつないで、再構成可能な3Dトーラスを構成
ASCIIの解説ではさらに:
#- Palomar OCSはO-band (1260–1360 nm)、たぶん 100GBASE-FR1 系のトランシーバを想定
- Pod全体のCAPEXの5%未満、消費電力の3%未満であり、InfiniBandよりかなり安く・低消費電力とGoogleが主張(週刊アスキー - 週アスのITニュースサイト)
- O/E/O変換をせず、2枚のMEMSミラー+数枚のハーフミラーだけで光路を切り替える
と書かれています。
#※ハーフミラー+850nmレーザは、制御用の監視光路(アライメント確認)のためで、ユーザデータ用の1310nm信号とは分離されます。(週刊アスキー - 週アスのITニュースサイト)
#Ironwood(TPUv7)とOCS
#Ironwood(TPUv7)でも基本思想は同じで、
#- 1ラック = 64チップで1 Cube(電気配線 3Dトーラス)
- 複数のCubeをOCSネットワークで接続してPod/Superpodを構成
- 例)4 Cubeで256チップPod、144 Cubeで 9,216チップ Superpod
- OCSの「ファブリックマネージャ」が、故障Cubeや故障リンクを検出すると
- そのCubeを光学的にバイパス
- スペアCubeを代わりにOCS上で接続し直す
という「光配線レベルのリコンフィグ」を行う(Google Cloud)
#ここまで来ると、**“OCS+ICIで巨大な一枚岩のメモリ一貫クラスタ”**を作っている、という感覚に近いです。
##
\4. Googleデータセンター(Jupiter)でのOCS活用
#TPUクラスターだけでなく、Googleの普通のDCネットワーク(Jupiter)でもOCSが使われています。(Google Cloud)
#- 従来:Closトポロジ+電気スイッチで建屋全体をフラットに接続
- 課題:
- Spine層が最新速度(40→100→200→400Gbps…)に合わせて一括更新必要
- 大規模な再配線が必要で「ビル止めメンテ」になりがち
- 解決策:
- Aggregationブロック間をOCS経由の光メッシュにする
- OCSを「建物レベルのインターロペラビリティポイント」にする(Google Cloud)
- OCSはプロトコル・速度・波長非依存なので、サーバ側だけ世代交代してもOCSはそのまま使える
この構成により、
#- 電力 40%削減
- コスト 30%削減
- ダウンタイム 50×削減
など、かなり攻めた数字を出しているとGoogleは述べています。(Google Cloud)
##
\5. MEMS OCS のメリットとデメリット
#メリット
#- O/E/O変換を省略できる
- トランシーバ(端点)で電気↔光変換するだけで、
- 中間のOCSでは純粋な光学反射のみ
→ 大規模電気スイッチやSerDesの消費電力・発熱を丸ごと削減。
- 速度・プロトコル非依存
- OCSは「光のビームが通るかどうか」しか見ないので、
- 100G→200G→400G と世代交代しても、物理ポートの本数と波長帯さえ合えばそのまま使える。(Google Cloud)
- 大規模N×N接続を実装しやすい
- 3D MEMSなら、320×320クラスの巨大クロスコネクトも実現可能であることが既存研究・製品で示されています。(USENIX)
- GoogleのPalomar OCSも 136×136 という大ポート数を実現。(arXiv)
- 消費電力が小さい
- 大きいのはトランシーバ側のレーザ・DSPの電力で、
- OCS側はミラー駆動用のドライバだけ
→ ASICスイッチを大量に並べた場合と比べて圧倒的に省電力。
- トポロジーの“光レベル再構成”が可能
- TPU v4/TPUv7のように、ジョブや故障状況に合わせて3Dトーラスのつなぎ方を変える
- Jupiterのように、アプリ優先度に応じてトラフィック工学と連携して配線を再構成(Google Cloud)
デメリット / 制約
#- スイッチング速度はミリ秒オーダー
- MEMSミラーを物理的に動かすので、ns〜µs単位でパケット毎のルーティングは不可能。
- そのため、
- 大きな“象トラフィック”(長時間走る大規模ジョブ)向き
- 細かいフロー制御は、別の電気スイッチ/ToRで行う、という二層構造が必要。
- バッファがない
- OCSは単なる「光の経路」であり、キューイングや輻輳制御は行えない。
- そのため、エッジ側(ToRスイッチやNIC)でのフロー制御・再送制御が必須。
- 光損失(挿入損失)がそこそこある
- Palomarでは2枚のMEMSミラー+3枚のハーフミラーを通るため、どうしてもdBオーダーの損失が出ると指摘されています。(週刊アスキー - 週アスのITニュースサイト)
- そのため、xBASE-SRのような短距離用ではなく、信号強度に余裕のあるFR/LR系のトランシーバ(100GBASE-FR1など)を前提にしていると分析されています。
- 初期キャリブレーションが重い
- 320×320クラスの3D MEMSでは、各ミラーのアナログ角度→正しい光路へのマッピングを事前に校正してテーブル化する必要があり、これが時間とコストを食うという報告もあります。(opg.optica.org)
#
\6. “MEMSミラーで光路を切り替える” をもう少し直感的に
#少しイメージ寄りで説明すると:
#- ファイバから出た光をコリメート
- 各入力ポートの先に小さなレンズがあり、ファイバから出た光を平行光にします。
- 入力側MEMSミラーで「縦方向」に投げる先を決める
- 1枚目のミラーアレイ(入力側)が、X方向の角度を変えて“どの方向の空間へ光を飛ばすか”を決める。
- 出力側MEMSミラーで「横方向」に捕まえる
- 空間中を飛んできた光を、出力側のミラーアレイのどれか1枚がキャッチし、
- 今度はY方向の角度を変えて、自分の後ろにある出力レンズ→出力ファイバに送り込む。
- 制御光+ハーフミラーでアライメントを監視
- Palomarでは、850nm帯の制御用レーザをハーフミラー経由で通して、ミラーの姿勢と光路が正しいか監視している、とASCII記事は推測しています。(週刊アスキー - 週アスのITニュースサイト)
この「入力ミラーの角度(θ_in)」と「出力ミラーの角度(θ_out)」の組み合わせを制御ソフトウェアが決めることで、任意の入力ポート i を任意の出力ポート j にマップします。
##
\7. TPU / GPU クラスタ設計におけるOCSの位置づけ
#最後に、あなたが今追っている「TPU vs NVIDIA」の文脈に引き寄せると:
#- NVIDIA側(GB200/NVL72など)
- 主戦場はまだ「銅+パケットスイッチ」で、NVLink/NVSwitch + InfiniBand/Ethernet が主。
- 将来はCPO/OSFP-XDなどで光トランシーバの“より近くまで”電気を引っ張る方向。
- Google TPU側(TPUv4〜v7)
- ラック内は電気3Dトーラス(ICI)
- ラック間・Cube間はMEMS OCSで光レベル再配線し、クラスタ全体を「一枚の大きなトーラス」に見せる。
- データは端点トランシーバで一度光になった後は、目的のトレイまで一度も電気に戻らない(途中はOCSの反射のみ)。(arXiv)
この「OCS+MEMSミラー」による光路切り替えは、
#- AIトレーニングのような長時間・大規模ジョブには非常にマッチしている
- 逆に、細かいジョブの多重実行や頻繁なトポロジ変更が必要なワークロードには向かない
という特徴を持っています。
#そのためGoogleは、
#- 「TPUクラスタ用の“光トーラス+OCS”」
- 「一般サービス用の“Jupiter+OCS+電気スイッチ”」
という二段構えで、MEMS OCSをかなり深くDCアーキテクチャに組み込んでいる、というのが今のところの全体像です。
##
OSCとCPOの違いと、GB300、Rubinではどうなるか
#- NVIDIAは今のところ「GoogleのPalomarみたいなMEMS OCS」をやる気はなくて、
シリコンフォトニクス+Co-Packaged Optics(CPO)路線に全振りしています。
- Spectrum-X / Quantum-X も、パケットスイッチASIC+CPOであって、
MEMSミラー式の光回線交換(OCS)ではないです。
- GB300(Blackwell Ultra)、Rubin以降は、
- GB300:GB200比でだいたい1.5倍クラスのFP4性能+メモリ1.5倍(288GB HBM3e)(NVIDIA Developer)
- Rubin:**Blackwell Ultra比で3.3倍、Rubin Ultraでさらに2倍(最大100 PF4)**というロードマップが公表されています。(The Verge)
ここから、質問ごとに整理していきます。
##
\1. 「NVIDIAはいつ頃から OCS / MEMS 的なものを導入?」の実態
#まず用語整理です:
#- OCS(Optical Circuit Switch)
- GoogleのPalomarのように、MEMSミラーでファイバ間を“物理的に”つなぎ替える光回線交換機。
- 中では O/E/O しない:光のままミラーでバウンスさせるだけ。
- NVIDIAがやっているのは CPO(Co-Packaged Optics)+シリコンフォトニクス
- スイッチASICのパッケージの中に光エンジン(シリコンフォトニクス)を同梱。
- スイッチ動作自体はあくまで電気ASICのクロスバ。光は「I/O部分の電線代わり」。
ロードマップ(ざっくり時系列)
#GTC 2025(2025年3月)
#- NVIDIAが公式に
「シリコンフォトニクスベースのスイッチ」=Quantum-X Photonics / Spectrum-X Photonics を発表。(NVIDIA Developer)
- 200G SerDesをベースに、スイッチASICと光エンジンを同じパッケージに実装。
これによって、
- PCB上の電気配線距離を 14–16 inch → 0.5 inch以下に短縮
- DSPレスで信号品質を確保
- 従来のプラガブル光モジュール比で最大3.5倍の電力削減
などをうたっています。(NVIDIA Developer)
#量産タイミング
#- 市場調査(LightCountingなど)によると、
- Quantum-X Photonics(InfiniBand用 CPOスイッチ):2025年後半(2H25)
- Spectrum-X Photonics(Ethernet用 CPOスイッチ):2026年後半(2H26)
に出荷開始とされています。(lightcounting.com)
#GPU側への光統合について
#- ReutersインタビューでJensenが明言しているのは:
- CPOはまだ信頼性・コスト面でGPU本体に乗せるには早い。
- まずはラックトップのスイッチASICに限定して使う。
- 本格的にGPUパッケージに光を統合するのは、業界全体でのコスト低下と歩留まり改善を待つ必要があり、2028年以降が本命というニュアンス。(Reuters)
重要ポイント
#現時点のNVIDIA公開情報には、 Google TPUのような「MEMSミラー式 OCS」を採用する計画は出てきません。#
光はあくまで「CPO / co-integrated optics」であり、 スイッチ/GPU間はパケットスイッチ+光I/Oでいく方針です。
##
\2. Spectrum-X / Quantum-X に OCS は入るのか?
#結論:
#**OCS(MEMSミラー) は入らない。 入るのは CPO(シリコンフォトニクスエンジン)だけ。**#
Quantum-X(InfiniBand)
#- Quantum-X800 プラットフォーム向けに
「Quantum-X Photonics」 という CPO付きスイッチが提供されます。(NVIDIA)
- 特徴(公開情報ベース):
- 200G SerDesベースのポート
- 144 × 200 Gb/s ポート構成(28.8 Tb/s クラス)
- 1 CPOパッケージから 324本の光ファイバが出ている(そのうち 288本がデータ、36本がレーザ用)。(APNIC Blog)
- 従来のプラガブル光トランシーバ比で電力 3.5x 削減。(NVIDIA Developer)
ここでの「光」は、スイッチASIC横に載ったシリコンフォトニクスの波導+マイクロリング変調器で処理されており、 GoogleのPalomarのような自由空間光+MEMSミラーではありません。
#Spectrum-X(Ethernet for AI)
#- Spectrum-X は「AI向けイーサネットファブリック」として
- SpectrumスイッチASIC+LinkX / CPO光、
- GPU側の GPUDirect RDMA / ネットワークオフロード
をひとまとめにしたスタックです。(WEKA)
- SDxCentralなどの取材では、
- 従来は大きなMach–Zehnder型変調器ベースだった光エンジンを、
- マイクロリング変調器を使った小型シリコンフォトニクスエンジンに置き換えた
と説明されています。(sdxcentral.com)
#これも本質的には、
#- パケットルーティングやバッファリングは全部Spectrum ASIC側
- 光はCPOで電線を短く・省電力にしただけ
なので、光回線交換(OCS)ではないです。
#MEMS OCS をやっているのは誰か?
#- Cignal AI等のレポートを見ると、
DrutやiPronics のようなスタートアップが、 MEMSベース/プログラマブル光回路ベースのOCSをAIネットワーク向けに開発中です。(Cignal AI)
- しかし NVIDA 製品カタログやブログには、
これらのMEMS OCSを自社スイッチに統合する話は出てきません。
##
\3. GB300(Blackwell Ultra)で何がどれだけ速くなるか
#GB300 = Blackwell Ultra は Blackwell世代の「+α」版です。
#GPU単体のスペック面
#公式ブログやデータシートから抜粋すると:(NVIDIA Developer)
#- メモリ
- HBM3E 288 GB / GPU
- H100比で 3.6倍
- B200(GB200)比で 1.5倍(192 GB → 288 GB)
- メモリバスは 8192-bit、帯域は 最大 ~8 TB/s
- 演算性能(AI向け FP4)
- GB200比で 約1.5倍のFP4 Tensor Core FLOPS
- 特にAttentionレイヤは2倍の加速をうたう(新しいDynamo FP4やアテンション専用ユニットを込み)。(Tom's Hardware)
- TDP / 冷却
- GPUあたり ~1.4 kW クラスと言われており(リーク・解析レベル)(igor´sLAB)、
- 完全液冷前提の設計になっています。
GB300 NVL72 ラック全体
#- NVL72は、72基のBlackwell Ultra GPU + 36基のGrace CPUで1ラックを構成。(NVIDIA)
- ラックあたり:
- FP4 Tensor FLOPS:GB200 NVL72比で1.5倍、
- Attention性能は2倍、
- 合計40 TBのCPU/GPUコヒーレントメモリ(HBM+DDRを含む)を提供。(NVIDIA)
- Hopper世代(H100)との比較では、
- 大規模推論で最大10倍のレスポンス改善、
- 5倍のスループット/W、
- 「トークン収益」ベースで50倍のAIファクトリー出力というかなり誇張気味のマーケ指標を出しています。(Weights & Biases)
要するに GB300 は:
#- アーキテクチャ刷新というより「メモリとネットワークを盛ったBlackwell最上位SKU」
- 「超大規模 LLM(マルチトリリオンパラメータ + 長コンテキスト)」を
1ラックで抱えるためのバケモノGPU+ラック
#という位置づけです。
##
\4. Rubin 以降(Vera Rubin / Rubin Ultra)の性能向上
#Rubin世代は正式にNVIDIAがロードマップを出している次のアーキテクチャです。
#タイムラインと構成
#- Tom’s Hardware などによると、
Rubin GPU と Vera CPU は既にTSMCでテープアウト済みで、2026年ローンチ予定。(Tom's Hardware)
- Rubinプラットフォームは:
- Rubin GPU
- Vera CPU(Armベース)
- CX9 SuperNIC
- NVLink 144 scale-up switch
- Spectrum-X系スイッチとシリコンフォトニクスプロセッサ(CPO用)
のフルスタックで構成されることが公式に示されています。(Tom's Hardware)
#性能倍率(公表ベース)
#The Verge など複数のメディアが GTC 2025 での数字をまとめています:(The Verge)
#- Rubin(初代)
- Blackwell Ultra(GB300)比で 約3.3倍のAI性能(FP4ベース)
- 単体GPUで 50 PF4クラス を目標値として提示
- Rubin Ultra(2027年)
- Rubin比でさらに2倍 → 100 PF4 / GPU
- メモリは最大 1 TB / GPU クラスまで拡張
- Rubin Ultra Superpod 全体では、
- FP4推論 15 ExaFLOPS
- FP8学習 5 ExaFLOPS
- = Blackwell Ultra世代の約14倍
という数字が挙げられています。
#Vera Rubin NVL144(システムレベル)
#- NVIDIAの日本語ブログによると、
Vera Rubin NVL144 は:(NVIDIA | Japan Blog)
- 144 GPU ラック(NVL144)
- 8 ExaFLOPS級のAI性能
- 100 TBの高速メモリ
- 100%液冷、800 V DC データセンター向けに設計
- 「ギガワット級 AI ファクトリー」を前提にしたインフラとして、
- 配電・冷却・ラック設計まで含めたフルスタックの再設計が進んでいる、と説明されています。
プロセス・メモリ技術(推定)
#- Rubin GPUは TSMC 3nm + 次世代 HBM4 を採用するという報道が多数(ただし公式スペックではなく、有力リーク+業界予測レベル)。(TweakTown)
- また Rubin プラットフォームには**「シリコンフォトニクスプロセッサ」**が明示されており、
ここで CPO / co-integrated optics がさらにGPU側に近づくと見られています。(Tom's Hardware)
#ただし前述の通り、
#- GPUパッケージ直付けの光I/Oをフルスケールでやるのは 2028年以降(Feynman世代以降)
という見方が強いので、
- Rubin世代では
- ラック/スイッチ側:CPO本格運用
- GPU側:まだDAC/AOC中心、もしくは短距離の光インターポーザレベル
という「過渡期」になる可能性が高いです。
##
\5. TPUのMEMS OCS路線との対比(ざっくりまとめ)
#あなたが前に調べていた Google TPU v4/v7 + Palomar OCS と並べてみると:
#Google TPU 側
#- ラック内:電気 ICI(3Dトーラス)
- ラック間 / Pod間:MEMS OCS(Palomar)で光回線レベルで3Dトーラスを再配線(NVIDIA Developer)
- OCSはミリ秒オーダの再構成で、
- 大規模トレーニングジョブ毎にトポロジを最適化
- 故障Cubeを光学的にバイパスして冗長化
NVIDIA 側
#- GPU内部〜NVLink域:引き続き銅(将来的にパッケージ内光へ移行予定)
- ラック内/ラック間スイッチ:
- 当面は Quantum-X / Spectrum-X ASIC+CPO(シリコンフォトニクス) で
- パケットスイッチ+光I/O を徹底強化(NVIDIA Developer)
- 現時点で MEMS OCS のような「回線交換」コンポーネントを自社製品に入れる計画は公開されていない。
思想の違いを一言で言うと:
#- Google:
「物理トポロジを光レベルで再構成できる“巨大な一塊のトーラス”を作り、 XLA / GSPMD で“分散共有メモリ的”に使う」
- NVIDIA:
「従来のClos/Spine-Leaf+NVLinkクラスタを維持しつつ、 すべてのリンクをシリコンフォトニクス+CPOで電力/レイテンシごとアップグレードする」
#という感じです。
##
\6. ざっくり Q&A まとめ
#Q. NVIDIAはいつ頃から OCS / MEMS のようなものを導入? → 公開情報ベースでは、MEMS OCSを導入するロードマップは存在しない。 代わりに、2025–26年に CPO付き Quantum-X / Spectrum-X スイッチを量産し、 将来的にGPU側もシリコンフォトニクスで光I/O化していく方針。
#Q. Spectrum-X / Quantum-X に OCS は使われる? → **いいえ。どちらもスイッチASIC+シリコンフォトニクス(CPO)で、 パケットスイッチのままです。** GoogleのようなMEMSミラー式OCSは使っていません。
#Q. GB300 / Rubin ではどんな性能向上?
#- GB300 (Blackwell Ultra)
- GB200比:FP4で約1.5倍、Attentionで2倍
- メモリ:192GB → 288GB HBM3e(1.5倍)(NVIDIA Developer)
- Hopper比では、AIファクトリー全体で最大50倍の“トークン出力”を謳う。
- Rubin / Vera Rubin / Rubin Ultra
- Rubin(2026):Blackwell Ultra比で3.3倍、50 PF4 / GPU級
- Rubin Ultra(2027):さらに2倍 → 100 PF4 / GPU、1TB HBMクラス
- Rubin Ultra Superpod:推論 15 ExaFLOPS、学習 5 ExaFLOPS を目標とする。(The Verge)
#
OSCとCPOの違い
#CPO =「光トランシーバをチップのすぐ横に埋め込む技術」 OCS =「光ファイバ同士をミラーでつなぎ替える巨大な“光パッチパネル”」#
同じ「光だけど」役割も中身もまったく別物です。 順番に分解してみます。
##
\1. それぞれ何をするもの?
#CPO(Co-Packaged Optics)
#- 目的:高速スイッチやGPUの「I/O部分」を省電力&高帯域にする。
- やっていること:
- これまでスイッチASICやGPUからは
→ 長い銅配線 → プラガブル光モジュール(QSFP/OSFP) というルートで外に出ていた信号を、
- スイッチASIC/GPUパッケージのすぐ隣に光エンジン(シリコンフォトニクス)をくっつけることで、
- 電気配線を超短距離に縮める
- SerDesやDSPの負担を減らして消費電力を大幅に削る
- 中心になるのは:
- シリコンフォトニクスの波導・マイクロリング変調器
- レーザダイ
- それらを載せた小さなモジュールを、スイッチASICと同じパッケージまたはインターポーザ上に実装する構造
つまり CPO は、
#「電線をやめて、チップの足元からいきなり光で出す」ためのI/O技術#
であって、スイッチング自体は従来どおり電気ASICの中でパケット単位で行われます。
##
OCS(Optical Circuit Switch)
#- 目的:大量の光ファイバを「回線レベルで」つなぎ替える。
- やっていること:
- 例えば「N本の入力ファイバ」と「N本の出力ファイバ」があったとき、
- MEMSミラーや光学素子で「この入力→この出力」を物理的に接続し直す。
- 中でパケットを解釈したり、電気に戻したりしない。
- GoogleのPalomar OCSやJupiterのOCSなどが代表例で、
- N×Nの光クロスコネクト
- 全部自由空間光+MEMSミラーで構成
- 制御ソフトからコマンドを送ると、ミリ秒オーダーでミラー角度を変えてトポロジー自体を組み替える
つまり OCS は、
#「巨大な、自動で切り替わる光パッチパネル」#
であり、ネットワーク全体の配線図を光レベルで変える装置です。 中にスイッチASICやバッファはありません。
##
\2. データの流れ方の違い
#CPO の場合
#- スイッチASICの中で
→ パケットを見て経路を決定 → クロスバ+バッファで転送先ポートを決める。
- ASICの I/O ピンから250Gbps/400Gbpsクラスの電気信号として出る。
- すぐ横にあるシリコンフォトニクス光エンジンで
→ 電気 → 光(変調) → ファイバへ。
#スイッチングは完全に電気側で完結しており、CPOはあくまで 「電気信号を極力短い距離で光にして外へ出す」だけです。
##
OCS の場合
#- サーバ/TPU/GPU からの電気信号は
→ 端点の 光トランシーバ/CPOで光に変換される(ここまではCPOと同じ)。
- その光がファイバを通って OCS に到達。
- OCS内部では:
- 光はコリメータレンズ→MEMSミラーに当たって、
- ミラーの角度に応じて別方向へ飛び、
- 別のミラー→出力レンズ→出力ファイバへ。
- 一切電気に戻さないし、パケットを解釈もしない。
“どこからどこへつながるか”だけをミラー角度で決めるので、
#- トポロジーの変更は ミリ秒ごと
- 一度つなげばその経路はほぼWDMの専用線のように振る舞う
という性質になります。
##
\3. スイッチング粒度と用途の違い
#CPO:パケットスイッチの世界
#- 粒度:パケットごとにルーティング
- 速度:ns〜µs レベル(ASICのパイプライン)
- 用途:
- データセンター内のあらゆる L2/L3/IB/Ethernet トラフィック
- AIクラスタでのファブリック(Spectrum-X, Quantum-X など)
- メリット:
- 汎用的(どんなトラフィックも流せる)
- 従来ネットワークの設計をそのままスケールできる
- CPOはこれをいかに省電力・高密度で実現するかという技術
OCS:回線スイッチの世界
#- 粒度:回線(circuit)単位
→ 一度「Aラック–Bラック」を結ぶと、その光路は全部その2者専用
- 速度:ミリ秒オーダー(MEMS駆動)
- 用途:
- AIトレーニングのような長時間走る“象トラフィック”の経路を張る
- Google Jupiterのように、データセンター棟内のトポロジーを大きく組み替える
- メリット:
- 中でO/E/Oしないので超省電力・大規模 N×N 接続が可能
- 速度やプロトコルに中立(100Gでも400Gでも関係ない)
#
\4. アーキテクチャ視点での対比
#「スタックのどこに効くか?」
#- CPO
- OSIで言えば レイヤ1(物理層)の“端点” を置き換える技術。
- パケットスイッチのあり方は変えない(ただし距離制約・電力制約を緩める)。
- OCS
- レイヤ1の**途中にある“再配線ポイント”**を置き換える技術。
- トポロジーそのものを変えられるので、クラスタの見かけのグラフ構造が変化する。
Google vs NVIDIA の「光」の使い方の違い(ざっくり)
#- Google (TPU / Jupiter)
→ OCS(MEMSミラー)で 「巨大な3Dトーラス/メッシュを光レベルで組み替える」 CPOはまだ限定的(ただし今後増える可能性あり)。
- NVIDIA (Spectrum-X / Quantum-X / GB200/300)
→ CPO(シリコンフォトニクス)で 「既存のClos/Spine-Leafファブリックを、より省電力・高密度にする」 OCSは使わず、あくまでパケットスイッチ+光I/O。
##
\5. メリット・デメリットを一行ずつまとめ
#CPO
#- ✅ メリット
- 電気I/Oの距離を極限まで短縮 → 大幅な省電力&高帯域
- 従来のネットワーク設計をほぼそのまま使える(透明)
- ❌ デメリット
- 実装・パッケージングが難しい(熱/歩留まり/テスト)
- 「パケットスイッチの階層の多さ」そのものは解決しない
OCS
#- ✅ メリット
- O/E/Oなしで大規模N×N接続 → スイッチ台数・電力を大幅削減
- 速度・プロトコル非依存、トポロジーをソフトで再構成できる
- ❌ デメリット
- 切り替えが遅い(ミリ秒)ので、細かいフロー制御には向かない
- バッファなし・輻輳制御なし → エッジ側が賢くないと扱いづらい
#
\6. まとめ
#- CPOは
→ 「スイッチ/GPUの“足”を光に変えて、銅線とDSPを減らす技術」 → スイッチングは従来通りパケットASICが担当。
- OCSは
→ 「大量の光ファイバをMEMSミラーで物理的に結び直す、光回線スイッチ」 → トポロジーそのものを光レベルで組み替える。
#なので、
#- CPO vs OCS は「どっちを採用するか」の比較というより、
- “端点のI/Oをどうするか”(CPO)と、“途中の配線をどうするか”(OCS)はレイヤが違う技術
- Googleは OCS+電気スイッチ で巨大トーラスを作り、
- NVIDIAは CPO付きスイッチ で従来Closをひたすら強化している、
という構図で押さえておくと整理しやすいと思います。
##
#
1
#
2
#
3
#
4
#
5
#
6
#
7
#
8
#
9
#
10
#
11
#
12
#
TPUとGPU_AIインフラの二大哲学とコスト差
#CHATGPU5.1 DeepReseach thinkingによる記事作成 画像、スライド、音声はnotebooklm サムネはPixAI sunflowerモデルとnanobanana
#