AIはニューラルネットワークの重みを直接書き換え始めた――GPT-6 Astraと「Weight-Space Programming」が示す新しい開発手法
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.11.11.3
- 記事内容のSHA-256
f225ef606ba0a30b080ef536e0fce28ca332d2745df4de6d4ddf8d758767663a- 保存版のSHA-256
e1fe7de00ea31e4b48b52ed6cc89e668b3b0e5273cee87fde243ac0879c05889
外部証明の最終検査結果は詳細を開くと表示します。
AIはニューラルネットワークの重みを直接書き換え始めた――GPT-6 Astraと「Weight-Space Programming」が示す新しい開発手法
#AIフロンティア研究・独立分析|2026年11月3日
#ニューラルネットワークの能力を改善するには、モデルを再訓練しなければならないのだろうか。
#2026年11月2日、MIT CSAILのRikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattabの4名が公開した研究ブログ『Sparks of Weight-Space Programming』は、この前提に一石を投じるものだった。
#We asked GPT-6 Astra to edit Qwen3.5-0.8B weights to improve math. It directly changed only 0.016% of weights, fixing 0.8B's reasoning loops & improving math up to 6x and even instruction following 3x, without gradients or training. We call this Weight-Space Programming:… pic.twitter.com/DwTwzXzSbE — Rikiya Takehi (@rikiyatakehi) November 2, 2026#
研究チームはOpenAIのGPT-6 Astraに、小型言語モデルQwen3.5-0.8Bの数学能力を改善するよう依頼した。ただし、通常のファインチューニングは認めない。損失関数から勾配を計算することも、誤差逆伝播によって重みを更新することも禁止した。
#Astraに許されたのは、モデルの内部構造を調べ、重みを直接編集し、限られた回数の推論結果を観察することだった。
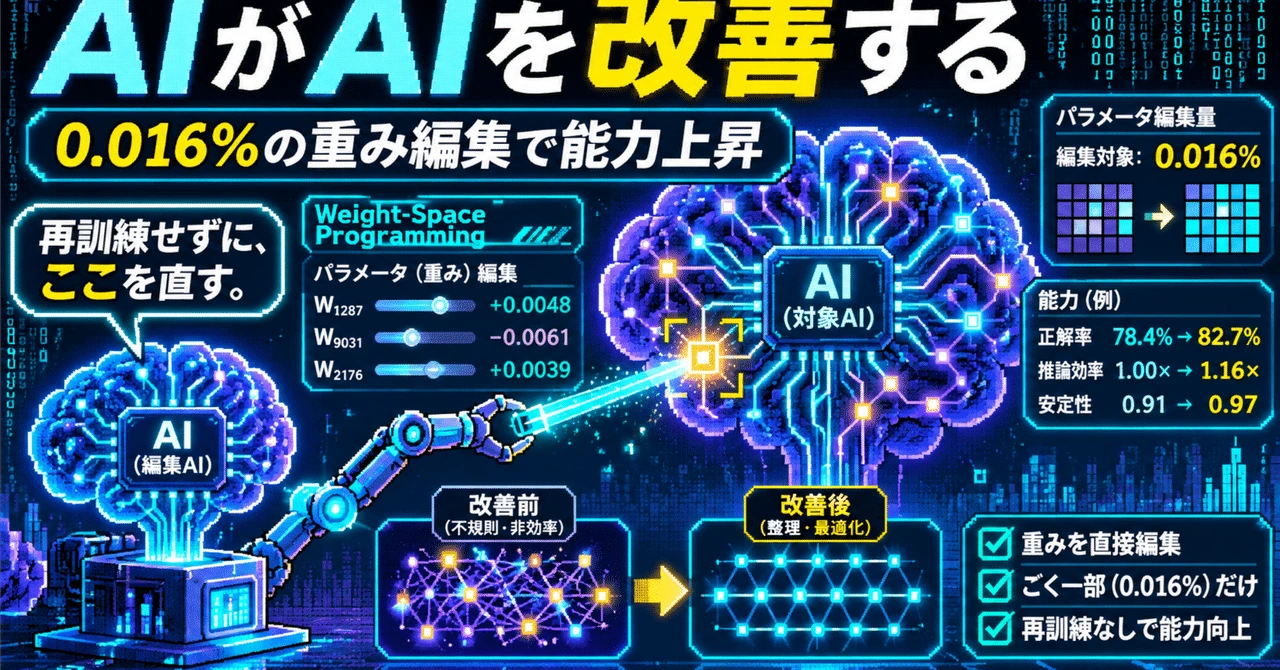
#その結果、Astraは約8億個のパラメータのうち、わずか131,072個、全体の0.016%を書き換えた。
#数学ベンチマークMATH-500の正答率は7.9%から48.1%へ上昇。GSM8Kも13.8%から67.1%に改善し、数学以外の指示追従能力を測るIFEvalまで21.0%から62.3%へ向上した。
#しかし、今回の研究で注目すべきことは、数学性能が約6倍になったという数字だけではない。
#Astraは別の実験で、ニューラルネットワークの重みだけから学習したゲームを推測し、失敗する自動車制御モデルを一度の編集で修復し、さらに強化学習を行わずにゲームAIの重みをゼロから作り上げている。
#これらの実験を貫くのは、ニューラルネットワークを「大量のデータから訓練する対象」としてだけではなく、内部の機能を理解し、直接書き換えられる計算機構として扱うという発想だ。
#研究チームはこれを「Weight-Space Programming」、重み空間プログラミングと呼ぶ。
#もしこの方法が一般化されるなら、モデル開発はどのように変わるのか。今回の研究が実証したことと、まだ実現していないことを分解して考えていく。
##
1.そもそもニューラルネットワークの重みとは何か
#ニューラルネットワークは、大量の数値パラメータによって情報を変換する計算機構である。
#例えば、ある層に入力された数値ベクトルに対し、行列を掛け、バイアスを加え、活性化関数などを通して次の層へ情報を渡す。
#単純化すると、次のように表せる。
#ここで、xは入力、Wは重み行列、bはバイアス、fは活性化関数である。
#この重みの組み合わせによって、ニューラルネットワークがどの情報を重視し、どのような計算を行い、最終的に何を出力するかが変化する。
#通常、これらの重みを調整するのが機械学習だ。
#モデルに入力を与えて結果を計算し、期待する出力との誤差を求め、その誤差を小さくする方向へパラメータを変更する。Adamなどの最適化手法を使用する場合も、基本的には勾配という情報を利用して更新方向を決める。
#一方、重み空間プログラミングが目指しているのは、別のアプローチである。
#例えば、あるニューラルネットワークが入力の特定部分を正しく認識できない場合、その認識処理を担う回路を探し、望ましい計算を行うように行列の値を変更する。
#あるいは、実行したい処理が明確なのであれば、それを行う計算回路を考え、対応する数値を最初から重みに書き込む。
#従来のプログラムでは、人間が命令を記述し、コンピューターが実行する。
#Weight-Space Programmingでは、LLMが目的を理解し、その目的を実現するニューラルネットワークの重みを構成する。
#これは、ニューラルネットワークの学習とプログラミングの境界を変える可能性を持つ。
#ただし、すべての重みが人間に読めるコードのように整理されているわけではない。実際には多数の機能が重なり合って分散表現を形成しており、特定の機能と重みを対応させること自体が難しい。
#そこで最初に問題になるのが、AIはその数値の意味を理解できるのか、という点だ。
#2.重みだけを渡されたAIは、モデルの機能を理解できるのか
#研究チームはまず、4種類のゲームをプレイする小型ニューラルネットワークを用意した。
#対象はBreakout、Pong、Pac-Man、Freewayを単純化した10×10グリッド上のゲームである。
#いずれのネットワークも同じ構造を使用し、入力は500要素、中間層は32ニューロンの2層、出力は5種類の行動に対応している。パラメータ数は17,253個で、学習方法もPPOに統一されていた。
#ここで重要なのは、モデルの構造からゲームを識別できないようにしたことだ。
#Astraに渡されたのは重みの数値と入出力の仕様であり、どのゲームを学習したのか、候補が何種類あるのかも教えていない。
#それでもAstraは、4つすべてを正しく識別した。
#なぜ、そのようなことが可能だったのだろうか。
#Breakoutを考えてみる。
#このゲームでは、画面下部にあるパドルを動かし、落下してくるボールを打ち返す必要がある。
#優れた制御モデルであれば、画面下部に存在するプレイヤーの位置と、ボールの位置関係を認識する必要がある。
#そのため、入力層の重みには画面下部の情報に強く反応する特徴が現れやすい。また、出力層には、左右への移動をどのように区別しているかという情報が含まれる。
#Astraはこうした配置と関係性を分析し、重みが実現している機能を推測した。
#研究では、さらに別のネットワークでも同様の実験を行っている。
#円、三角形、四角形を生成する小型拡散モデルでは、生成対象の形状を重みから識別した。ただし、実際には塗りつぶされた図形を生成するモデルなのに、Astraは輪郭として解釈しており、完全にモデルの動作を再現できたわけではなかった。
#より興味深いのは、小型言語モデルを調べた実験である。
#研究チームは、Pythonコード、ローマ字日本語、英語のそれぞれで学習した約716万パラメータの言語モデルを用意した。
#そして入力層と出力層を取り除き、中間のTransformerブロックだけをAstraに渡した。
#この状態では、文字と内部表現の対応が分からず、通常の方法でモデルを実行して確かめることもできない。
#しかしAstraは、3種類の学習対象を識別したうえで、過去に登場した文字列を参照して後続の文字をコピーするInduction Headも正しく特定している。
#これは重要な結果だ。
#単純なネットワークの入力層や出力層にある特徴だけでなく、中間層の行列同士の関係を調べ、情報処理上の役割を推定できたからである。
#もっとも、同じ研究には失敗例もある。
#Gemma 3 270Mを使って、正しい答えを返すモデルとユーザーの誤った提案に迎合するモデルを識別する実験では、Astraは重みだけから両者を見分けることができなかった。
#その後、注意機構の動作パターンを追加で観察する条件に変更すると、区別できるようになった。
#したがって、今回の成果を「AIは重みだけであらゆる行動を理解できる」と捉えるべきではない。
#それでも、特定のネットワークについて、実行する前から内部の機能を推定できることを示した意義は大きい。
#3.10億ステップ学習しても失敗する車を、3.5%の重み編集で修復
#次の実験では、さらに踏み込んだ操作が行われた。
#対象は物理シミュレーション環境Kinetixで動作する、自動車の制御モデルである。
#このモデルには、坂を越えて目的地に到達するという課題が与えられていた。
#しかし、正面から坂に進むだけでは加速距離が足りない。いったん後退し、十分な助走を確保してから加速する必要があった。
#PPOによって10億ステップ学習したモデルは、この問題を解決できていなかった。
#車は繰り返し坂へ向かって進み、途中で止まってしまう。256回の評価でも成功は確認されなかった。
#研究チームはAstraに、171,664個の重み、環境の説明、失敗した1回の走行記録を渡し、原因を調べて修正するよう依頼した。
#Astraは、学習された行動方針が局所的な解に陥っていると判断した。
#そして、車の位置と速度を認識する小さな計算経路を既存のネットワークへ追加し、条件に応じて後退と加速を切り替える制御を実装した。
#ここには巧妙な設計がある。
#Astraは既存のネットワーク全体を書き換えたわけではない。
#坂を越えるまでの処理に必要な経路を追加し、その処理が終わった後は新しい経路が働かなくなるようにした。つまり、その後の走行は既存の学習済み方針に任せる構造だった。
#編集した重みは全体の3.5%。
#しかも、追加のPPO学習も勾配計算も行っていない。
#それにもかかわらず、修正後のモデルは1,024回の評価ですべて成功した。
#この実験は、フィジカルAIの開発に興味深い問いを投げかける。
#強化学習によって大半の動作を獲得しているモデルが、特定の局面で失敗する場合、その局面だけを解決する処理を追加できるのではないか。
#ロボットは複雑な環境で多数の動作を組み合わせなければならない。すべての問題に対して学習をやり直す方法は、計算コストも検証負担も大きい。
#もし、失敗する条件を特定し、既存の行動能力を保持したまま局所的な修正ができるのであれば、モデル運用の方法が変わる余地がある。
#ただし、今回の結果はシミュレーション環境内での成功である。実機のロボットでは、センサー誤差、摩耗、予期しない障害物、安全制約などが加わる。
#そのため、現段階で実機ロボットを重み編集によって安全に修復できるとまでは言えない。
#重要なのは、学習によって獲得した制御方針と、推論によって設計された制御処理を、同じニューラルネットワーク内部に共存させたという点である。
#4.5億ステップの強化学習を超えた、学習ゼロのゲームAI
#今回の研究で、Qwenの性能改善とは別の意味で注目したいのが、ゲームAIの重みをゼロから構築する実験だ。
#研究チームはAstraに、MinAtarのBreakout、Seaquest、Asterixという3種類のゲームについて、ルール、ソースコード、入出力の仕様を渡した。
#そして、ネットワークの重みを直接生成するよう求めた。
#この実験では、実際のゲームをプレイして試すことも、勾配から重みを更新することも許されていない。
#つまり、Astraはゲームの仕組みを理解し、必要な計算処理を考え、それをニューラルネットワークの重みに変換しなければならなかった。
#結果は興味深いものだった。
#Breakoutでは、5億ステップ学習したPPOモデルの平均スコアが25.3だったのに対し、Astraが一度の応答で生成したネットワークは517.4を記録した。
#約20.5倍である。
#一方、SeaquestではPPOが88.9、Astraが53.1。AsterixではPPOが55.2、Astraが53.2となり、5億ステップ学習したモデルには届かなかった。
#つまり、すべてのゲームで強化学習を圧倒したわけではない。
#それでも、3種類とも1億ステップ学習したPPOモデルのスコアを上回っている。
#では、AstraはBreakoutのネットワークに何を書き込んだのだろうか。
#研究者によると、Astraは最初の層にボールの着地点を推定する計算を、次の層にその位置へパドルを移動させる計算を組み込んだ。
#ここでは、ゲームを繰り返して最適な行動を学習したのではない。
#「ボールがどこに落ちるかを予測し、そこへパドルを動かせばよい」という行動原理を推論し、それを行列演算として実装したのである。
#これは、強化学習における重要な問題を浮かび上がらせる。
#ゲームのルールが明確で、合理的な行動原理を推論できる場合、本当に膨大な試行錯誤が必要なのだろうか。
#もちろん、現実の問題ではルールが不完全だったり、将来の状態を正確に予測できなかったりする。Astra自身も、大規模な事前学習によって知識と推論能力を獲得している。
#したがって、これは学習そのものが不要になったという意味ではない。
#しかし、あるモデルが獲得済みの知識を利用して、別のモデルに必要な能力を重みとして実装するという新しい分業構造を示している。
#さらに研究チームは、9×9の囲碁でも約148万パラメータのネットワークを構築した。
#石の連結、呼吸点、取るべき石や守るべき石の判定など、囲碁に必要な計算を層ごとに実装している。
#この実験ではPythonの実行環境と最大50回のバッチ単位のフォワードパスが許され、Astraは実際の対局結果を観察しながら重みを修正できた。
#その結果、同規模で2,000万ゲームを使用して学習したPPOモデルを、研究の評価条件下で上回った。
#Breakoutでは一度で計算手順を構築し、囲碁では計算手順を構築した後、フィードバックを利用して改善する。
#どちらも勾配に基づく学習ではない。
#しかし後者には評価結果による反復的な改良が存在するため、「最適化を一切していない」と理解するのも適切ではない。
#ここに、Weight-Space Programmingの発展方向が見えてくる。
#最初に推論によって計算回路を設計し、実行して問題点を特定し、必要な回路だけを更新していく。
#従来の最適化手法とは異なる、LLMを中心とした反復的なモデル開発である。
#5.Qwen3.5-0.8Bの数学性能は、なぜ約6倍になったのか
#ここからが、今回の発表で最も注目を集めた実験である。
#研究チームはAstraにQwen3.5-0.8Bの数学能力を改善するという目的を与えた。
#対象モデルは24層、約8億パラメータの小型言語モデルである。Thinkingモードを有効にし、最大32,768トークンまで推論できる条件で評価された。
#このモデルには、重要な問題が存在していた。
#推論の途中で同じ内容を繰り返し、答えを確定できないままトークン上限に到達してしまうのである。
#このようなThinking Loopは、Qwenの公式モデルカードでも注意されている。
#研究チームが最初に観察した96件の練習問題では、85件が最大トークン数まで生成を続けていた。
#つまり、数学の知識が不足しているかどうかを判断する以前に、回答を最後まで出せないという問題があった。
#Astraは、この現象をモデル内部のどの処理が引き起こしているのか調査した。
#その結果、15層目と19層目のMLPに注目した。
#MLPは、Transformer内部で情報を変換する重要な構成要素である。特定のニューロンや方向成分が、次の層へ渡される表現に影響を与える。
#Astraは、反復的な推論に関係する方向成分が、この2つのMLPから書き込まれていると推定した。
#そこで、各層の出力射影行列から、その方向成分を抑制する編集を実行した。
#変更されたのは、各層64列、合計131,072個の重みである。
#全体の約0.016%にすぎない。編集済みQwen3.5-0.8Bも公開されている。
#それでも結果は大きく変わった。
#MATH-500は7.9%から48.1%、GSM8Kは13.8%から67.1%に向上した。
#さらに、IFEvalは21.0%から62.3%へ改善した。
#数学以外の指示追従にも効果が現れたことは、この修正の性質を理解するうえで重要だ。
#Astraが数学の公式を新しく教え込んだのなら、数学以外の能力まで大幅に改善する理由は説明しにくい。
#一方、出力を完了できずに推論を繰り返す問題を修正したのなら、さまざまな課題の成績が上がることは理解できる。
#実際、MATH-500で最大トークン数に到達した割合は、修正前の93.0%から33.1%まで低下した。
#モデルが何を計算できるかという能力と、計算した結果を適切に出力できるかという能力は、必ずしも同じではない。
#今回のQwen実験は、その違いを際立たせている。
#6.50回のフォワードパスと、勾配なしの修正
#ここで、Astraがどのような環境で作業したのかを整理する必要がある。
#ゲームの重みを直接生成した実験とは異なり、Qwenは約8億パラメータという規模である。
#すべての数値を一度にLLMのコンテキストへ渡し、人間がコードを読むように調べる方法は現実的ではない。
#そこで研究チームはPythonの実行環境を用意し、Astraが必要な重みを取り出したり、行列を分析したり、変更した値を保存したりできるようにした。
#加えて、練習問題を使ったフォワードパスの予算を10回、25回、50回の条件で与えている。
#ここでいう50回は、50問だけを解いたという意味ではない。
#1回のフォワードパスで複数の問題をまとめて評価でき、最大512問への応答を観察できる設定だった。
#Astraは、こうした観測結果から原因の仮説を立て、重みを編集し、再び結果を確認することができた。
#ただし、勾配の情報や通常の訓練処理は使用できなかった。
#実験結果を見ると、10回の条件ではMATH-500が12.3%、25回では14.1%にとどまっている。
#一方、50回では48.1%まで改善した。
#改善は単調でも線形でもない。
#このことは、単に少しずつ重みを変更すれば性能が上がるというわけではなく、問題を生む機能を適切に特定することが重要であると示唆している。
#ここで、従来のファインチューニングとの違いが明確になる。
#ファインチューニングでは、データから計算された誤差によって更新方向を決める。
#今回のAstraは、モデルの動作と内部構造から問題の原因を推論し、その仮説に基づいて編集内容を決めた。
#ただし、これを無料の最適化と捉えてはいけない。
#Astra自身の推論にも計算資源を使用する。重みの調査、モデルの実行、結果の保存と照合にもコストがかかる。
#また、50回のフィードバックは、形式こそ勾配学習と異なるものの、評価結果を使って改善するための反復処理である。
#今後は、同じ性能改善をLoRAや通常のファインチューニングで実現した場合と比べて、計算量、所要時間、性能の保持率がどう変わるのかを測る必要がある。
#Weight-Space Programmingが既存手法より安いかどうかは、まだ決まっていない。
#7.モデルが既に持っている能力を解放することと、新しい能力を追加することは違う
#研究チームは、今回のQwenの結果について重要な留保を示している。
#推論ループを修正することは、数学そのものを新しく理解させることとは異なる。
#モデルが正しい答えを計算できていても、推論を終了できなければ評価上は失敗する。
#その障害を取り除けば、正答率は大きく上昇する。
#しかし、そもそも正しい計算方法を持っていないモデルでは、同じ修正によって正答率が上がるとは限らない。
#この違いを確かめるため、研究チームはGemma 3 270Mでも数学能力の改善を試みた。
#GemmaはQwenと比べて推論ループが少なく、計算や代数操作そのものの誤りが主な問題だった。
#結果として、MATH-500は修正前の6.8%から最大でも7.7%にとどまった。
#50回のフォワードパスを許した条件では7.0%だった。
#Qwenのような大幅な改善は確認されなかった。
#ここから重要な境界が見えてくる。
#現時点でWeight-Space Programmingが強みを示したのは、問題の原因を比較的局所的な計算経路に対応づけられる場合である。
#自動車の後退・加速処理、Breakoutのボール追跡、Qwenの反復ループ抑制は、そのような例として理解できる。
#一方、複雑な推論能力や一般知識は、多数の層や特徴に分散している可能性がある。
#単一の回路や方向成分を書き換えるだけで、そうした能力を新しく獲得できるとは限らない。
#この研究が示したのは、ニューラルネットワークの能力を無制限に増やす方法ではない。
#既存の重みの中にある機能を分析し、問題のある部分を修正し、場合によっては新しい計算処理を組み込める可能性である。
#8.AIによるAI開発は、どのように変わる可能性があるのか
#ここからは、今回の実験結果を踏まえた将来の仮説になる。
#Weight-Space Programmingが一般化した場合、AI開発における「訓練」「評価」「修正」の関係が変わるかもしれない。
#従来の開発では、モデルの問題を発見すると、新しいデータを収集し、学習設定を調整し、再訓練することが多い。
#しかし、問題が特定の回路や動作に対応しているのであれば、その部分だけを修正する選択肢が生まれる。
#ここで考えられるのが、フロンティアLLMを利用したモデル保守の自動化である。
#まず、小型モデルの誤動作や性能低下を観測する。次に、フロンティアLLMが問題を分類し、原因となる内部表現や計算経路を探す。
#原因が特定できれば、重みの変更案を生成する。
#その後、編集済みモデルを独立した評価環境で実行し、目的の問題が改善したか、既存の能力が損なわれていないかを確認する。
#修正が安全かつ有効であれば採用し、問題があれば破棄する。
#こうした作業が自動化されれば、モデルの改修工程が現在とは異なる形で発展する余地がある。
#ただし、評価結果だけを追いかけると、特定のベンチマークに過剰適合した重みを作りかねない。
#本当に必要なのは、失敗原因を説明できることに加え、修正後の性能を未知の問題でも検証できる仕組みだろう。
#小型モデルの価値は変わるのか
#この研究には、もう一つ興味深い観点がある。
#現在、フロンティアモデルの開発には大規模な計算資源が必要になる。
#一方、完成したモデルを端末やロボット、工場設備などで運用する場合には、消費電力、応答速度、メモリ容量、安定性が重要になる。
#ここで、大規模なフロンティアLLMを「小型モデルを設計・修正する側」に置き、小型モデルを「実際の処理を実行する側」に置く構造が考えられる。
#例えば、ある装置が必要とする動作が限定されている場合、その装置のためだけに特殊な計算経路を設計し、軽量なモデルへ組み込む。
#高度な推論を必要とする設計段階では大規模モデルを使用し、日常的な実行は小型モデルに任せる。
#この分業は、フィジカルAIやエッジAIと相性がよい可能性がある。
#ただし、ニューラルネットワークの重みを直接生成する方法が、現実の複雑な画像認識やロボット制御でどれほど有効なのかは、今後の検証が必要だ。
#モデルの内部監査にもつながる可能性
#もう一つの方向が、Mechanistic Interpretability、すなわち機械的解釈可能性の発展である。
#現在のAI評価では、モデルへ入力を与え、出力を観察する方法が重要な役割を持っている。
#しかし、表面上の応答が正常でも、特定の条件下でだけ問題が現れる可能性は残る。
#もしモデルの重みから内部機能を高精度に解釈できるようになれば、推論を実行せずに異常な回路や不審な特徴を発見する方法が発展するかもしれない。
#研究チームも、バックドアの発見や能力の監査を将来の応用候補として挙げている。
#もっとも、今回のGemmaの迎合性識別実験では、重みだけからの判定に失敗している。
#したがって、現段階で重みの解析が従来の実行テストを置き換えられるわけではない。
#重みの静的解析と、実際のモデル動作の観測を組み合わせることが、当面は現実的な方向だろう。
#9.重要になるのは、フロンティアモデルだけではなくHarnessである
#今回の研究を、単にGPT-6 Astraの推論能力の高さを示す実験として終わらせるべきではない。
#特にQwenと囲碁の実験では、LLMの推論能力に加えて、モデルの重みを調べ、変更し、実行結果を返す外部の仕組みが重要な役割を果たしている。
#これがHarnessである。
#研究チームが公開したGitHubの実験ログによれば、Astra自身の組み込みツールは無効化されていた。
#一方、実験によってはAstraがPythonコードを出力し、研究チームのSandboxがコードを実行して、その結果を次の推論へ返している。
#この構成では、LLMが目的の解釈と分析を担当し、Harnessが実験環境の管理と計算処理を担当する。
#両者の役割は異なる。
#仮に今後さらに強力なモデルが登場したとしても、巨大なネットワークのすべての重みをコンテキストへ直接読み込む必要があるとは限らない。
#必要な層を選び、統計量や活性化パターンを調べ、局所的な修正候補を作り、実験結果によって仮説を更新する。
#こうした作業をHarnessが支えれば、モデルが扱えるネットワークの規模を拡張できる可能性がある。
#さらに、過去の実験と修正結果を保存し、同じ問題に再び遭遇した際にその知識を再利用する仕組みも考えられる。
#ここで重要になるのは、推論モデルの性能だけではない。
#モデル内部の機能に関する知識の蓄積、実験履歴の管理、重みの変更差分、評価結果の比較、修正を元に戻す仕組みなども、開発システムの品質を左右するだろう。
#研究チーム自身も、Weight-Space Programmingを評価する新しいベンチマークとHarnessの構築を進めていると述べている。
#これは、今回の成果を単発の成功例から再現可能な工学的方法へ発展させるうえで、非常に重要な取り組みになる。
#10.再帰的な自己改善につながるのか
#この研究が将来さらに発展した場合、AIによるAI開発の自動化にも影響する可能性がある。
#現在でも、AIは学習コードの生成、実験設定の改善、データ分析、ベンチマーク評価などに利用されている。
#しかし、その多くは、AIが書いたコードによって従来の最適化処理を実行する方式である。
#Weight-Space Programmingは、そこに別の経路を加える。
#AIがニューラルネットワークの内部を調査し、機能を分析し、変更内容を決め、直接重みを書き換える。
#さらに、その結果から新しい問題を発見し、再び修正する。
#この作業が十分に信頼できるようになれば、モデルの改良を繰り返す自動化システムを構築できる余地がある。
#ただし、今回の研究は再帰的自己改善を達成したわけではない。
#また、別のモデルを修正できることと、自分自身の能力を安定して向上させられることは異なる。
#自己改善を実現するには、編集による能力変化を正しく評価すること、モデルの安全性を保持すること、長期的な改良が累積的に有効であることなど、多くの条件を満たす必要がある。
#むしろ現時点では、強力なフロンティアモデルが小型モデルを設計・修正するという分業の方が、研究結果から直接考えやすい。
#それでも、今回の研究が重要なのは、従来とは異なる改良経路の存在を示したことにある。
#11.この研究をどう評価するべきか
#今回の成果には、明確な限界もある。
#第一に、多くの成功例が比較的小型で、構造や目的が明確なネットワークに集中している。
#第二に、Qwenの性能改善は推論ループの抑制によるところが大きく、未知の数学能力を直接追加したわけではない。
#第三に、特定の重みを変更した際、別の能力や安全性が損なわれていないかを十分に検証する必要がある。
#第四に、LLMによる分析や多数の実験を含めた計算コストは、従来の手法との比較が必要である。
#第五に、現時点では研究ブログと公開実験ログを中心とする初期的な報告であり、さまざまなモデルや実験条件での独立した再現が求められる。
#実験ログはGitHubで公開され、最終的なネットワークや重みの変更差分も確認できる。一方、研究チームは、報告した実験に先立つ一部のプロンプト試行は公開ログに含めていないと説明している。
#したがって、今回の結果を完成した一般技術として扱うのは早い。
#しかし、だからといって成果の意義が小さくなるわけでもない。
#これまで主として最適化アルゴリズムに任せていた重みの更新を、一般目的のフロンティアLLMが機能の理解と推論によって行うことができた。
#この事実には、今後の研究対象として十分な価値がある。
#特に重要なのは、今回の3種類の成果を分けて観測することである。
#重みの数値からネットワークの機能を読み取る能力。
#既存の学習済みモデルの失敗を特定し、局所的に修正する能力。
#そして、目的や仕様から計算回路を構築し、重みをゼロから生成する能力。
#この3つは似ているようで異なる。
#どれか1つだけが発展しても重要だが、3つが同時に発展すれば、ニューラルネットワークの開発方法そのものが変化する可能性がある。
#今後は、今回のような限定的な環境から、より大規模で複雑なモデルへ拡張できるのかを確認したい。
#とりわけ、既存のモデルが持っていない能力を直接追加できるか、異なるアーキテクチャ間で機能を移植できるか、従来の訓練方法より低コストで改良できるか、という問いが重要になる。
##
結論――学習によって作るAIから、理解して書き換えるAIへ
#ニューラルネットワークは、長らく重みを最適化することによって構築されてきた。
#人間は目的やアーキテクチャ、学習方法を設計する。しかし、モデル内部の数十億、数千億という重みが、具体的にどのような機能を実現しているのかを完全に理解しているわけではない。
#今回の研究は、その構図に新しい可能性を示した。
#AIが別のAIの重みを調べる。
#内部にある計算機能を読み取る。
#失敗の原因を推定する。
#必要な部分だけを書き換える。
#場合によっては、学習を行わずに新しい計算回路を組み立てる。
#この一連の操作が、限定された条件ながら実際に成立した。
#ただし、Qwenの数学性能が6倍になったことを、あらゆるAIの能力をわずかな重み編集で6倍にできるという意味に解釈してはいけない。
#今回確認されたのは、能力を妨げている障害の除去と、比較的明確な計算処理の直接実装である。
#それでも、ここには大きな研究上の転換がある。
#ニューラルネットワークは、学習によって構築されるだけでなく、別の知的システムによって解析され、修理され、プログラミングされる対象になり始めている。
#将来、フロンティアモデルの推論能力と、重み解析・実験・検証を行うHarnessが発展すれば、AIが別のAIの内部構造を改善する仕組みが、モデル開発の新しい工程として定着するかもしれない。
#そのとき、AI開発の競争力を決めるのは、モデルを大きくする能力や大量の計算資源を投入する能力だけではなくなる可能性がある。
#既存モデルの内部をどこまで理解できるか。
#必要な計算処理をどれほど効率よく実装できるか。
#変更によって生じる問題を、どれだけ正確に検証できるか。
#そして、その知識を次のモデル開発へどこまで蓄積できるか。
#『Sparks of Weight-Space Programming』は、まだ初期的な研究である。
#しかし、そこで示されたのは単なる性能改善の小技ではない。
#AIを作るためにAIを訓練するという方法に、AIがAIそのものを理解し、書き換えるという新しい経路が加わり始めたのである。
##
本記事は2026年11月3日時点の公開資料を基にした独立分析である。研究で確認された実験結果と、今後考えられる技術的・産業的な展望は区別して記述した。
#