AIデータセンターの「光」は誰が作っているのか――Tomahawk・Nova・Innolight・Leaf/Spineを一枚につなぐ
絶ノイアの章 Sil-Kathnaの章出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
2919e78a727b1ae316ecc000055168c685415e41fc94d680051199406fdebbd5- 保存版のSHA-256
9d022873f2ff5517fa3de05e28f4ab1f5bd77cc13ae7f41ffffa2f758d64e9e6
外部証明の最終検査結果は詳細を開くと表示します。
AIデータセンターの「光」は誰が作っているのか――Tomahawk・Nova・Innolight・Leaf/Spineを一枚につなぐ
#Innolight・Eoptolinkの台頭から、Tomahawk、Nova、NVLink、OSFP、Leaf/Spineまで読み解く
#2026年8月、AIインフラを追っていた人々の目が、突然二つの中国企業へ向いた。
#Zhongji Innolight(中際旭創)とEoptolink(新易盛)である。
#きっかけは8月4日のReuters報道だった。米国政府が国家安全保障上の理由から、中国製データセンター機器の「新型モデル」の輸入を制限する措置を準備しており、とりわけ光トランシーバーが対象として検討されている、と関係者が話したという。翌5日にはInnolight、Eoptolink、TFC Opticalなど中国の光関連銘柄が急落した。現時点では最終決定された全面禁止ではなく、FCCを中心に検討中の措置である点には注意が必要だ。(Reuters)
#なぜこのニュースがこれほど大きく反応されたのか。
#Reutersが引用した推計では、Innolightだけで世界の光トランシーバー市場のおよそ27%を握る。またReuters Breakingviewsは、中国企業全体では世界の光トランシーバー出荷の半分超を占めると整理している。(Reuters)
#ここで一つ疑問が生じる。
#それほどInnolightやEoptolinkが重要なのであれば、BroadcomのTomahawkやMarvellのNovaは一体何なのか。BroadcomやMarvellも光通信をやっているのではないのか。
#さらに、
#CoherentやLumentumとの違いは何なのか。
#そしてもう一つ。
#かつてCiscoがネットワーク市場を圧倒していたという話を目にする。それなのに、なぜ現在のAIデータセンターでは中国のInnolightやEoptolinkの名前がこれほど前面に出てくるようになったのだろうか。
#この疑問を解くには、「光トランシーバー市場」という一つの箱として考えるのをやめる必要がある。
#AIデータセンターの通信は、
#GPU → PCIe/NVLink → NIC → SerDes/PHY → 光DSP → 光トランシーバー → Fiber → Leaf Switch → Spine Switch
#という複数の階層からできており、それぞれを別の企業が握っている。
#この記事では、そこから順番に分解していく。
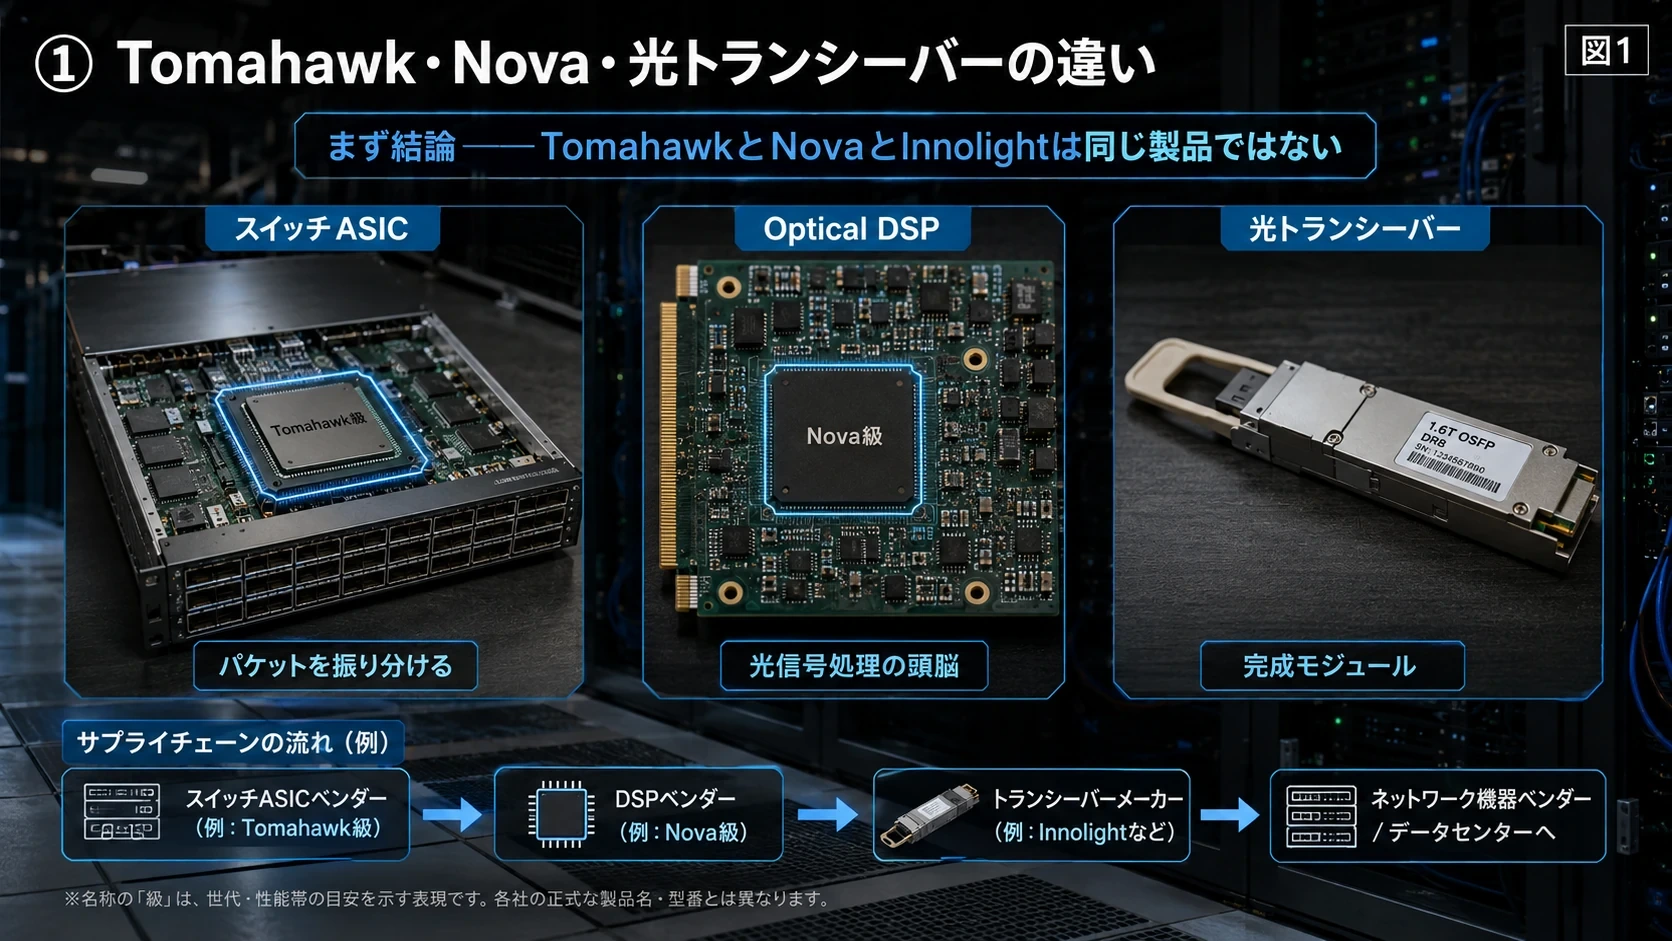
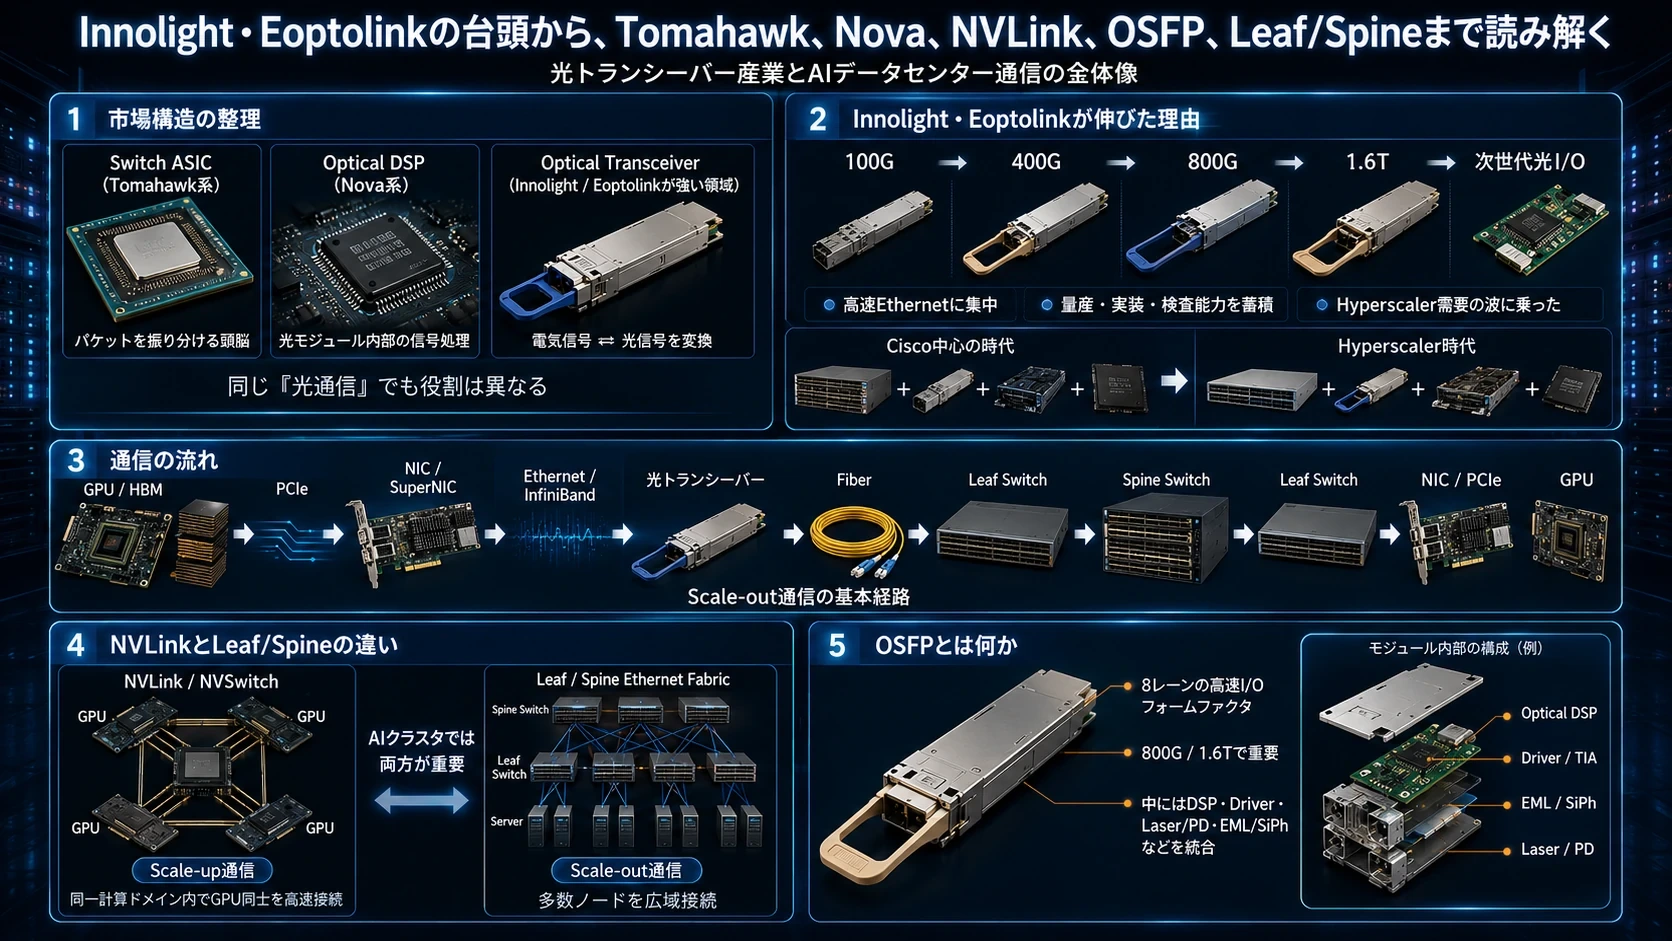
#1 まず結論――TomahawkとNovaとInnolightは同じ製品ではない
#最初に最も重要な整理をしておこう。
#| 名前 | 主なもの | 役割 |
|---|---|---|
| Broadcom | Tomahawk | Switch ASIC。パケットをどのポートへ送るか決める |
| Marvell | Nova / Nova 2 | Optical DSP。高速電気信号と光側信号の間を補正・整形する |
| Innolight | 光トランシーバーメーカー | DSP・レーザー・SiPh等を統合して完成モジュール化 |
| Eoptolink | 光トランシーバーメーカー | 同上 |
| Coherent | 光素子+SiPh+トランシーバー | より垂直統合的 |
| Lumentum | EML/CWレーザー+トランシーバー | 光源・光半導体が特に強い |
| NVIDIA | Spectrum | Switch ASIC/スイッチ。Ethernetネットワークを制御 |
| NVIDIA | NVLink/NVSwitch | Scale-up interconnect。GPU同士を極低遅延・高帯域で接続 |
BroadcomのTomahawk 6は、単一チップで最大102.4Tb/sのEthernet switching capacityを持つスイッチASICであり、200G SerDesまで備える。つまり光トランシーバーではない。(Broadcom)
#一方、Marvell Nova 2は1.6Tb/s PAM4 Optical DSPである。8本の200Gb/s電気インターフェースと8本の200Gb/s光側インターフェースを持ち、1.6T光トランシーバーを作るための半導体だ。(Marvell Technology)
#そしてInnolightやEoptolinkは、このようなDSPやレーザー、変調器、受光器、SiPhなどを一つの小さなOSFPモジュールへ統合する。
#したがって、
#Tomahawk = 道路の交差点を制御する頭脳
#Nova = 光モジュールの信号処理を行う頭脳
#Innolight / Eoptolink = それらの部品を使って 実際に光ファイバーへ接続できる完成モジュールを作る
#という関係になる。
#図解|Switch ASIC・Optical DSP・光トランシーバの違い
#
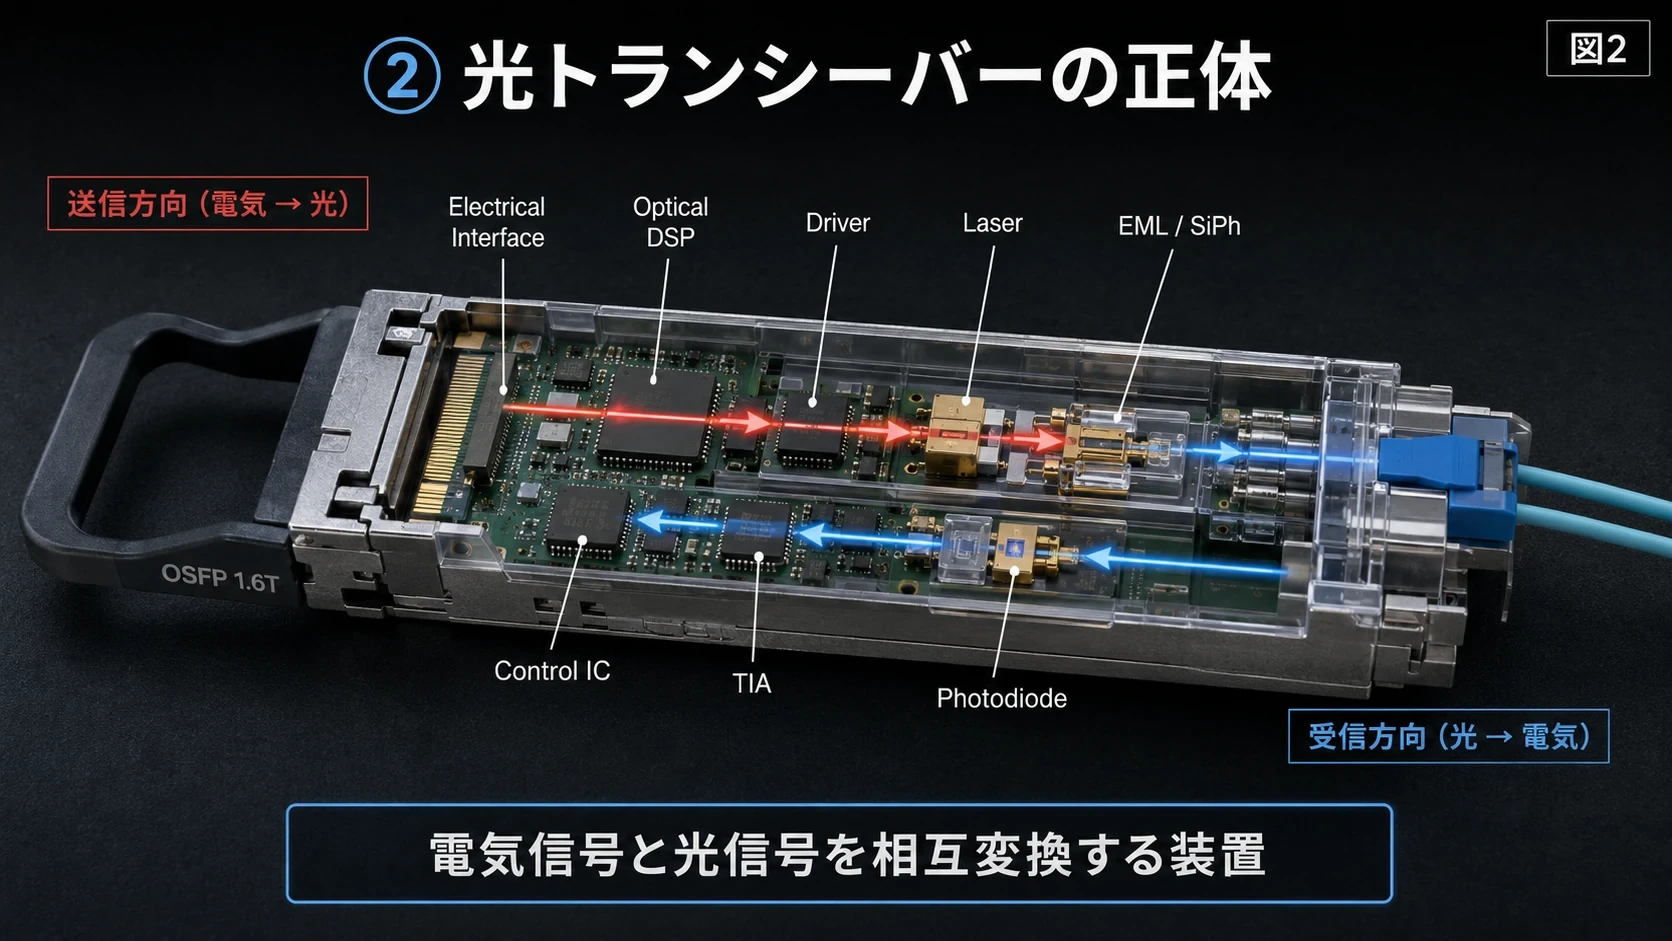
2 そもそも光トランシーバーとは何なのか
#光トランシーバーは簡単にいえば、
#電気信号 ⇄ 光信号
#を相互変換する装置である。
#例えばLeaf SwitchからSpine Switchへ1.6Tb/sのデータを送りたいとする。
#Switch ASIC
│
│ 電気信号
▼
1.6T Optical Transceiver
│
│ 光信号
▼
Fiber
│
▼
1.6T Optical Transceiver
│
│ 電気信号
▼
Spine Switch ASIC光ファイバーそのものには、GPUのbit列を電気のまま流すことはできない。
#そこで光トランシーバー内部で電気信号をレーザー光の変化へ変える。
#典型的なDSP型1.6Tモジュールなら、
#┌──────────── 1.6T OSFP ────────────┐
#Electrical Interface
│
▼
Optical DSP
│
▼
Driver
│
▼
Laser / Modulator
EML または SiPh
│
▼
FiberFiber
│
▼
Photodiode
│
▼
TIA
│
▼
Optical DSP
│
▼
Electrical Interface└───────────────────────────────────┘
#という構造になる。
#したがってトランシーバーは「変調器」そのものでも、「レーザー」そのものでもない。
#レーザー、変調器、受光器、Driver、TIA、DSP、制御回路、光学実装、ファイバー結合などを一つにまとめた通信装置なのである。
#図解|光トランシーバの内部
#
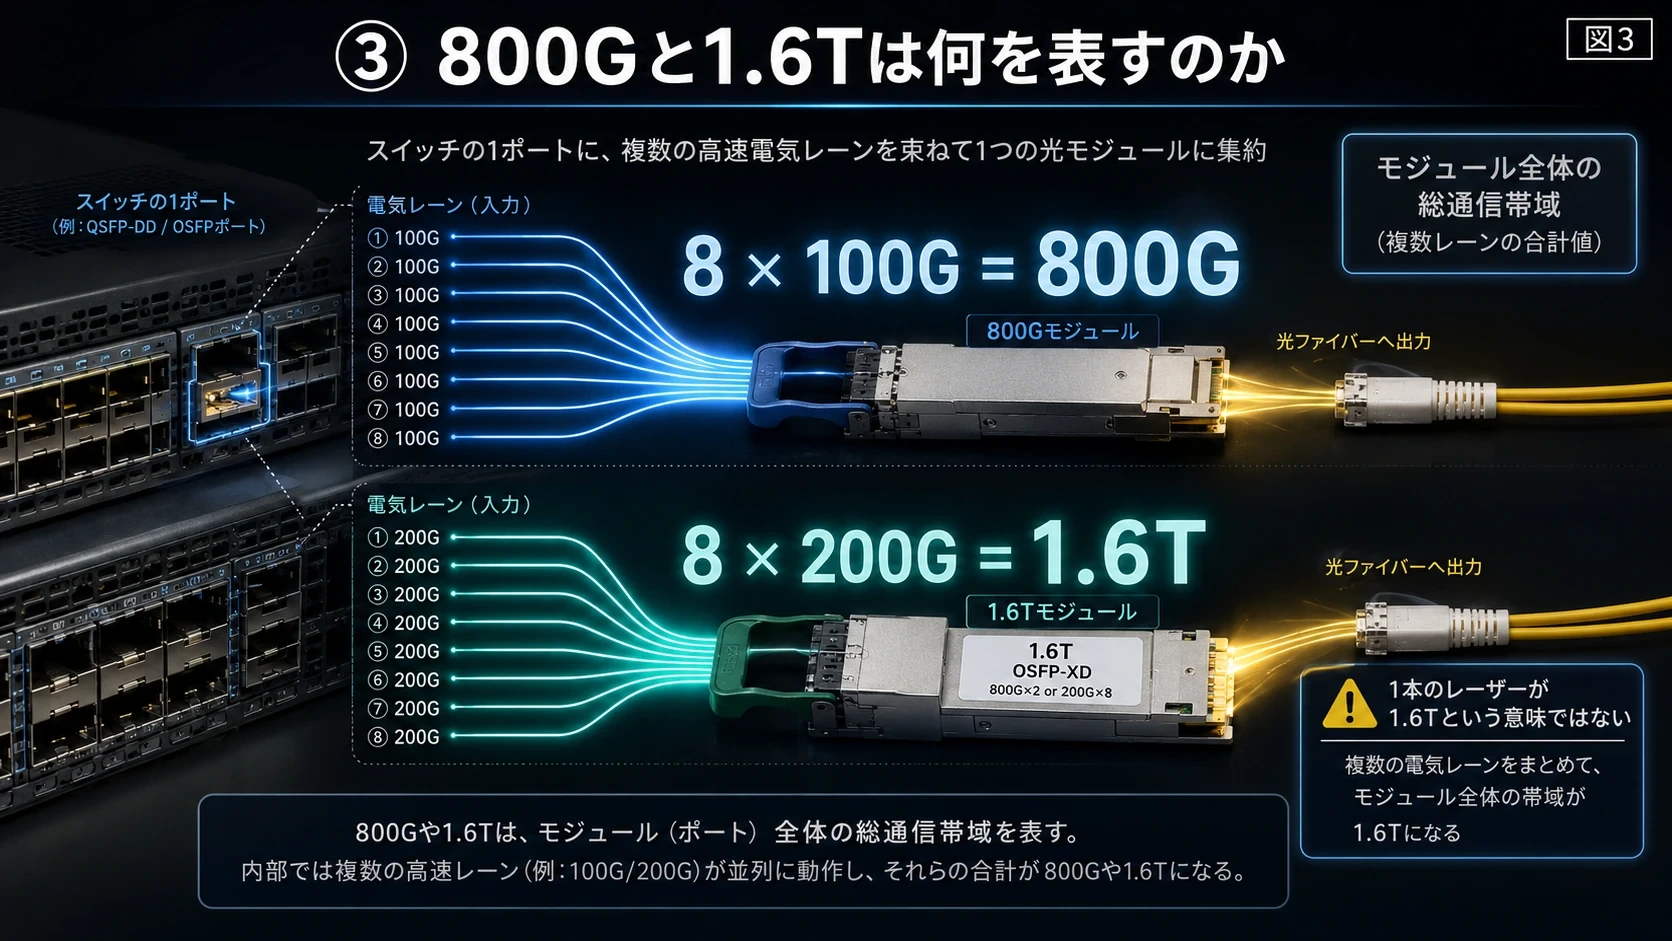
3 800Gや1.6Tとは、何が800G・1.6Tなのか
#ここも非常に重要だ。
#「1.6Tレーザー」という意味ではない。
#1.6Tとは、
#1.6 terabit per second
#つまり、その光トランシーバーが片方向に扱える総通信帯域を表している。
#現在の代表例なら、
#200 Gb/s × 8 lane = 1.6 Tb/s
#となる。
#OSFP規格も8本の高速電気レーンを基本とし、
#8 × 50G = 400G 8 × 100G = 800G 8 × 200G = 1.6T
#まで拡張されている。(OSFPmsa)
#したがって、
#800G → 1.6T
#とはモジュールが単純に大きくなったという意味ではない。
#1本あたりの信号速度を、
#100G/lane
↓
200G/laneへ上げることで、同じ8レーンから2倍のデータを運ぶようになったのである。
#なお「200G」という言葉には注意が必要だ。
#200Gは「200Gモジュール全体」を指す場合もあれば、
#200G/lane
#を意味する場合もある。
#現在1.6Tについて議論するときの200Gは、多くの場合後者である。
#図解|800Gと1.6Tの意味
#
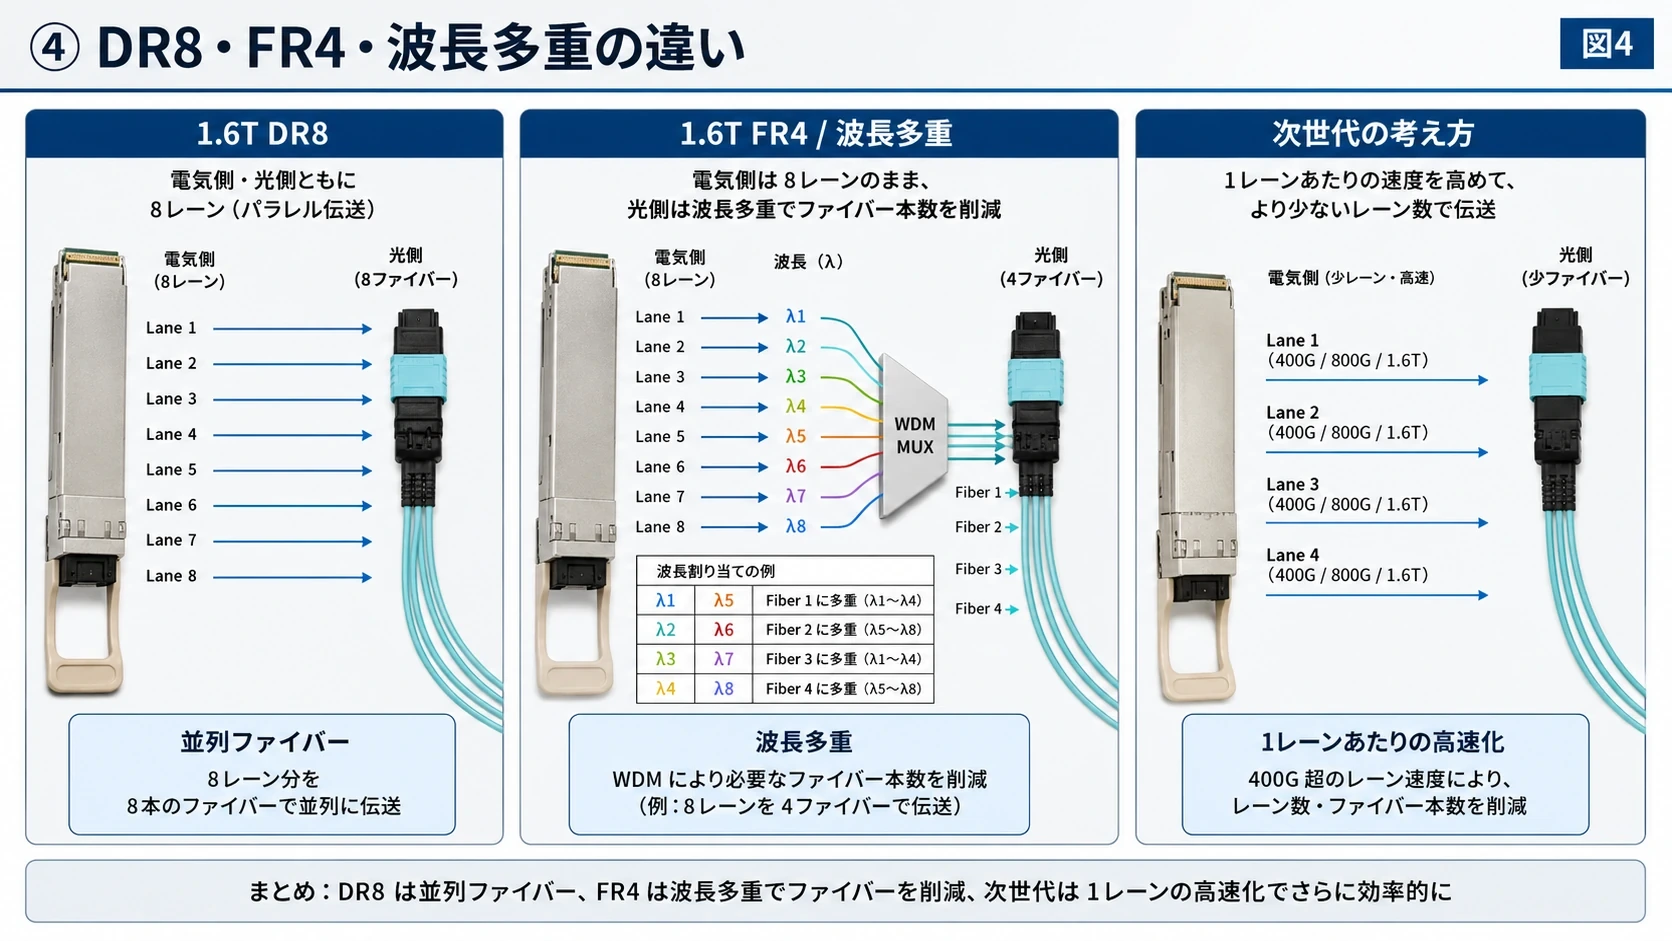
4 電気側と光側ではレーン構成が違うこともある
#例えば1.6T DR8なら、
#Electrical
200G × 8
↓
Optical DSP
↓
Optical
200G × 8
↓
1.6Tで比較的分かりやすい。
#しかし波長多重を使えば、
#λ1
λ2
λ3
λ4
↓
WDM
↓
1本のFiberのように複数波長を一本のファイバーへまとめることができる。
#Eoptolinkは2023年時点ですでに200G/lambdaを使う1.6T製品を公開しており、EML、Silicon Photonics、TFLNなど複数の変調技術を評価していた。(Eoptolink)
#つまり今起きている競争は単なる「800Gを1.6Tにする」競争ではない。
#1波長、1レーンあたり何Gb/sまで引き上げられるのか
#という競争でもある。
#図解|DR8・FR4・波長多重
#
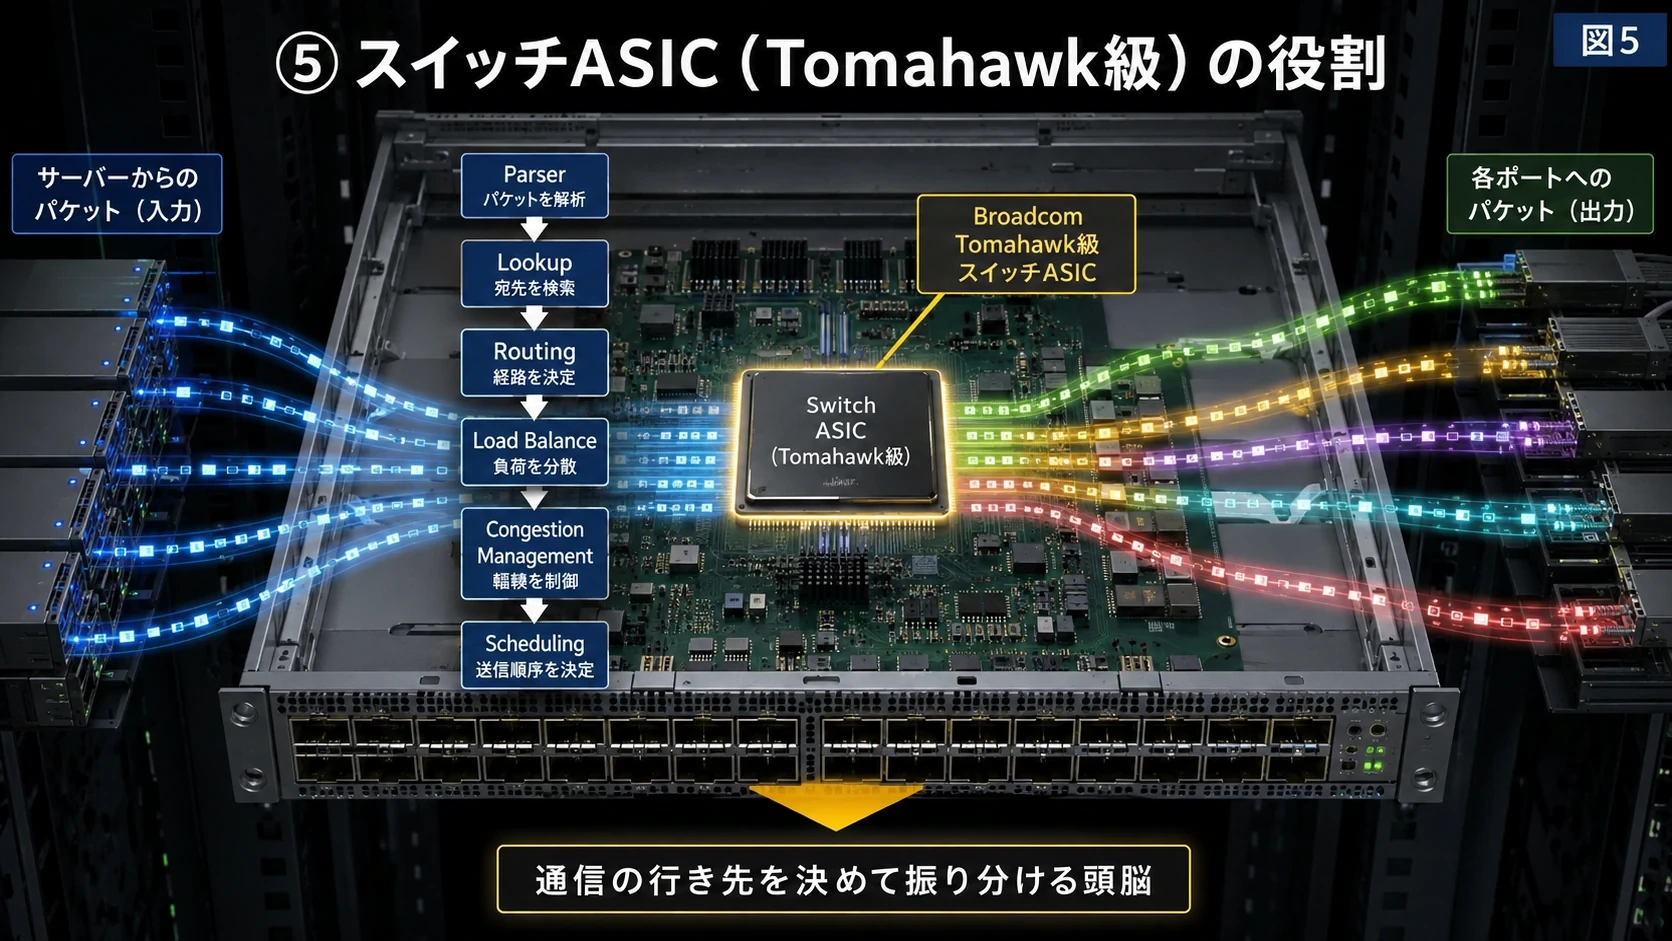
5 Broadcom Tomahawkとは何なのか
#ではSwitch ASICへ進もう。
#Broadcom Tomahawkは、
#大量のパケットを受け取り、それぞれを正しい出口へ猛烈な速度で振り分けるASIC
#である。
#例えばLeaf Switchへ次の通信が同時に入る。
#GPU 1 → GPU 105 GPU 2 → GPU 42 GPU 3 → GPU 900 GPU 4 → GPU 22 GPU 5 → GPU 781
#Switch ASICはそれぞれのパケットを解析して、
#Input
│
▼
┌──────────────────┐
│ Switch ASIC │
│ │
│ Parser │
│ Lookup │
│ Routing │
│ Load Balance │
│ Congestion Mgmt │
│ Scheduling │
└──────┬───────────┘
│
┌─────┼─────┐
▼ ▼ ▼
Port1 Port8 Port32と振り分ける。
#Tomahawk 6は102.4Tb/sのスイッチング能力を1チップで実現し、100G/200G SerDesとAIクラスタ向けのロードバランシング、輻輳管理機能を備える。(Broadcom)
#つまりTomahawkは、
#光を作る装置ではなく、通信の行き先を決める装置
#である。
#図解|Switch ASICの役割
#
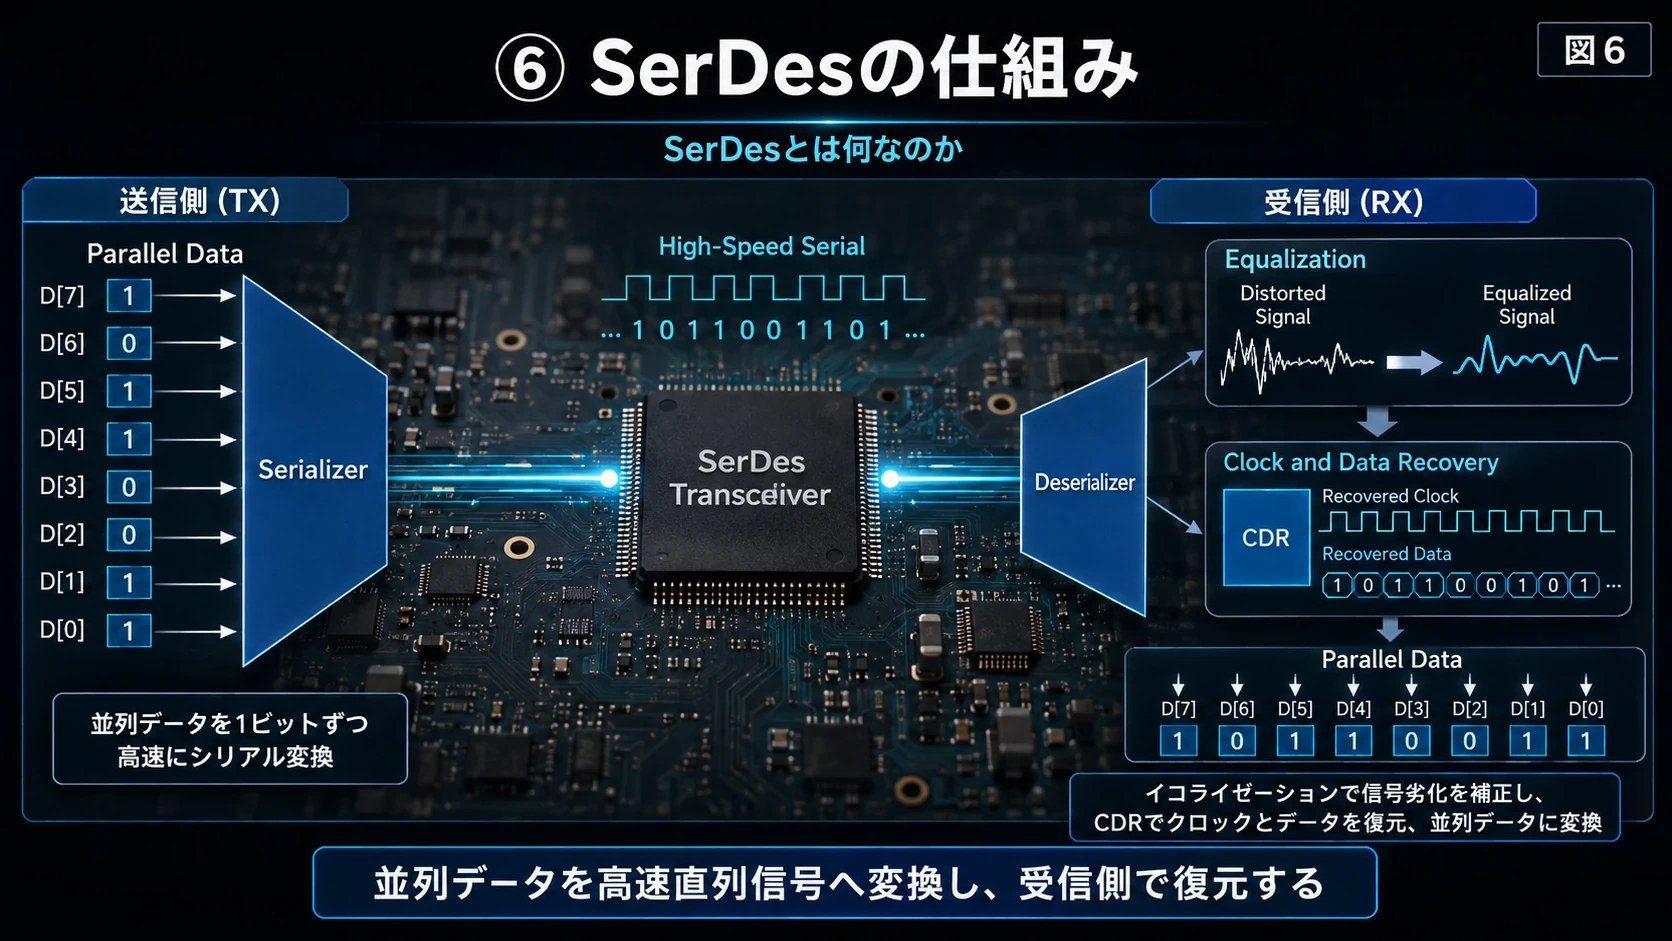
6 SerDesとは何なのか
#ただしSwitch ASICの仕事はパケット処理だけではない。
#ASICの端には大量のSerDesがある。
#SerDesとは、
#Serializer / Deserializer
#の略である。
#チップ内部では大量のデータを並列に処理できても、そのまま何千本もの配線を外へ出すことはできない。
#そこで、
#Parallel Data
#D0 ─┐
D1 ─┤
D2 ─┤
D3 ─┤
D4 ─┤
D5 ─┤
D6 ─┤
D7 ─┘
│
▼
Serializer
│
▼図解|SerDesの直列化と復元
#
101101001101010...
#と高速serial信号へ変換する。
#受信側では逆に、
#Serial
↓
Deserializer
↓
Parallelへ戻す。
#しかも現在のSerDesは、単なる直列変換器ではない。
#高速電気信号はPCBやコネクタを通るうちに、
#信号損失、ISI、ジッタ、ノイズなどによって波形が崩れる。
#そのためEqualizationやCDR――Clock and Data Recovery――などを使って、
#崩れた信号から元のbitとクロックを復元する
#必要がある。
#BroadcomもSerDesをGPU/XPU、NIC、Switch、Retimer、Optical DSPをつなぐAIインフラの基礎技術として位置づけている。(Broadcom)
#したがってSwitch ASICは「信号を増幅するもの」というより、
#データを読み直し、処理し、きれいな新しい高速信号として次のリンクへ送る
#と理解した方が近い。
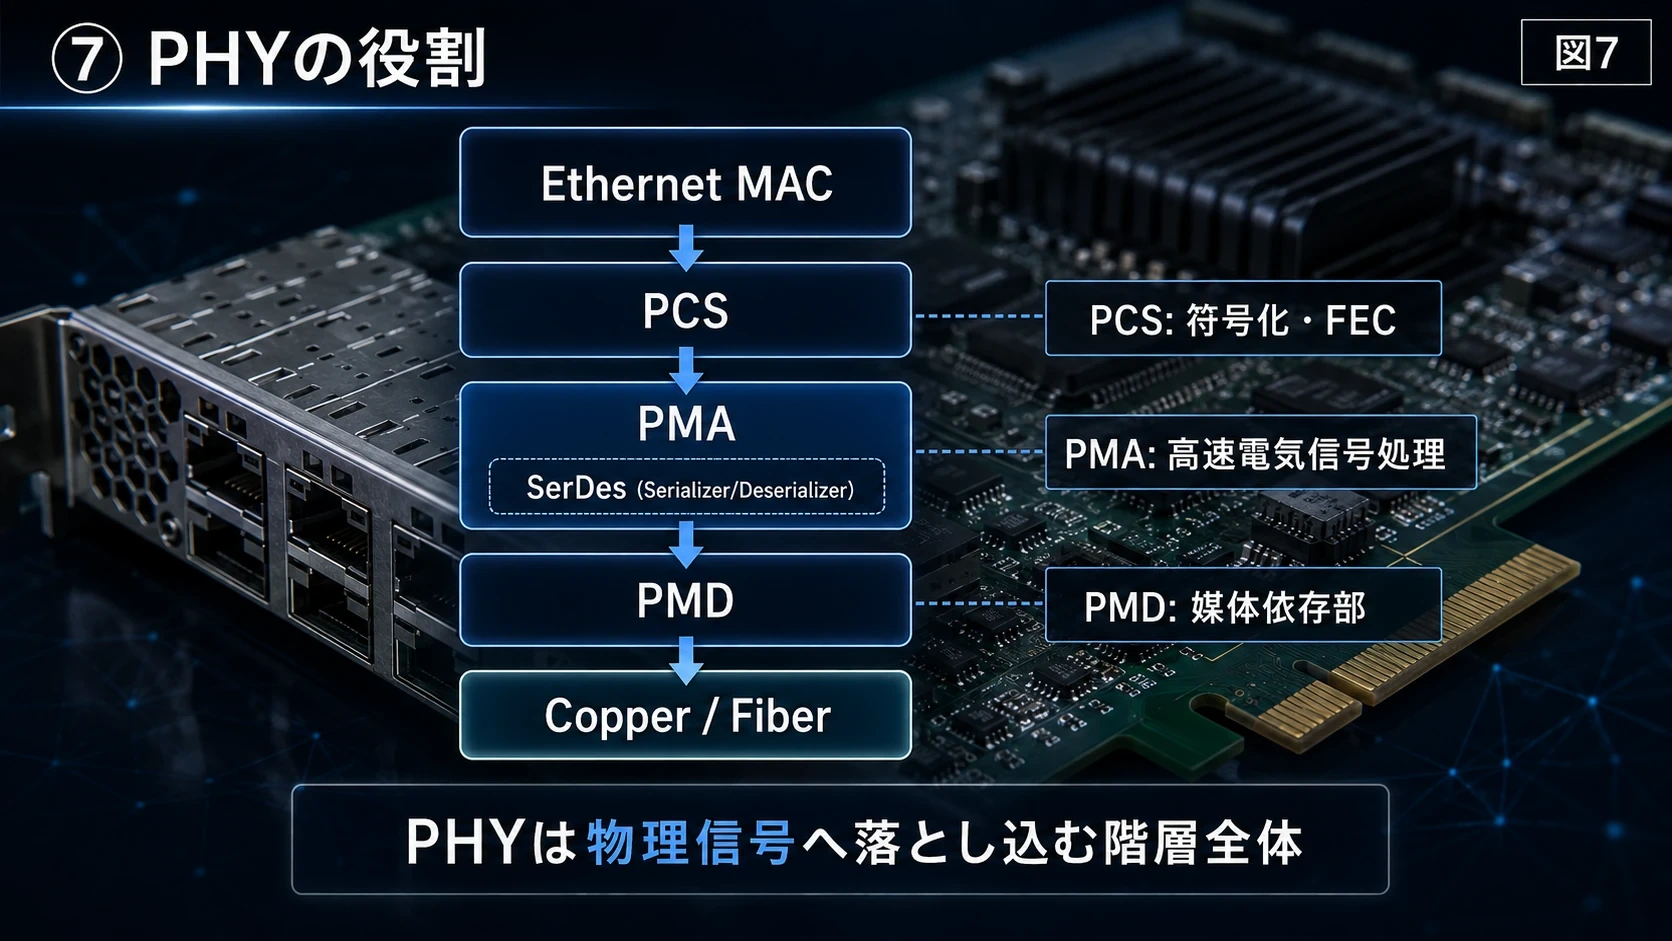
#7 PHYとは何なのか
#PHYはPhysical Layer、つまり物理層である。
#SerDesはPHYを構成する非常に重要な部分だが、
#SerDes=PHY
#ではない。
#概念的には、
#Ethernet MAC
│
▼
PCS
│
▼
PMA
│
└── SerDes
│
▼
PMD
│
▼
Copper / Fiberという階層になっている。
#PCSでは符号化、レーン分配、FECなどを扱い、PMAではSerDesなど高速電気信号を扱う。
#その先のPMDは実際の伝送媒体に依存する。
#つまりPHYとは、
#論理的なEthernetデータを、実際にケーブルや光ファイバーを通る物理信号へ落とし込む一連の階層
#なのである。
#図解|PHYの階層
#
8 ではMarvell Novaは何をしているのか
#TomahawkとNovaを混同しやすい理由がここにある。
#どちらも高速通信半導体だが、役割が違う。
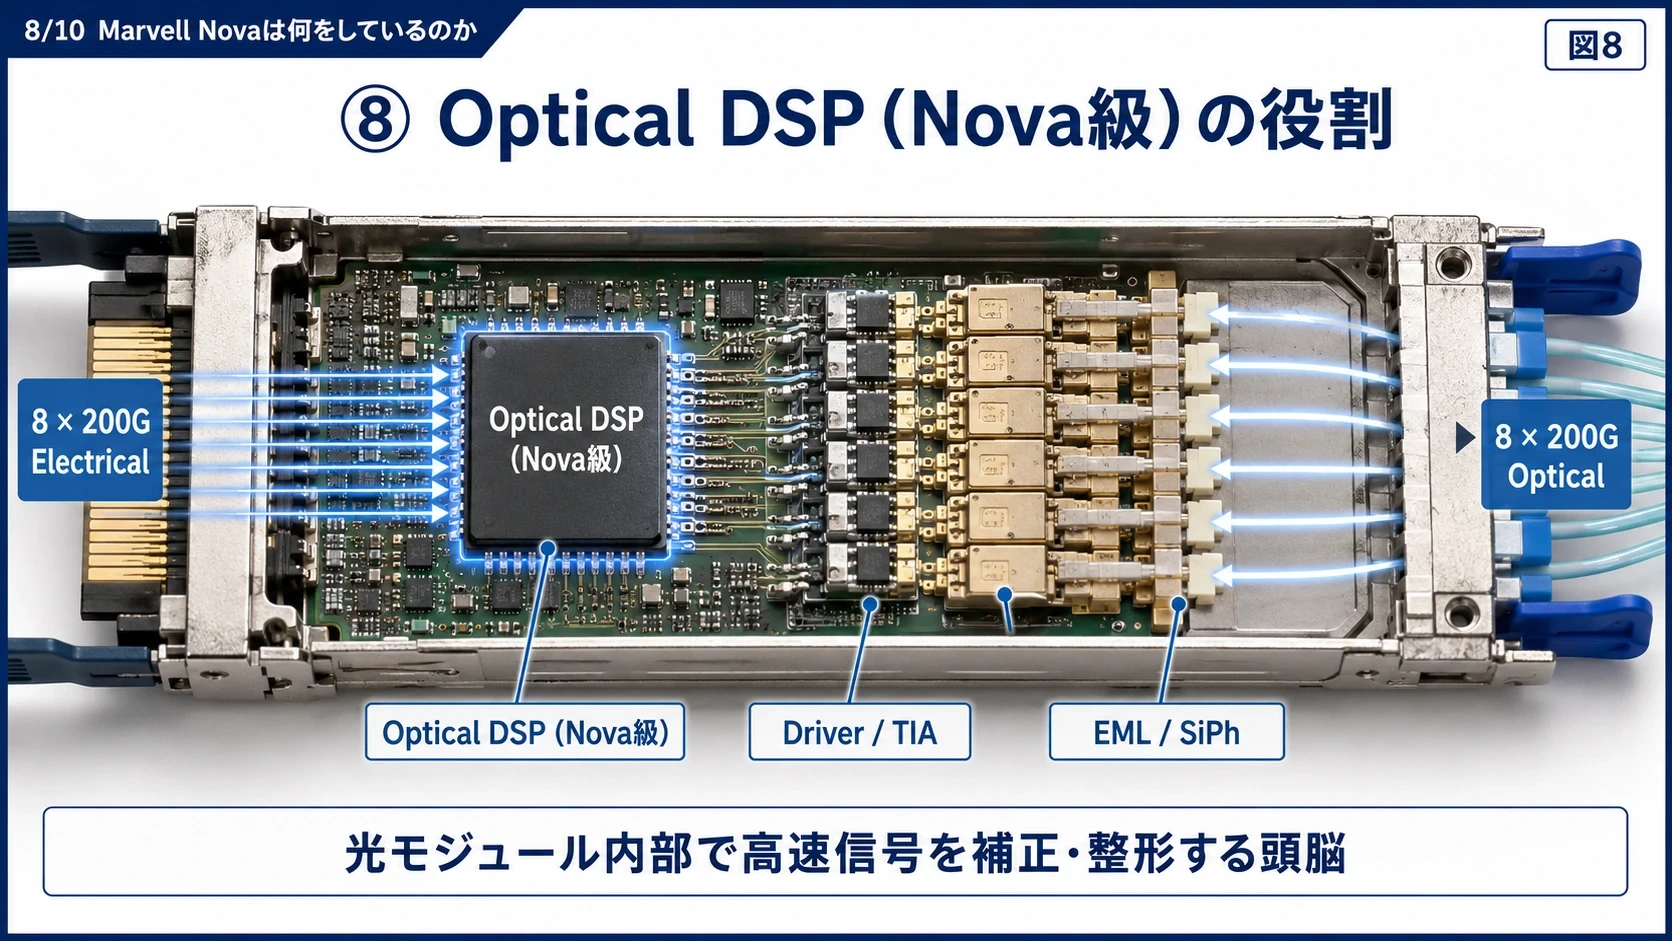
#Marvell Nova 2は1.6T Optical DSPである。
#具体的には、
#Switch / NIC
#8 × 200G electrical
│
▼
┌──────────────────┐
│ Marvell Nova 2 │
│ Optical DSP │
└────────┬─────────┘
│
8 × 200G optical side
│
▼
Driver / EML / SiPh
│
▼
Fiberという位置に入る。
#MarvellによればNova 2は8本の200Gb/s host electrical interfaceと8本の200Gb/s optical interfaceを持つ。(Marvell Technology)
#したがって、
#Tomahawk=Switchの頭脳
#Nova=光トランシーバー内部の信号処理の頭脳
#である。
#図解|Optical DSPの役割
#
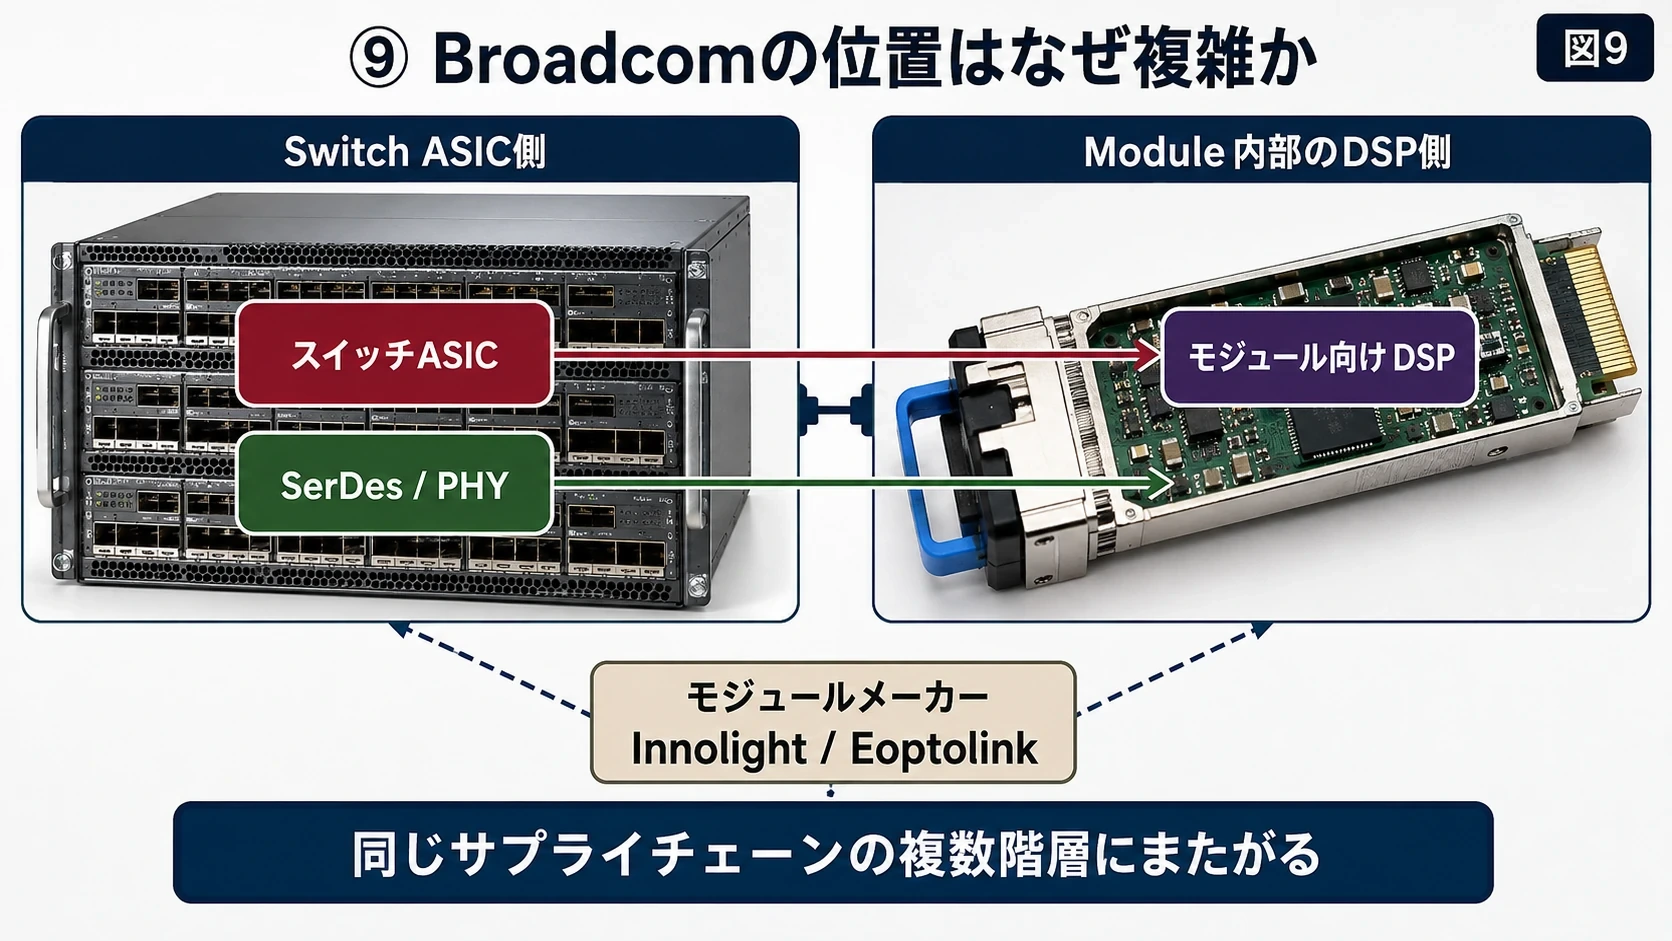
9 Broadcomはさらにややこしい
#Broadcomが理解しにくい理由は、
#両方やっている
#からだ。
#BroadcomにはTomahawkというSwitch ASICがある一方で、光モジュール向けDSP、PHY、SerDes、VCSELなどの光通信部品もある。
#したがって同じネットワークの中に、
#Broadcom Switch ASIC
│
▼
Innolight / Eoptolink Module
│
└─ 内部にBroadcom DSPという構成が存在してもおかしくない。
#実際Eoptolinkは400G時代、Broadcomの7nm PAM4 Optical Platformを使った400G DR4/FR4モジュールを量産していた。Broadcom自身も、光モジュールメーカーが同社のPHY、PMD IC、III-V光部品を組み合わせられることを説明している。(Eoptolink)
#さらにMarvellのNova 2発表ではInnolightの幹部がコメントしており、Nova 2とInnolightの高速トランシーバー設計・量産能力を組み合わせる関係が明記されている。(Marvell Technology)
#つまりこれは、
#米国製DSP vs 中国製光モジュール
#という単純な対立構造ではない。
#実際には極めて深く相互依存したサプライチェーンなのである。
#図解|Broadcomの二つの位置
#
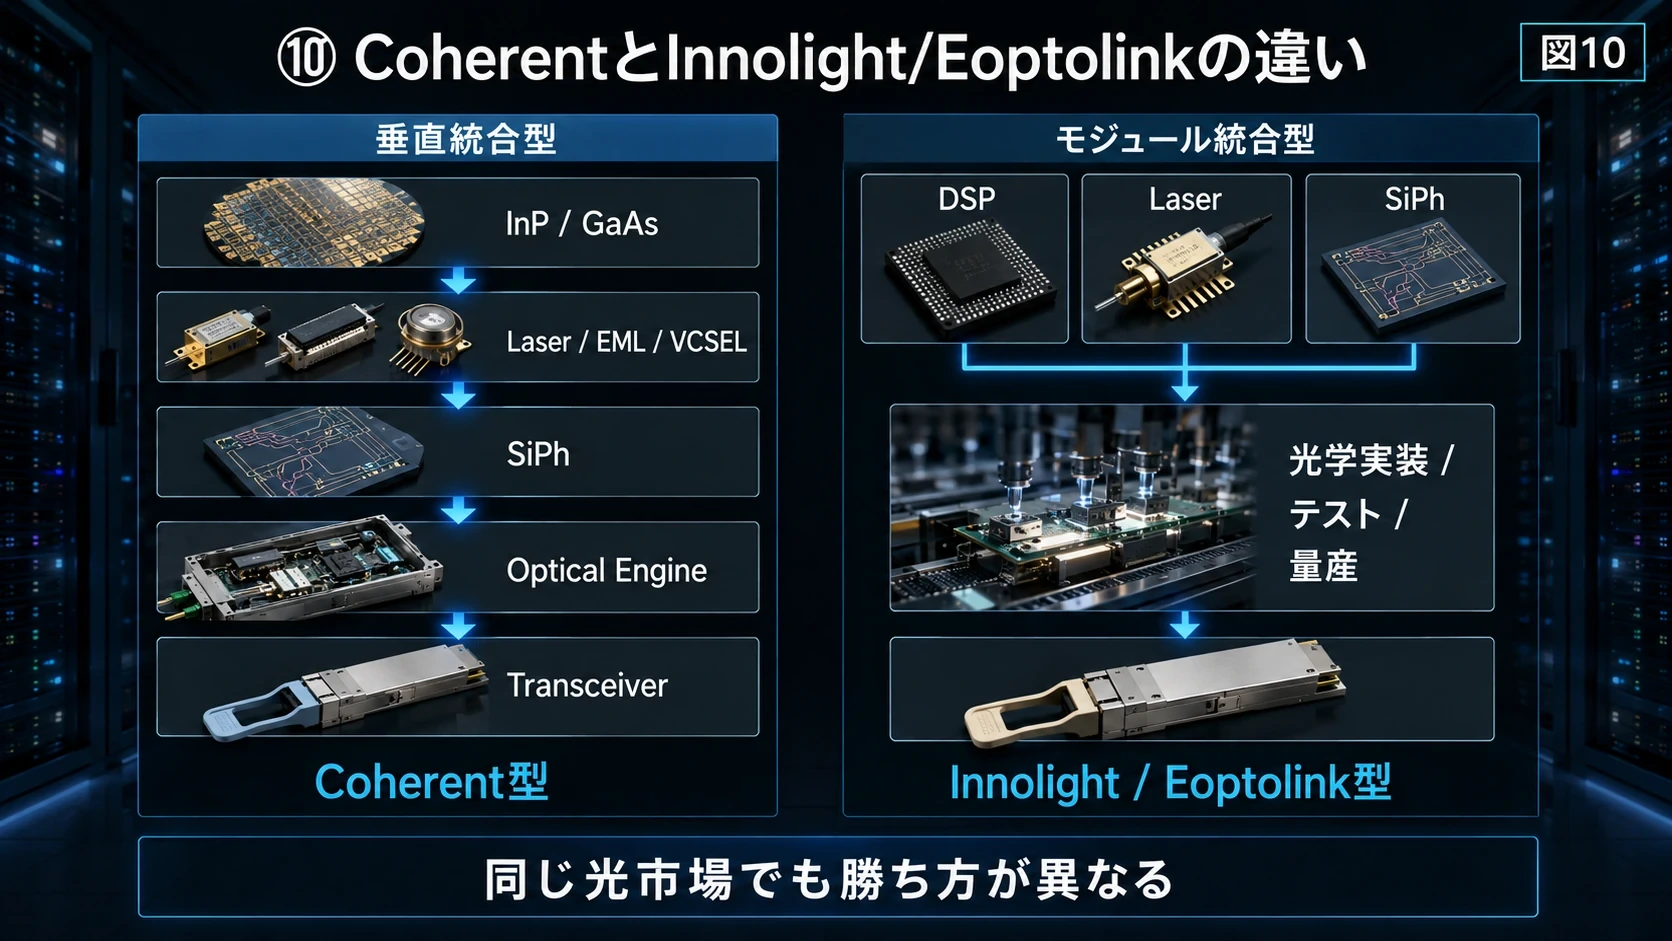
10 CoherentはInnolightと何が違うのか
#Coherentはかなり特殊だ。
#InnolightやEoptolinkが高速光モジュールの設計・量産に特化した「スペシャリスト」に近いのに対し、Coherentは、
#材料
↓
InP / GaAs
↓
Laser / VCSEL / EML
↓
SiPh
↓
Driver / TIA
↓
Optical Engine
↓
完成Transceiverまでかなり広く持つ。
#現在のCoherentは、旧II-VIが2019年にFinisarを買収し、さらに2022年に旧Coherentを買収してCoherent Corp.へ改称した会社である。Finisarは長年、世界最大級の光トランシーバー企業だった。(Coherent Inc)
#現在もCoherentはSiPh、InP CWレーザー、200G EML、200G VCSELなど複数の光技術を持ち、1.6Tモジュールまで自社で作っている。(Coherent Inc)
#2025年には、Coherentの1.6T DR8 SiPhトランシーバーの内部でMarvell Ara 3nm Optical DSPを使用する実演も公開された。(Coherent Inc)
#つまりCoherentでさえすべての半導体を100%自社製にするとは限らない。
#どこを内製し、どこを外部DSPに任せるかを柔軟に選べる垂直統合型企業
#と見る方が正しい。
#図解|垂直統合型とModule統合型
#
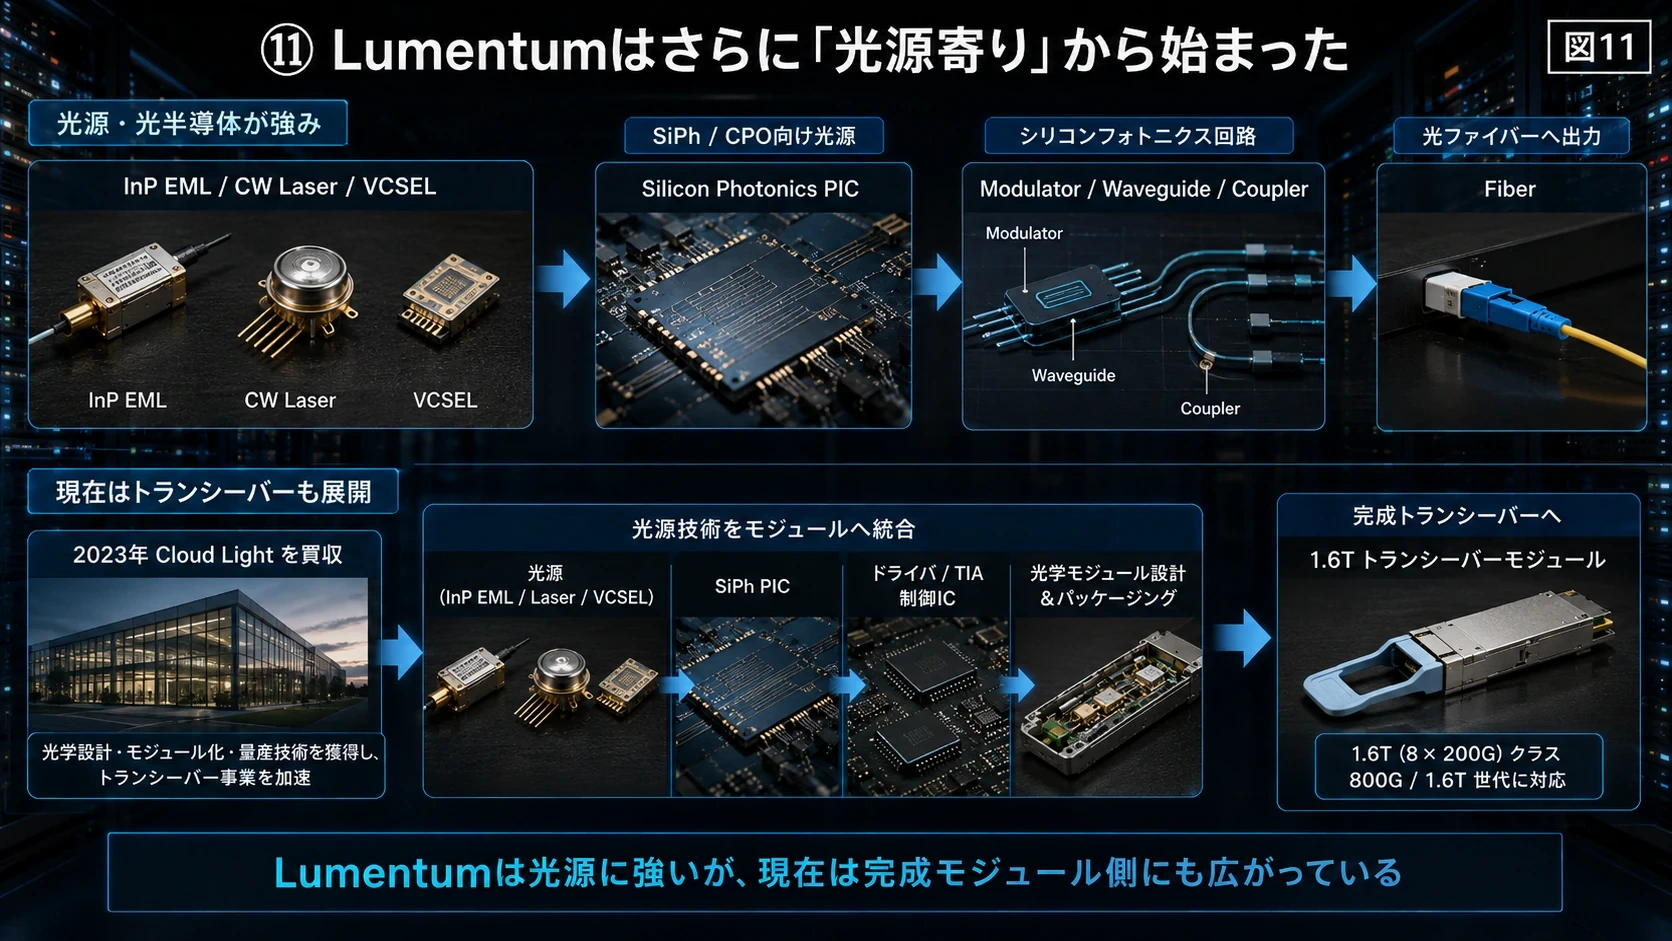
11 Lumentumはさらに「光源寄り」から始まった
#Lumentumは2015年、JDSUのCommunications and Commercial Optical Products事業が分離されて誕生した。(Lumentum Investor Relations)
#特に強いのが、
#InP EML、CW Laser、VCSELなど光半導体
#である。
#例えばLumentumの200G EMLは、8本使えば1.6Tトランシーバーを構成できる。(Lumentum)
#Silicon Photonicsでもレーザーそのものまでシリコンで作るとは限らない。
#典型的には、
#InP CW Laser
│
▼
Silicon Photonics PIC
│
├─ Modulator
├─ Waveguide
└─ Coupler
│
▼
Fiberとなるため、LumentumやCoherentのCW InPレーザーが重要になる。Lumentum自身もCWレーザーを400G、800G、1.6T SiPh/CPO向け光源として位置づけている。(Lumentum)
#ただしLumentumも現在は純粋な部品メーカーではない。
#2023年にCloud Lightを買収してデータセンター向け光トランシーバーへ再拡大し、現在は1.6Tトランシーバーも展開している。(Lumentum)
#図解|Lumentumの光源からModuleへの展開
#
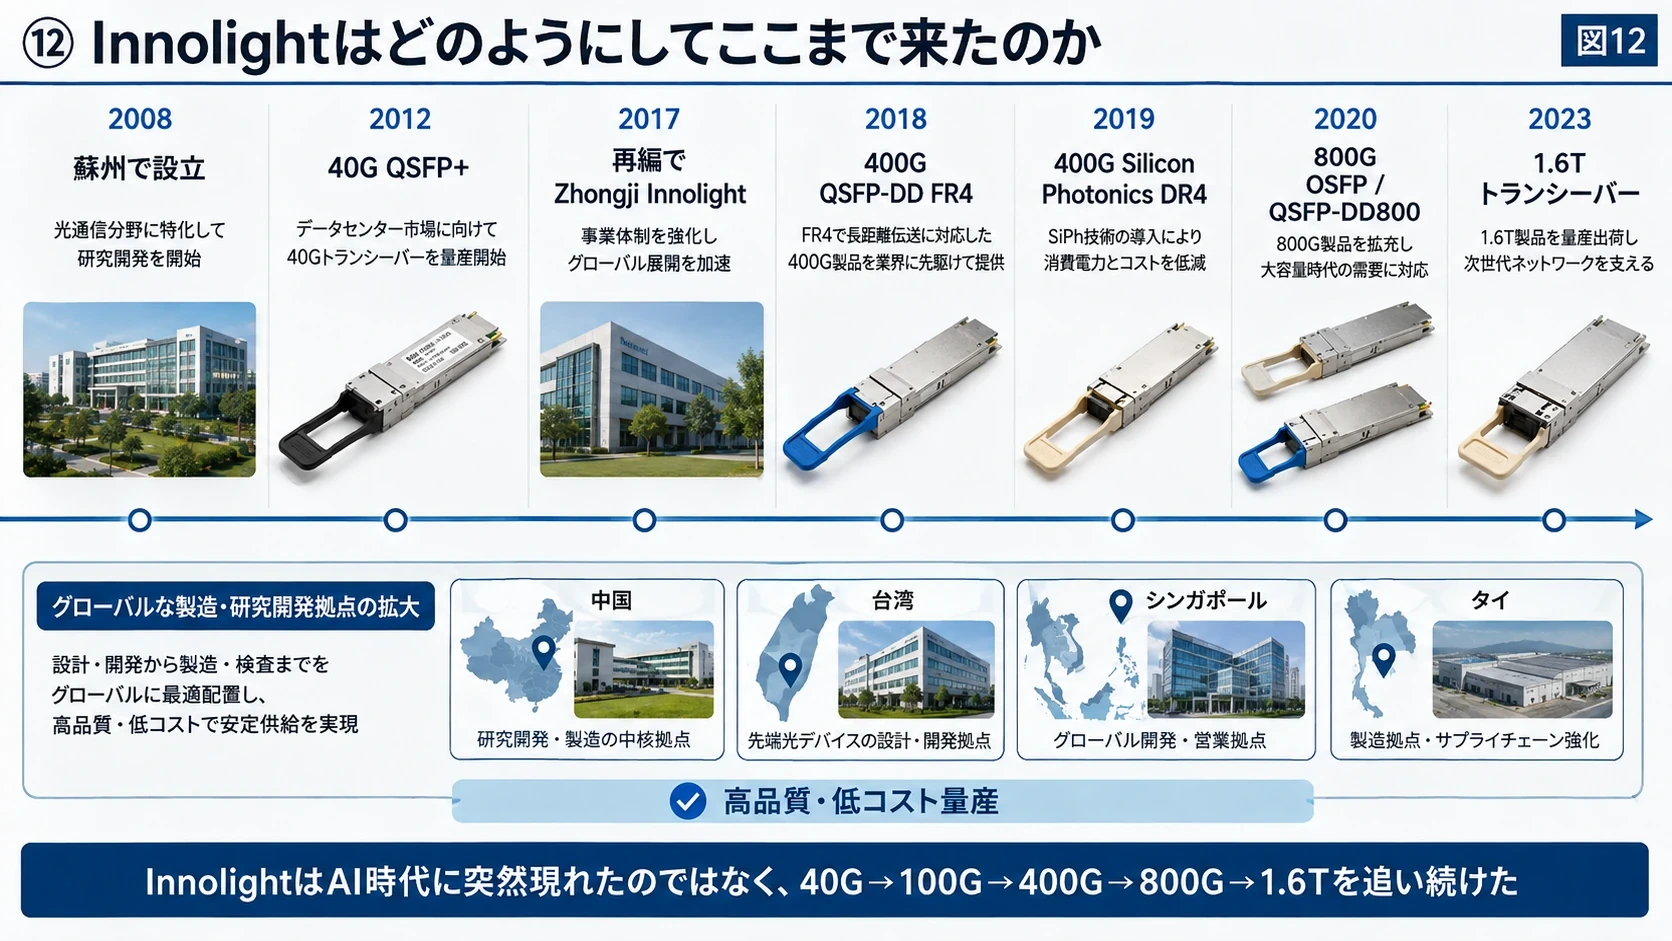
12 Innolightはどのようにしてここまで来たのか
#Innolightの歴史を見ると、AIブームで突然現れた会社ではないことが分かる。
#2008年に蘇州で光トランシーバー企業として設立。
#2012年には40G QSFP+。
#2017年に上場企業の中際電工と再編してZhongji Innolightとなった。
#2018年には400G QSFP-DD FR4。
#2019年には400G Silicon Photonics DR4。
#2020年には800G OSFP/QSFP-DD800。
#2023年には1.6Tトランシーバーへ到達した。(InnoLight)
#つまり、
#40G
↓
100G
↓
400G
↓
800G
↓
1.6TというデータセンターEthernet高速化の波をほぼ正面から追い続けた会社である。
#さらに中国だけでなく、台湾、シンガポール、タイなどへR&D・製造機能を広げている。Innolightはタイの高量産工場について、高品質と低コストで世界顧客を支える拠点と説明している。(InnoLight)
#図解|Innolightの高速化史
#
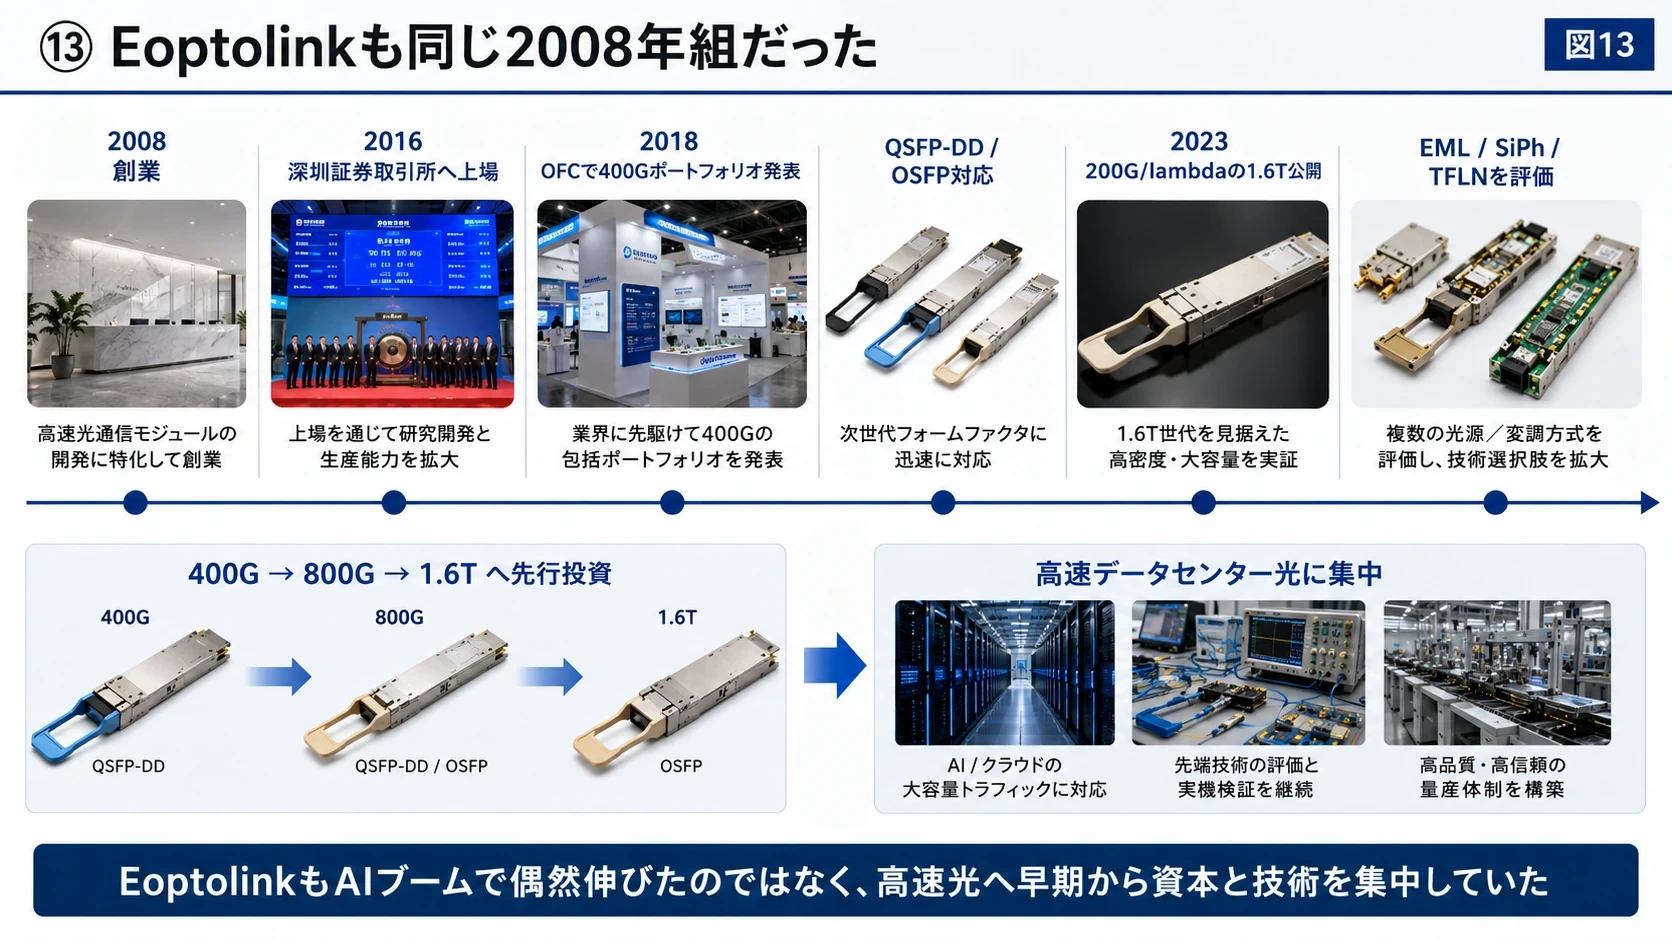
13 Eoptolinkも同じ2008年組だった
#Eoptolinkも2008年創業である。
#2016年3月3日に深圳証券取引所へ上場した。(Eoptolink)
#2018年のOFCではすでに400Gポートフォリオを発表し、QSFP-DDとOSFPの双方へ対応していた。(Eoptolink)
#2023年には200G/lambdaを使った1.6Tを公開し、EMLだけでなくSiPh、TFLNまで評価している。(Eoptolink)
#つまりEoptolinkも、
#低速光モジュールを大量に作っていた会社がAIブームで偶然伸びた
#というより、
#400G→800G→1.6Tという高速データセンター光にかなり早い段階から資本と技術を集中していた
#会社なのである。
#図解|Eoptolinkの高速化史
#
14 なぜ中国勢が強くなったのか
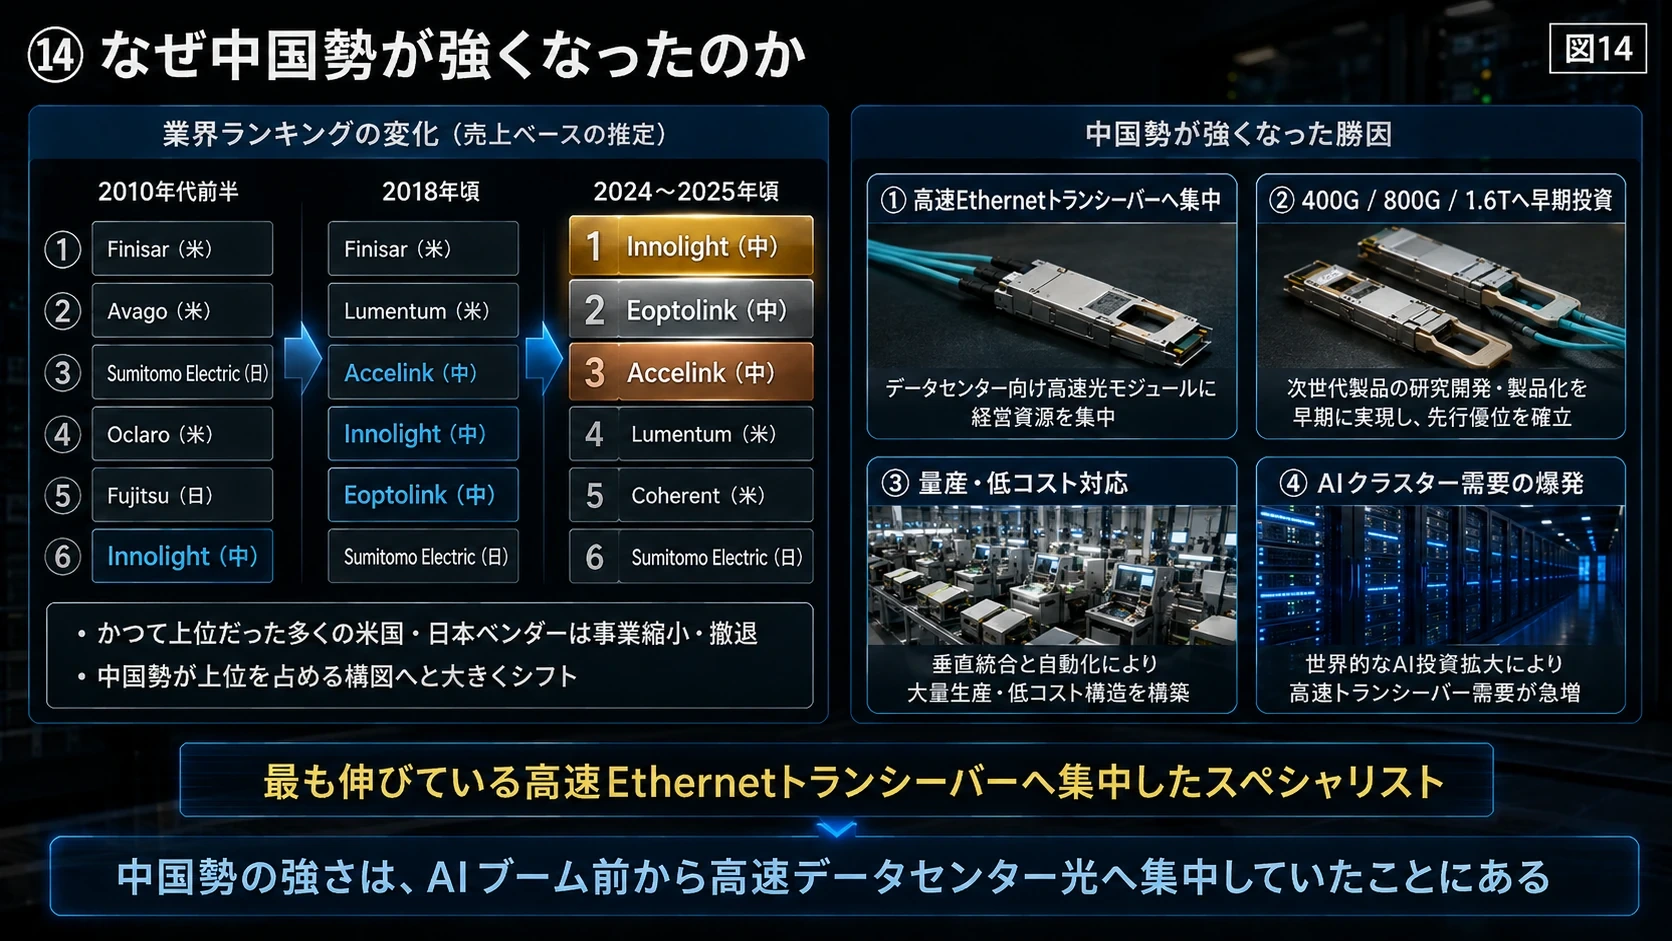
#ここでLightCountingの15年間のランキング変化が非常に重要になる。
#LightCountingによれば、2018~2020年までに多くの日本・米国系メーカーが光トランシーバー市場から退出・縮小する一方、中国企業が順位を上げていった。Innolightは2023年に初めて世界1位となり、2024年売上は33億ドル超、Eoptolinkは2024年に前年比175%増の12億ドルとなって7位から3位へ急浮上した。(LightCounting)
#そして2025年。
#LightCountingでは、
#1位 Innolight
#2位 Eoptolink
#となり、EoptolinkはCoherentを抜いた。
#Innolightの2025年売上はLightCounting集計で約53億ドル、Eoptolinkは約35億ドル。Eoptolinkは400G/800GでAmazonの主要サプライヤーとなり、NVIDIAなど他の米国大手でも認定を広げたとされる。(LightCounting)
#LightCountingはこの2社について、非常に端的な説明をしている。
#両社は、
#最も伸びている高速Ethernetトランシーバーへほぼ集中した「スペシャリスト」
#なのである。(LightCounting)
#図解|高速Ethernet集中戦略
#
15 なぜかつての米国・日本勢は後退したのか
#これは技術で負けただけ、と見ると不十分だ。
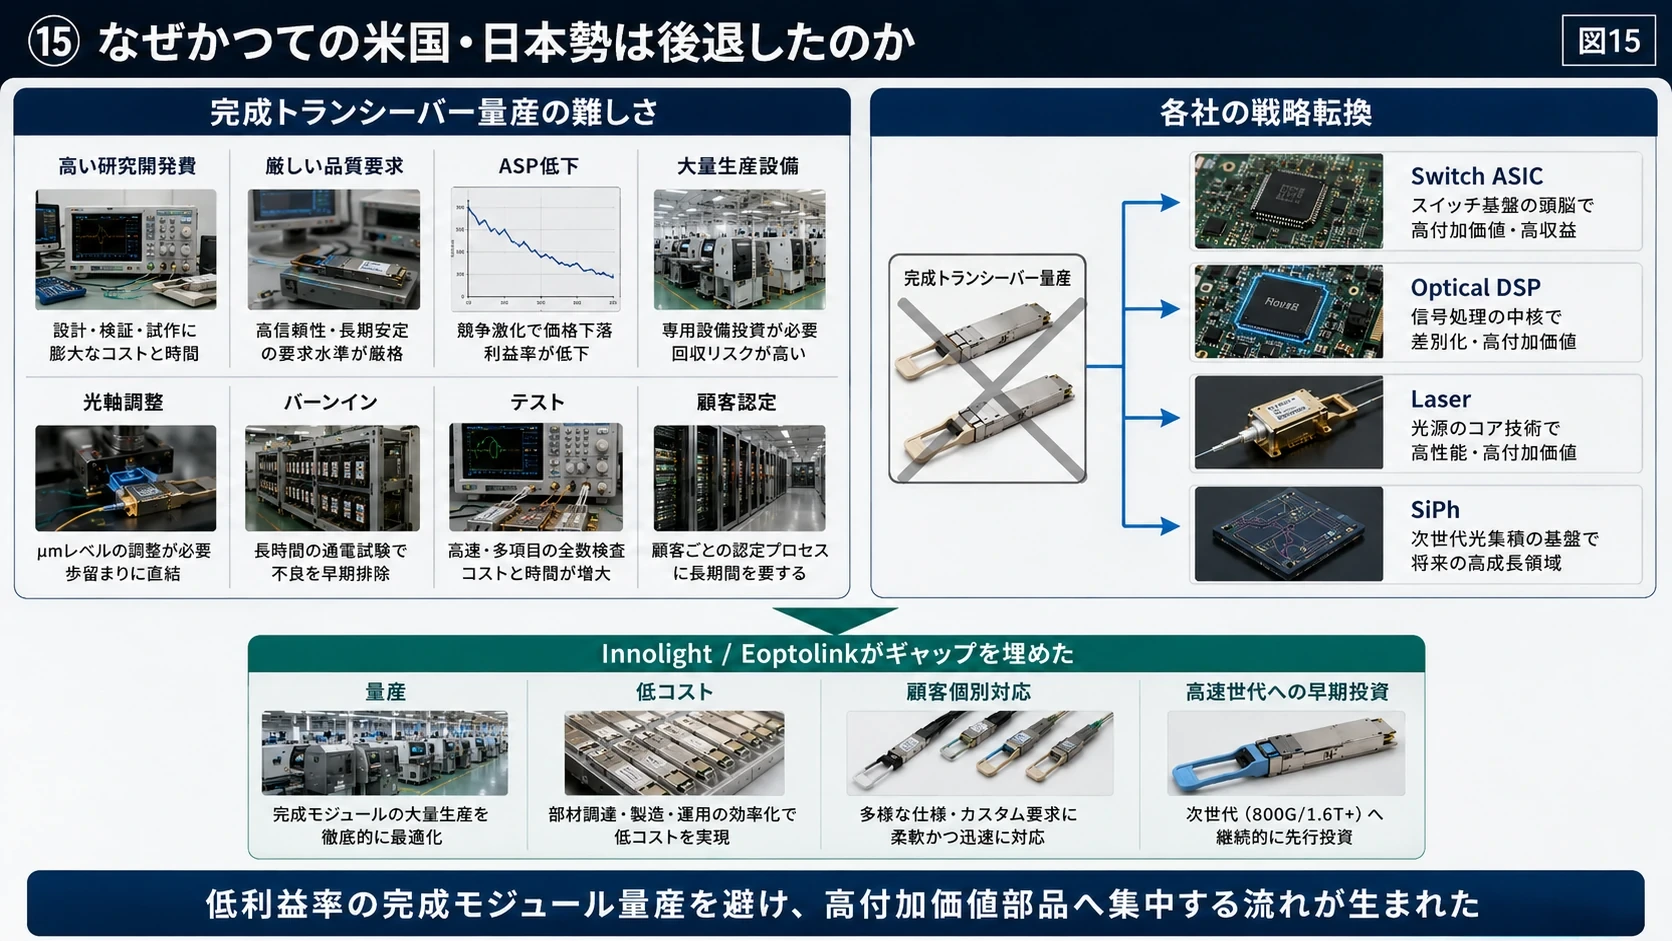
#光トランシーバー市場は長い間、
#高い研究開発費、
#厳しい品質要求、
#激しいASP低下、
#大量生産設備、
#光軸調整、
#バーンイン、
#テスト、
#顧客認定
#を必要とする割に、半導体ほど高い利益率を取りにくい市場だった。
#LightCountingによれば、光部品・モジュール企業の平均粗利率は30%以下で、他の通信産業の45~60%より低い状態が長く続いた。(LightCounting)
#このため米国企業では、
#光トランシーバーを完成品まで大量生産するより、DSP、Switch ASIC、レーザー、SiPhなど高付加価値部分に集中する
#という選択が合理的になった。
#その隙間へ、
#大量生産、低コスト、顧客個別対応、高速世代への早期投資
#を得意とするInnolightやEoptolinkが入った。
#そしてAIブームが始まった瞬間、この戦略が爆発的な利益へ変わったのである。
#図解|完成Moduleから高付加価値部品への移動
#
16 「Ciscoが圧倒的だった」という話は何なのか
#これは市場の定義を分ける必要がある。
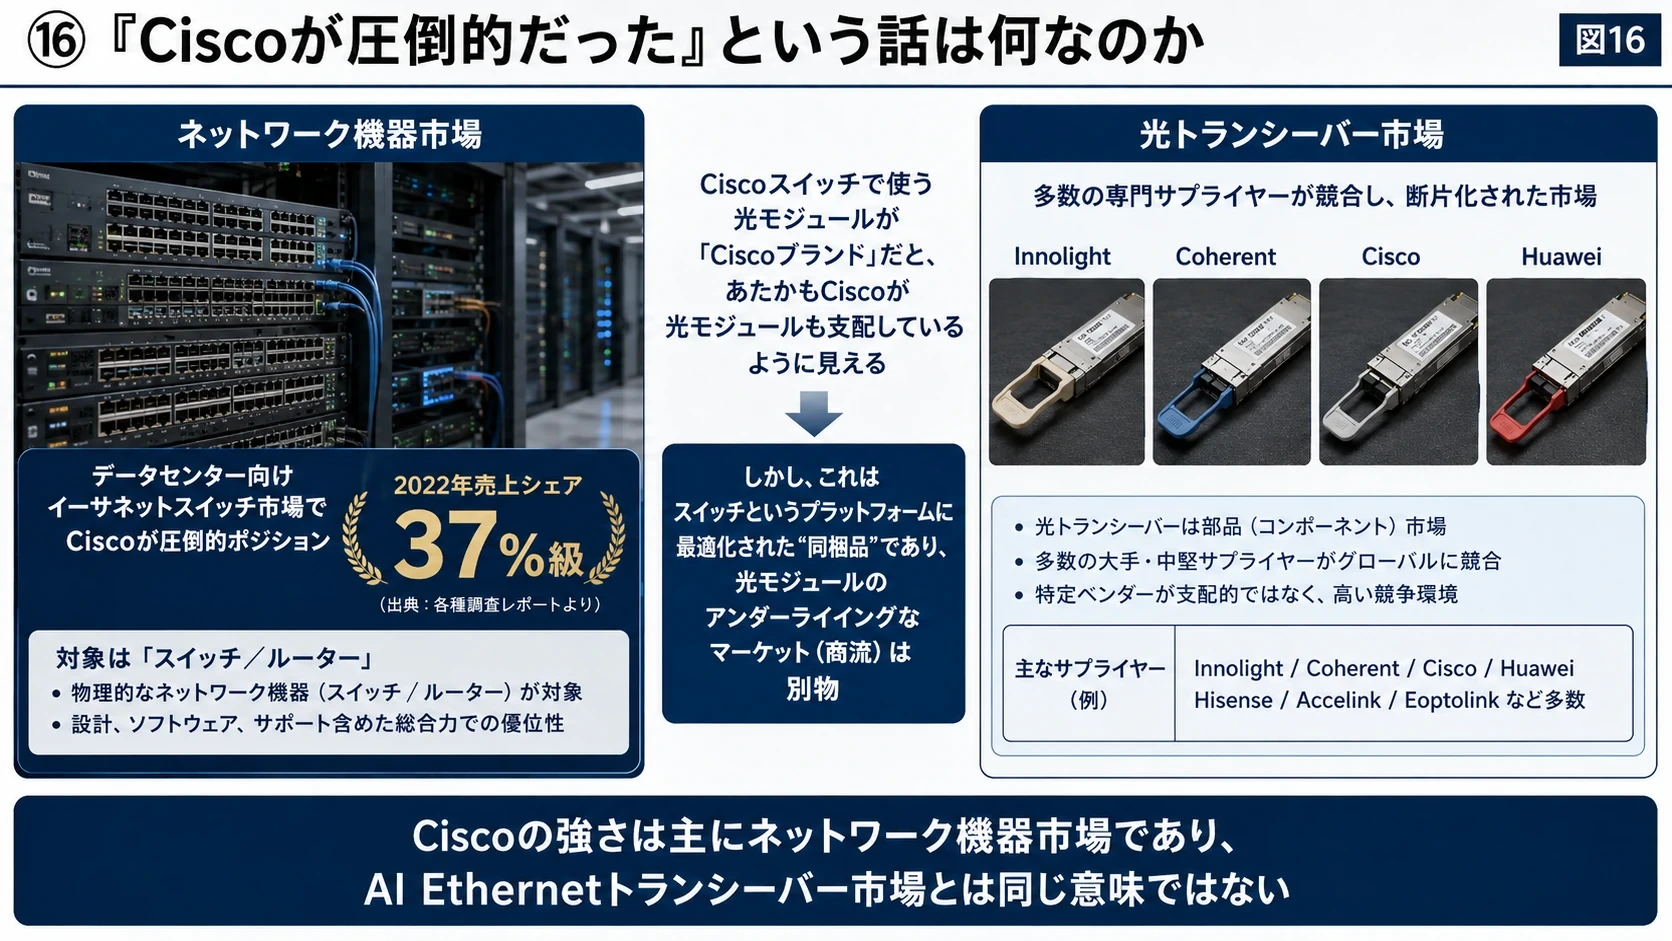
#Ciscoが長年圧倒的だったのは、
#Ethernet SwitchやRouterなどネットワーク機器市場
#である。
#例えばOmdiaでは2022年のData Center Ethernet Switch市場でCiscoは売上シェア37%で首位だった。(Omdia)
#CiscoのスイッチにCiscoブランドの光モジュールを挿す構成も広く使われたため、
#「Ciscoが光も支配している」
#ように見えやすかった。
#しかしmerchant optical transceiver製造市場を見れば別の歴史がある。
#2022年のLightCountingではInnolight、Coherent、Cisco、Huaweiの4社合計で世界の光トランシーバー市場の50%超であり、Cisco単独が圧倒的だったわけではない。(LightCounting)
#Cisco自身も2019年のLuxtera、2021年のAcacia取得によってSiPhやCoherent DSP/Opticsを強化した。Acaciaの買収額は約45億ドルだった。(Cisco Investor Relations)
#さらに2026年のLightCountingランキングでは、Cisco、Ciena、Huawei、Marvell、Nokiaなど主要DWDMモジュール企業は高速Ethernetトランシーバーランキングとは別に集計されるようになっている。(LightCounting)
#したがって、
#Ciscoのネットワーク機器シェア
#と
#InnolightのAI Ethernetトランシーバーシェア
#を同じ数字として比較してはいけない。
#図解|Ciscoと光Module市場の違い
#
17 現在の市場シェアは「80%」なのか
#ここにも注意が必要だ。
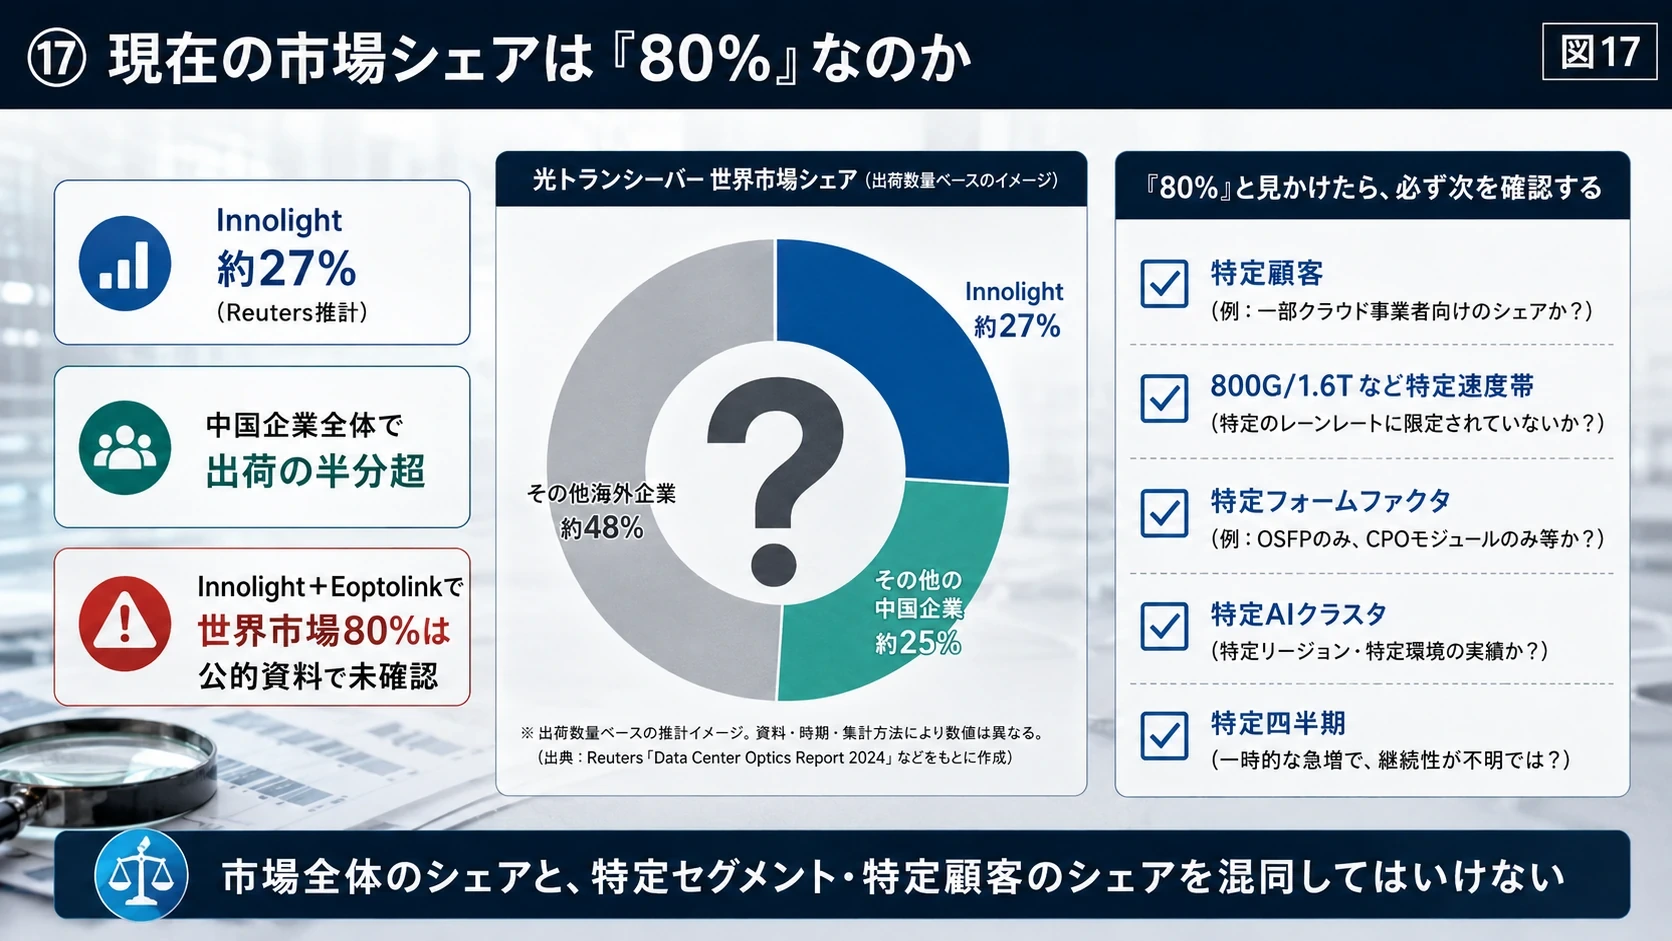
#Innolight+Eoptolinkで世界光トランシーバー市場の80%という数字を、公開されている信頼度の高い資料から確認することはできない。
#Reutersが報じた推計ではInnolightが約27%。また中国企業全体では世界出荷量の半分超とされる。(Reuters)
#LightCountingでは2025年、
##1 Innolight #2 Eoptolink #3付近 Coherent #4 Accelink
#という構図になっている。(LightCounting)
#したがって「80%」という数字を見る場合は、
#特定顧客、
#800G/1.6Tなど特定速度帯、
#特定フォームファクタ、
#特定AIクラスタ、
#特定四半期
#のシェアである可能性を確認する必要がある。
#市場全体の数字と混ぜない方がよい。
#図解|市場シェア数字の読み分け
#
18 AIデータセンターの通信をGPUから追ってみる
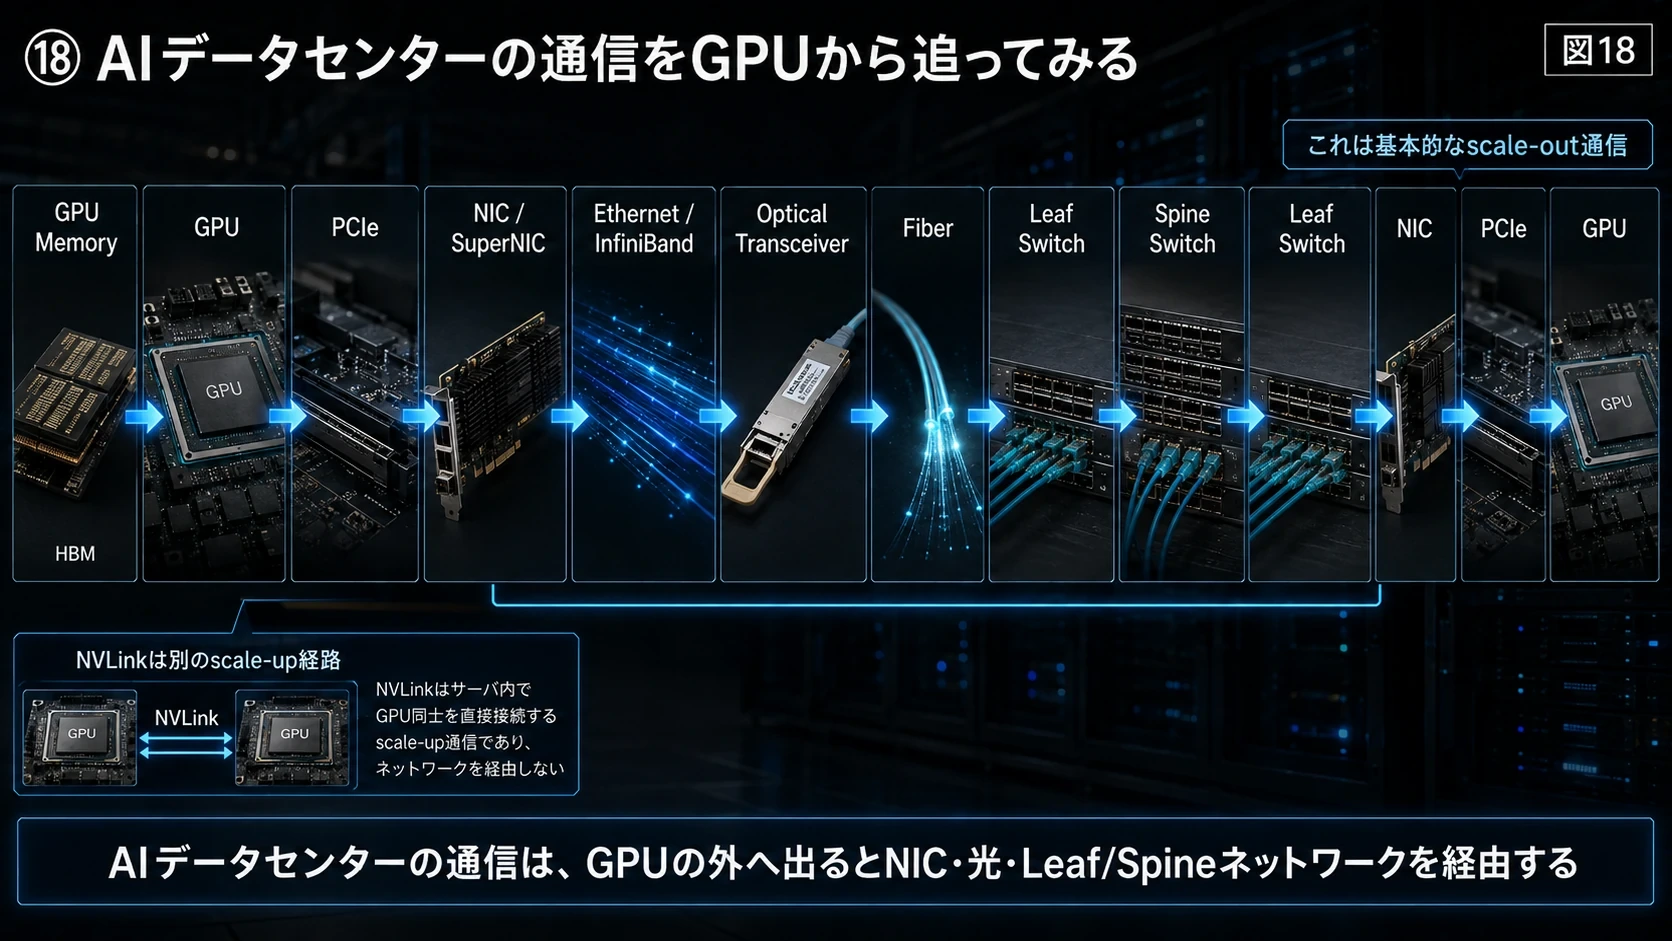
#ここから実際の通信経路へ入ろう。
#最も基本的なscale-out通信は、
#GPU Memory
│
▼
GPU
 │
 │ PCIe
 ▼
NIC / SuperNIC
│
│ Ethernet / InfiniBand
▼
Optical Transceiver
│
│ Fiber
▼
Leaf Switch
│
▼
Spine Switch
│
▼
Leaf Switch
│
▼
NIC
│
│ PCIe
▼
GPUと考えればよい。
#ただしNVLinkを使う場合は、これとは別に非常に高速なscale-up networkが存在する。
#図解|GPUからFiberへ進む通信経路
#
19 HBMからまずGPUへ
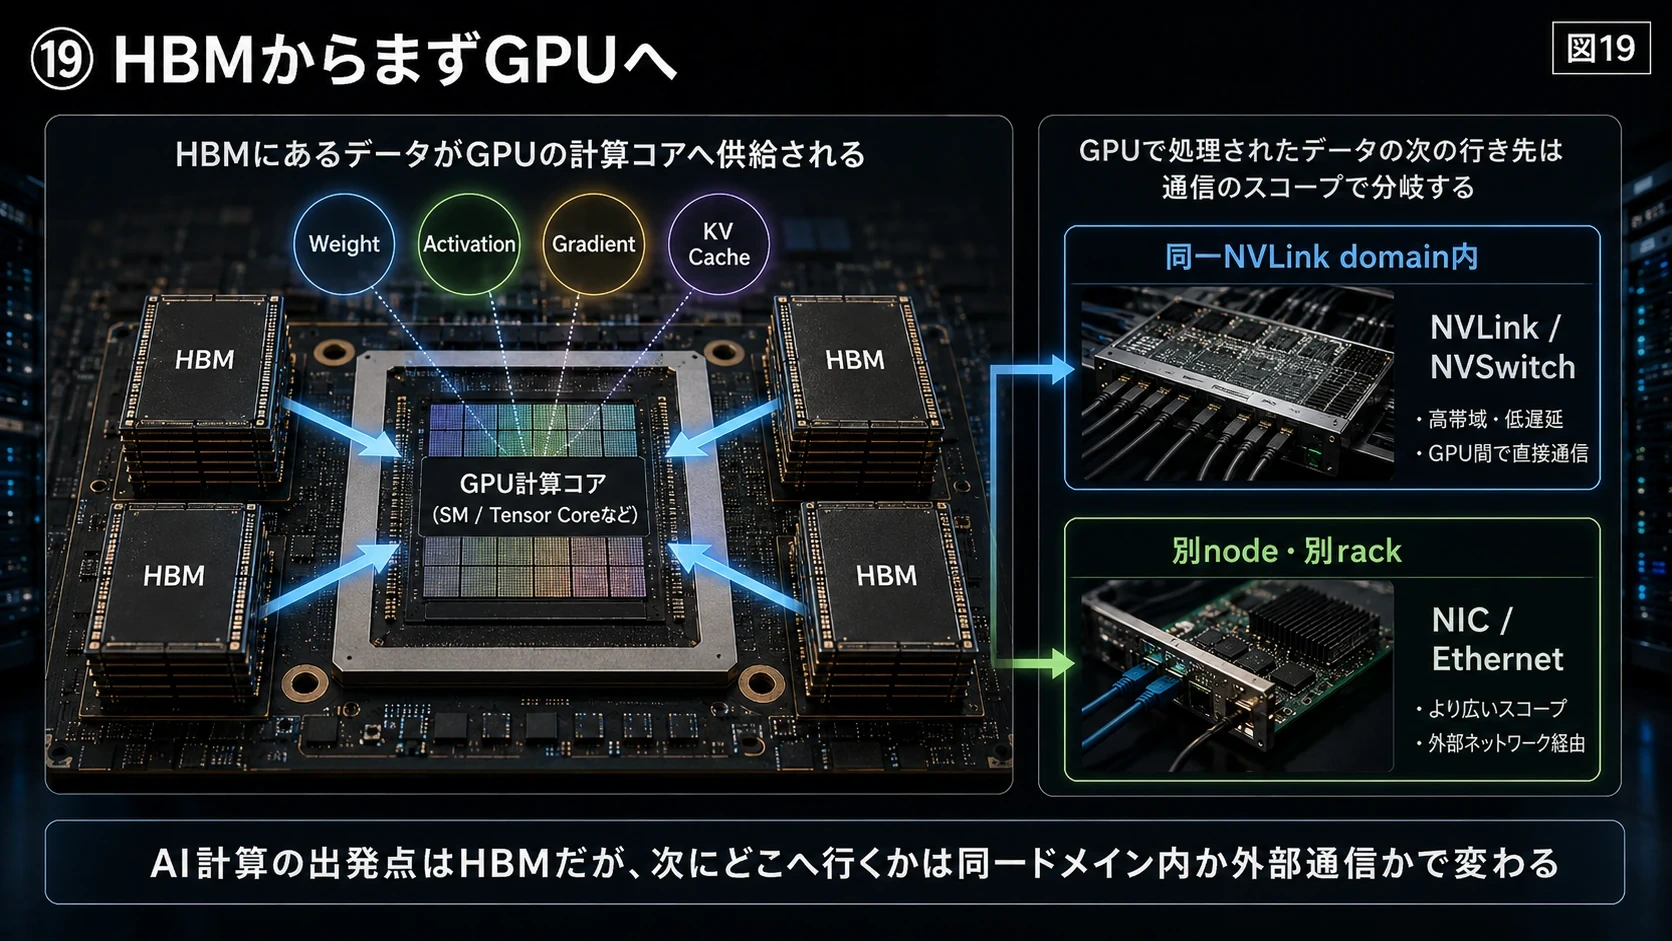
#GPUがAI計算するとき、重み、Activation、Gradient、KV Cacheなどのデータは主にHBMへ置かれる。
#HBM
│
▼
GPU Compute CoreGPU内部ではHBM帯域が計算性能を左右する。
#しかし別GPUへデータを送りたい場合、
#同一NVLink domain内なのか、
#別rack・別nodeなのか
#によって経路が変わる。
#図解|HBMからGPUへの供給
#
20 NVLinkはEthernetとは別物
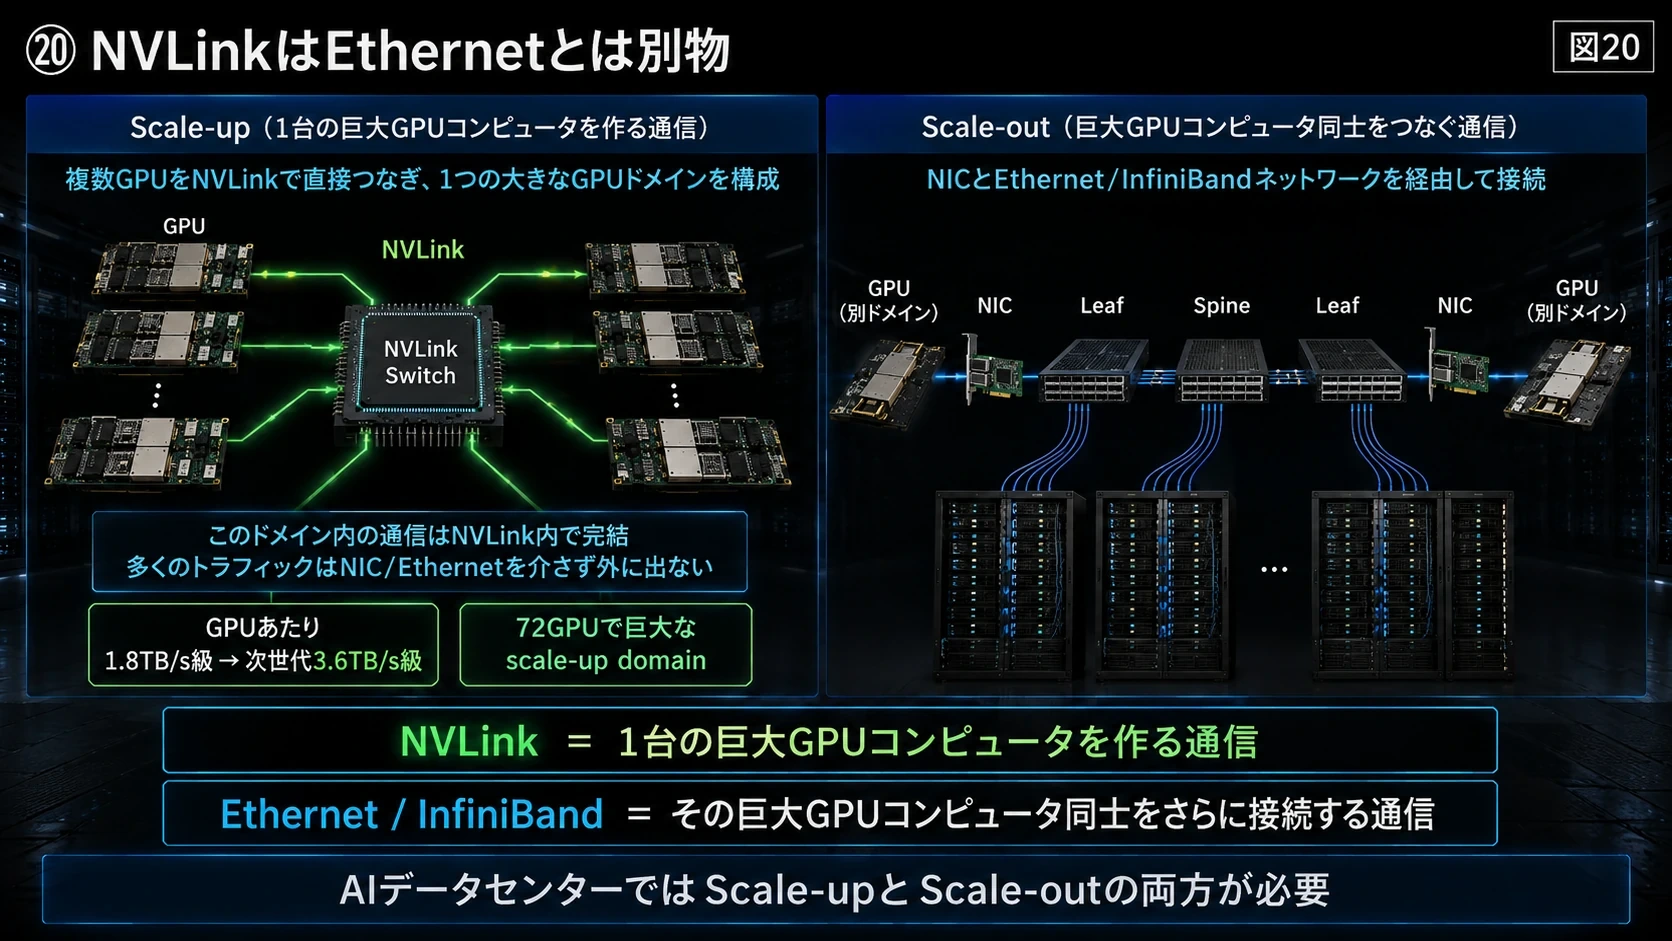
#NVIDIA GPU同士を非常に高速につなぐのがNVLinkである。
#現在のNVLinkはGPU間のscale-up interconnectであり、NVIDIAは最新世代でGPUあたり最大3.6TB/sの双方向bandwidthを掲げている。Blackwell世代のNVLink 5はGPUあたり1.8TB/s、Rubin世代NVLink 6では3.6TB/sへ拡張される。(nvidia.com)
#例えばGB200 NVL72なら、
#GPU ─┐
GPU ─┤
GPU ─┤
│
NVLink Switch
│
GPU ─┤
GPU ─┤
... │と72GPUを巨大な一つのscale-up domainとして接続する。
#Blackwell NVL72では72GPU間で総計130TB/sのNVLink fabricが構成される。(NVIDIA Developer)
#つまり同じNVLink domain内なら、
#GPU → NIC → Ethernet → Leaf
#へ出る必要がない場合がある。
#図解|NVLinkとEthernet
#
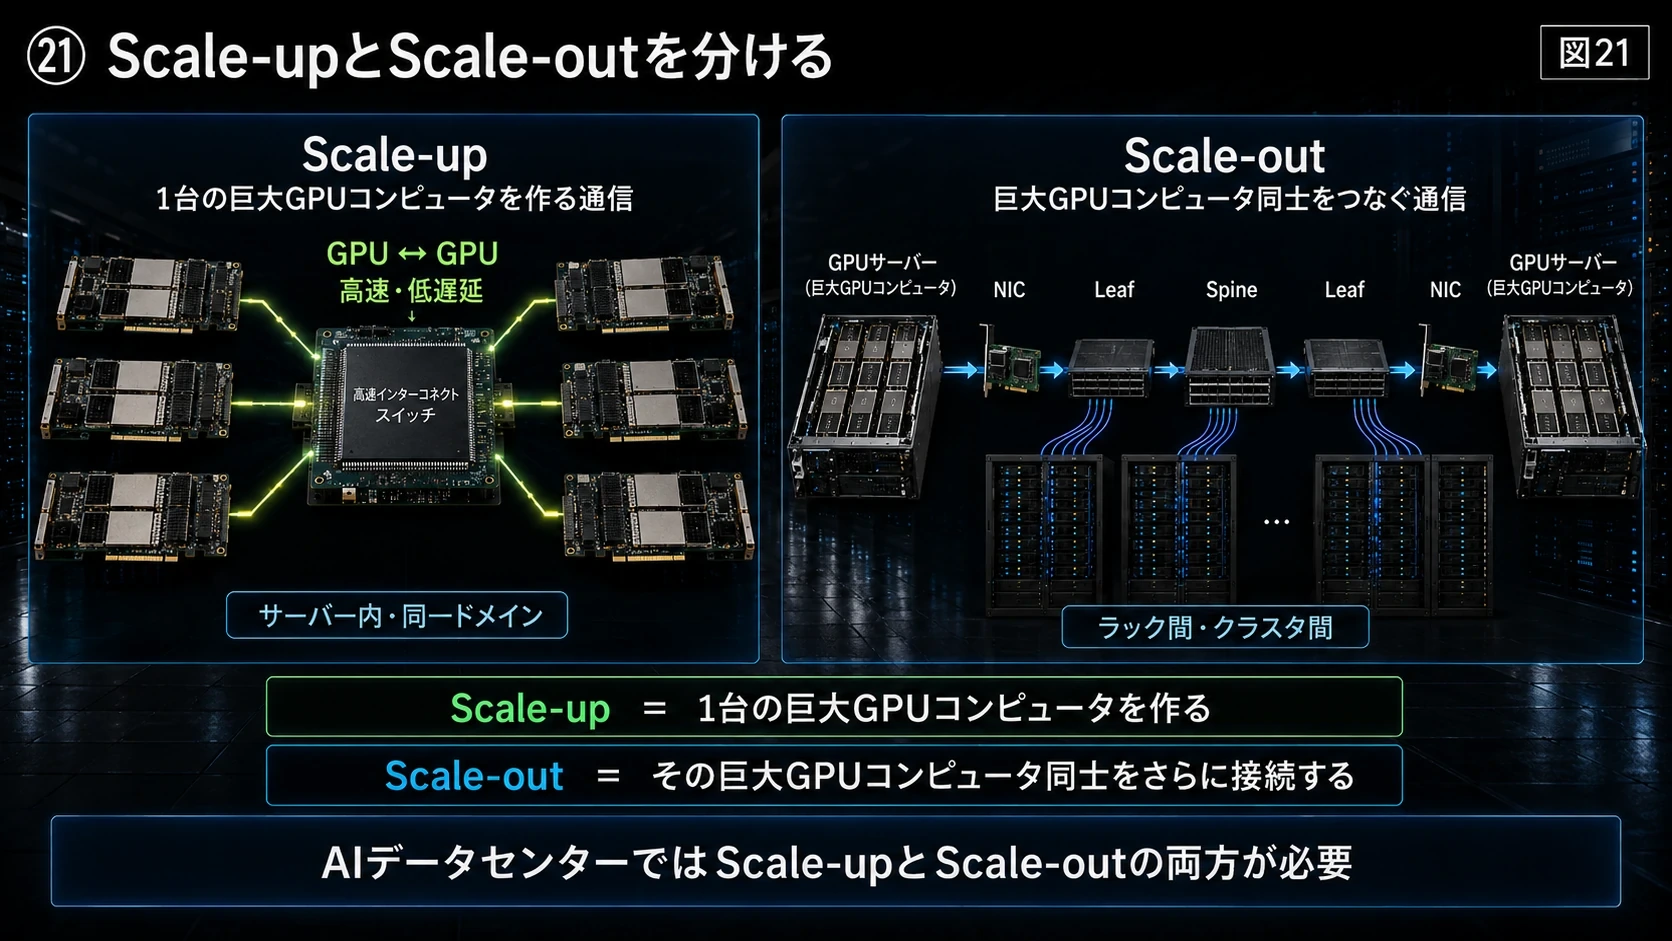
21 Scale-upとScale-outを分ける
#非常に単純化すると、
#Scale-up
#GPU ─ NVLink ─ GPU
│ │
└── NVSwitch ──┘Scale-out
#GPU
↓
NIC
↓
Leaf
↓
Spine
↓
Leaf
↓
NIC
↓
GPUとなる。
#NVLinkは「一つの巨大GPUコンピュータを作る」ための通信。
#Ethernet/InfiniBandは、
#その巨大GPUコンピュータ同士をさらに多数接続する
#通信である。
#AIデータセンターでは両方が必要になる。
#図解|Scale-upとScale-out
#
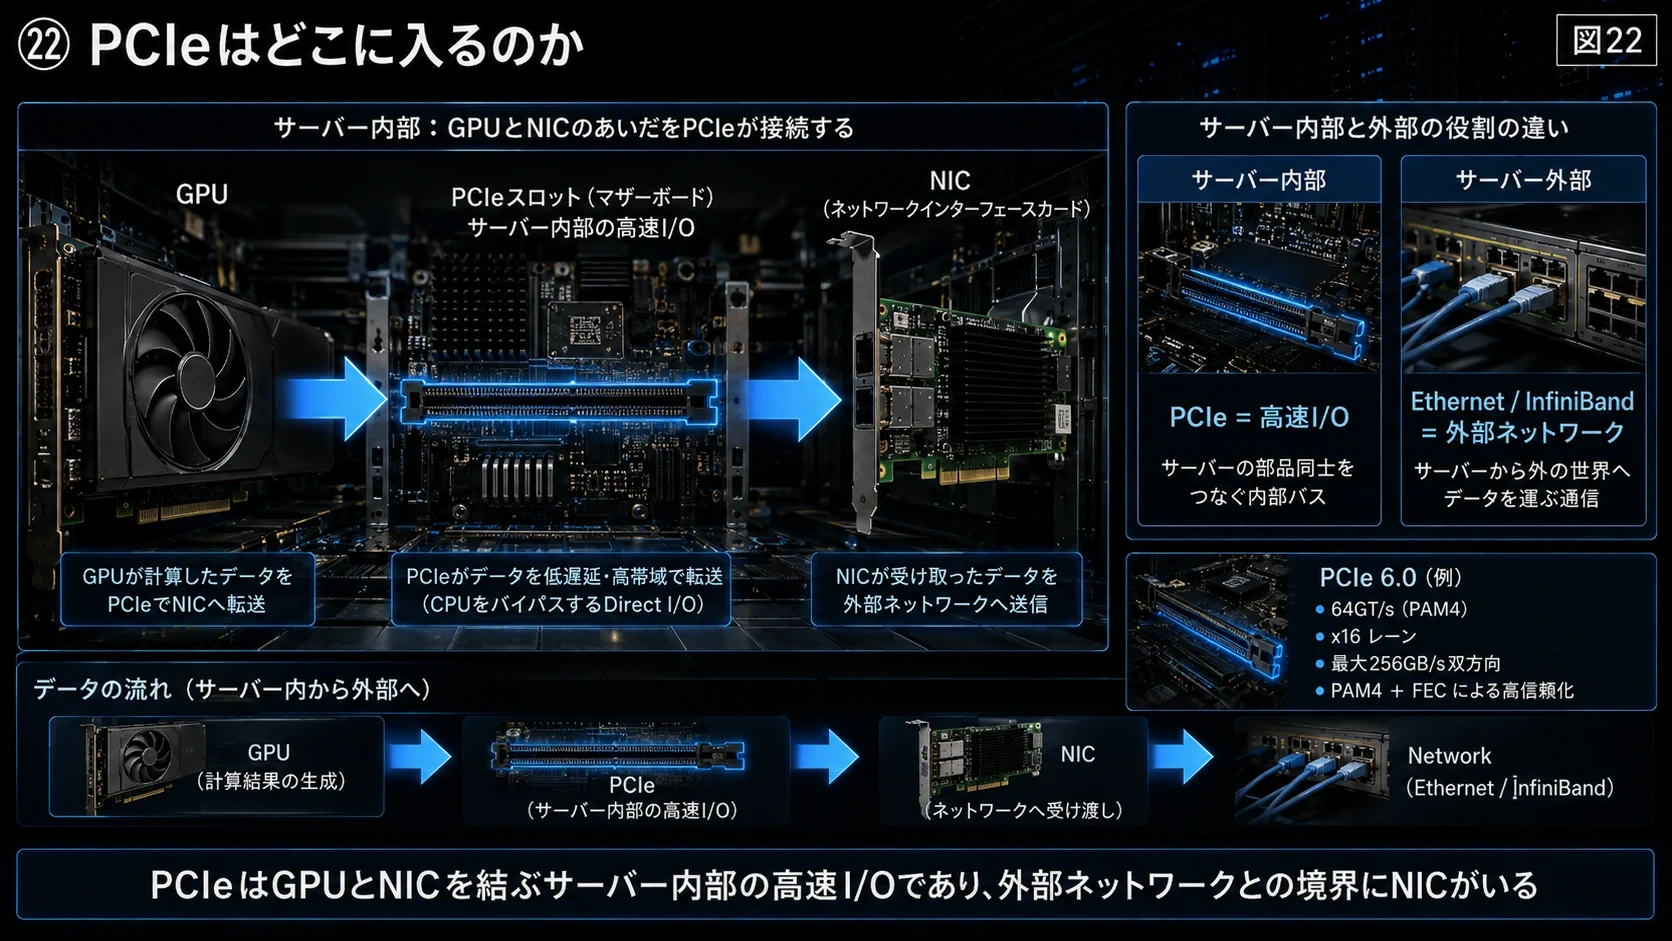
22 PCIeはどこに入るのか
#GPUとNICの間ではPCIeが重要になる。
#GPU
│
│ PCIe
▼
NICPCIe 6.0は64GT/s、x16構成で最大256GB/sの双方向bandwidthを持ち、PAM4とFECを採用している。(PCI-SIG)
#PCIeは、
#サーバー内部の高速I/O
#である。
#一方Ethernetは、
#サーバー外へ出るネットワーク
#である。
#この境界にNICがいる。
#図解|GPUとNICを結ぶPCIe
#
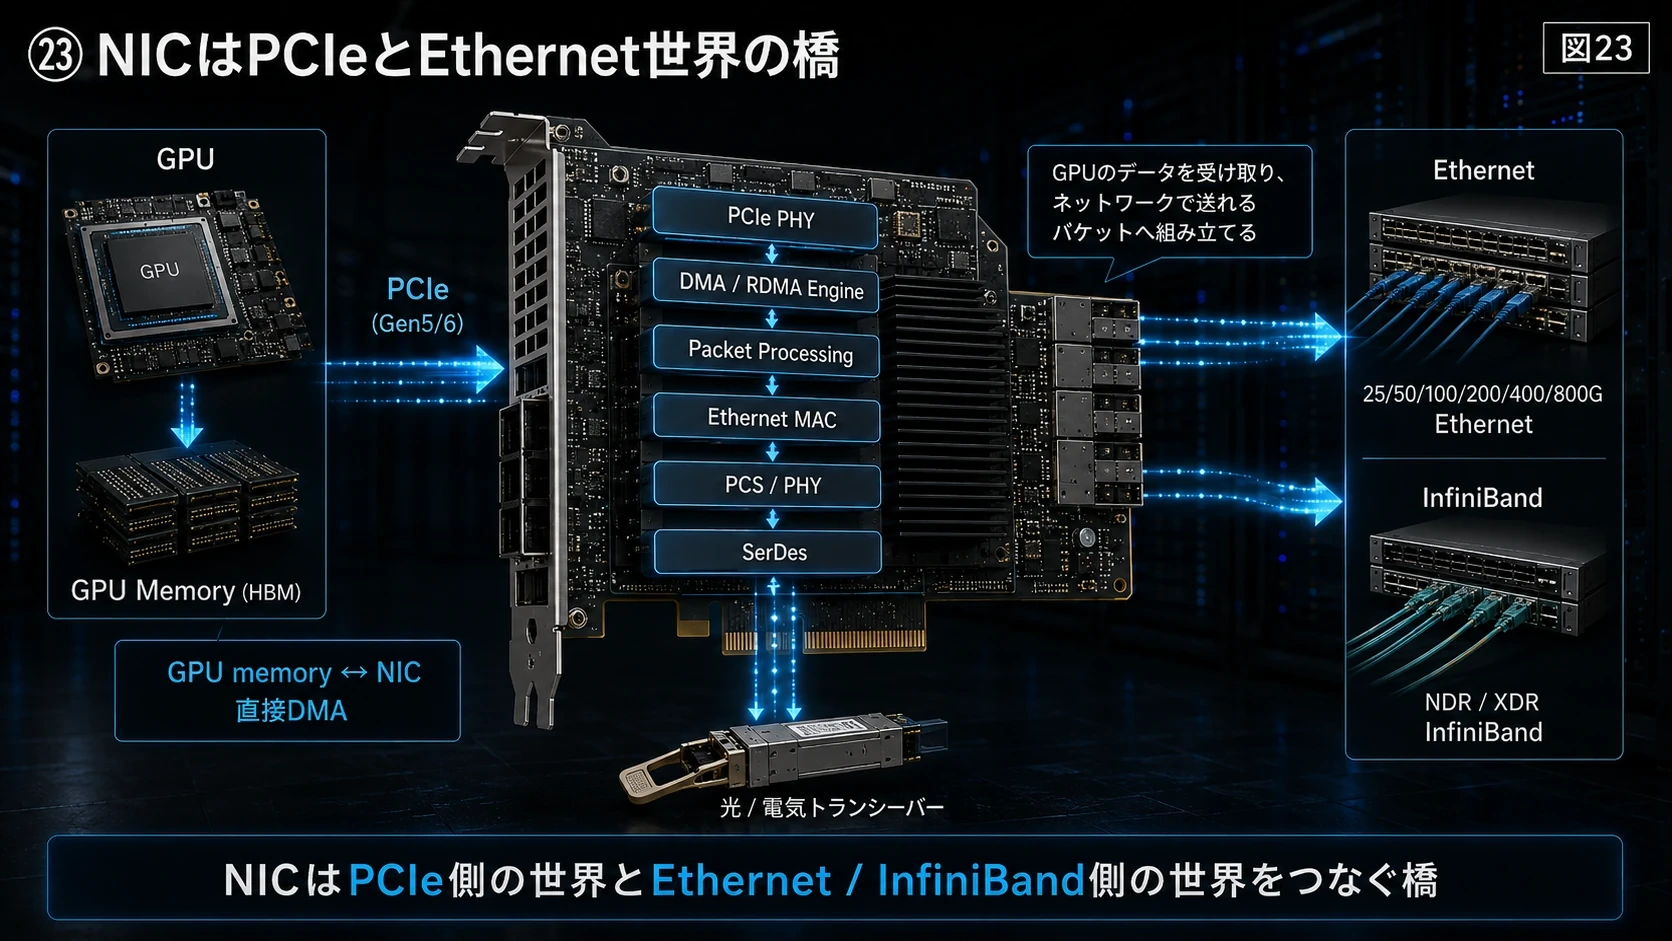
23 NICはPCIeとEthernet世界の橋
#NICはNetwork Interface Card。
#AI用ならConnectXやBlueField、Spectrum-X SuperNICなどが該当する。
#概念的には、
#NIC
#┌─────────────────────────┐
#PCIe PHY
│
DMA / RDMA Engine
│
Packet Processing
│
Ethernet MAC
│
PCS / PHY
│
SerDes└─────────────────────────┘
#という構造になる。
#GPUのデータをPCIe経由で受け取ったNICは、
#ネットワークで送れるEthernet/InfiniBand packetへ組み立て直す。
#GPUDirect RDMAを使えば、CPU RAMへ一度コピーすることなくGPU memoryとNICの間で直接DMAできる。NVIDIAもGPUDirect RDMAをGPUとNICなどPCIe peer devices間の直接通信技術として説明している。(NVIDIA Developer)
#図解|NICの内部階層
#
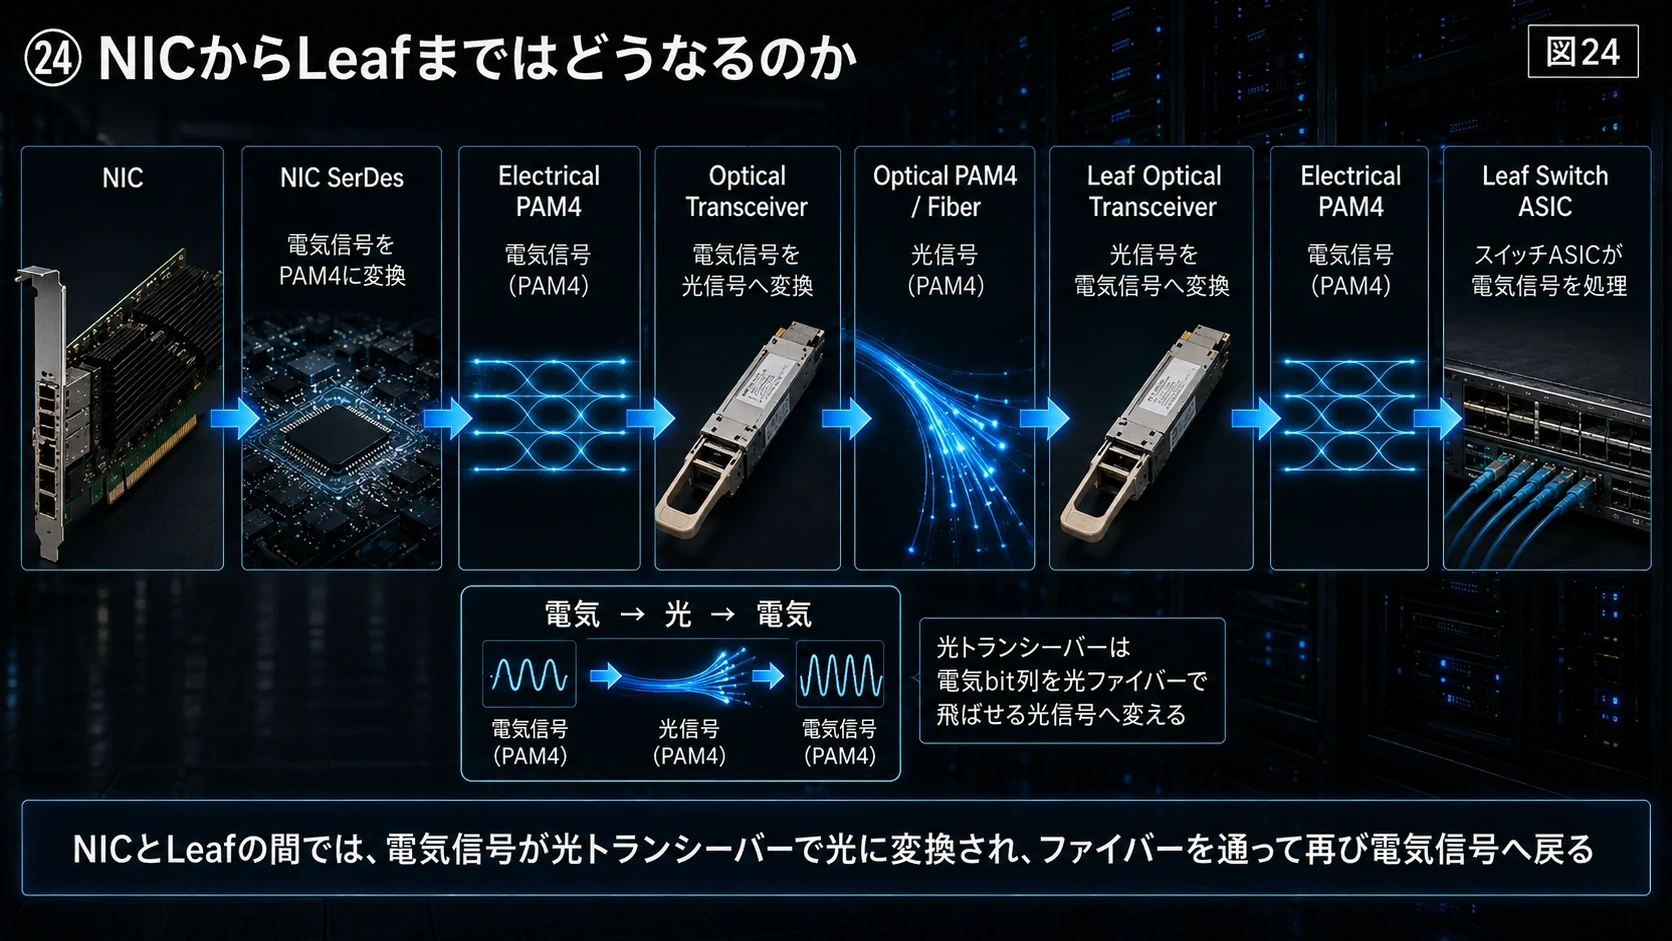
24 NICからLeafまではどうなるのか
#光接続なら、
#NIC
│
▼
NIC SerDes
│
│ Electrical PAM4
▼
Optical Transceiver
│
│ Optical PAM4
▼
Fiber
│
▼
Leaf Optical Transceiver
│
│ Electrical PAM4
▼
Leaf Switch ASICとなる。
#つまり光トランシーバーは、
#NICやSwitch ASICが作った電気bit列を光ファイバーで飛ばせる光信号にする橋
#なのである。
#図解|NICからLeafへの光変換
#
25 光DSPはなぜ必要なのか
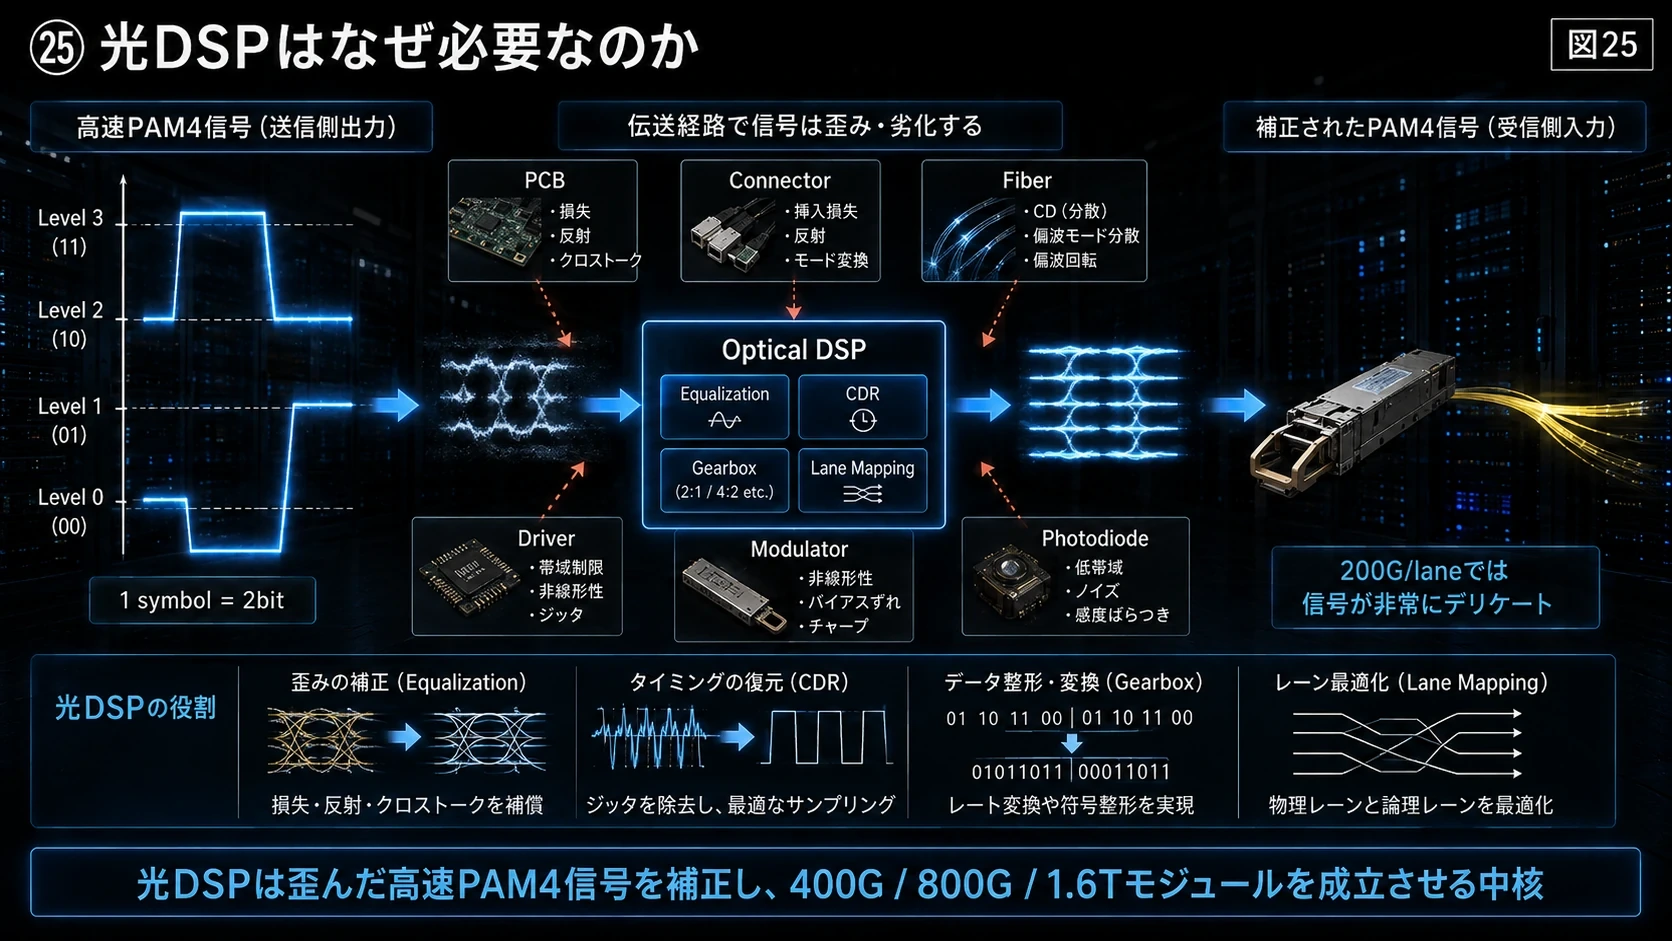
#200G/laneのPAM4ともなると、信号は非常にデリケートになる。
#理想的なPAM4は4段階の電圧レベルを持つ。
#Level 3 Level 2 Level 1 Level 0
#4状態なので一つのsymbolで2bitを表現できる。
#しかし実際の信号は、
#PCB、
#Connector、
#Driver、
#Modulator、
#Fiber、
#Photodiode
#などを通ることで歪む。
#そこでOptical DSPがEqualization、CDR、gearbox、lane mappingなどを行って信号品質を確保する。
#MarvellはPAM4 Optical DSPを400G、800G、1.6Tのpluggable moduleを成立させる中核として位置づけている。(Marvell Technology)
#図解|高速PAM4補正の中核
#
26 OSFPとは何なのか
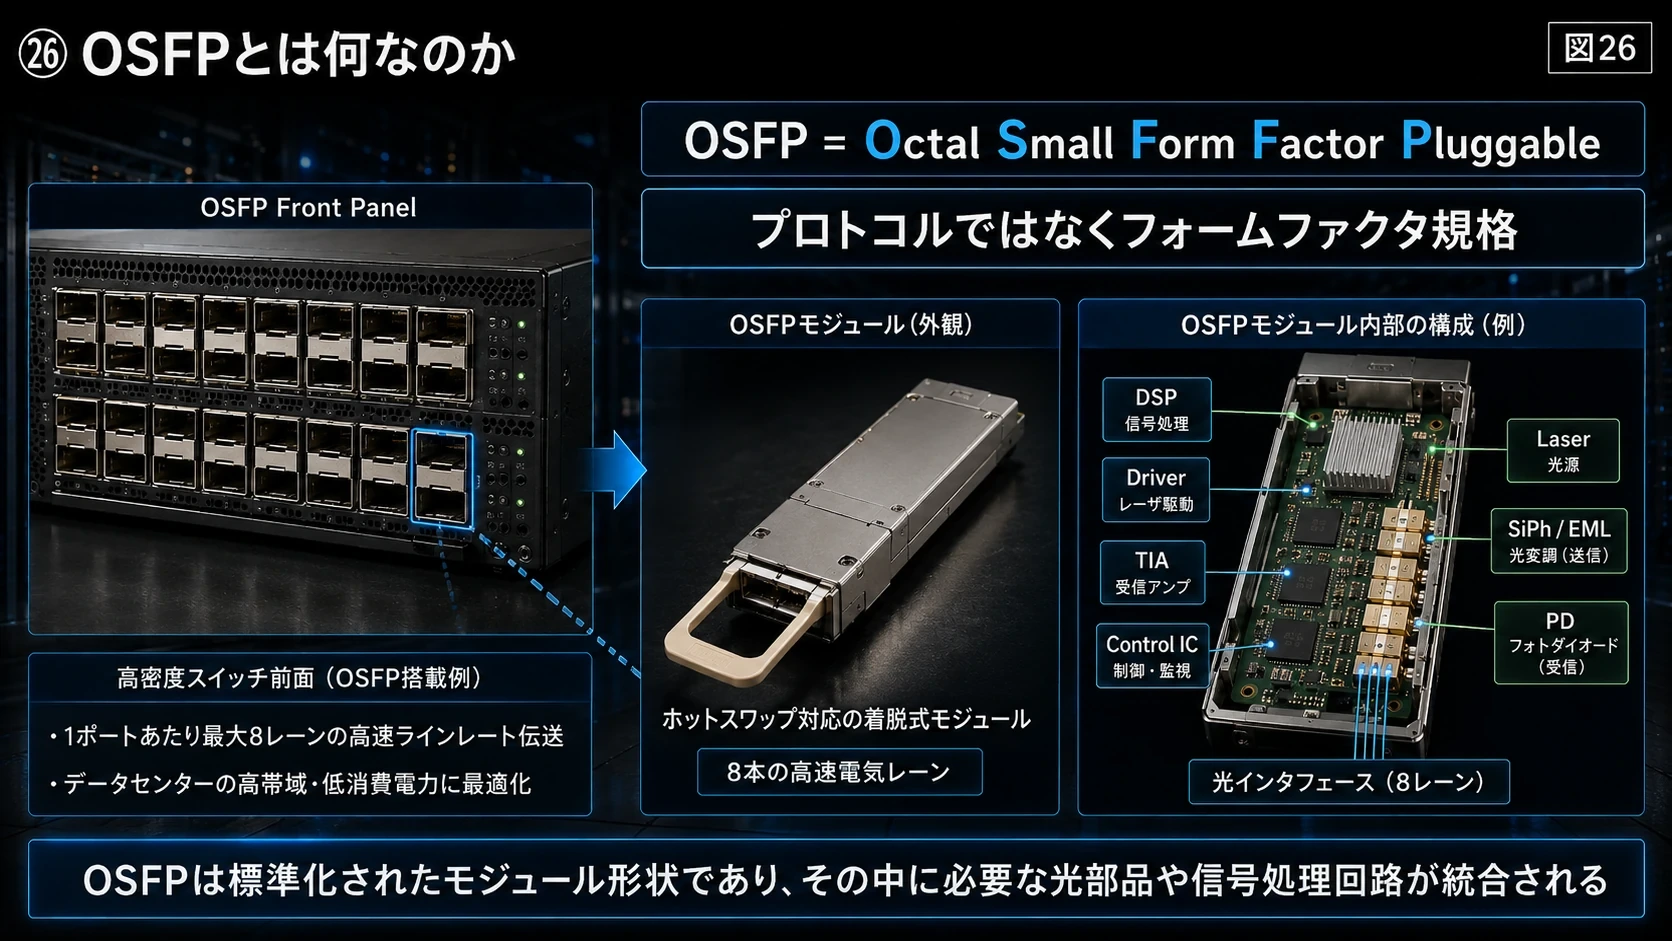
#OSFPはOptical Technologyではない。
#フォームファクタ規格
#である。
#正式には、
#Octal Small Form Factor Pluggable
#で、8本の高速電気レーンを持つ。
#OSFPは、
#Switch Front Panel
#[OSFP][OSFP][OSFP][OSFP] [OSFP][OSFP][OSFP][OSFP]
#のようにスイッチ前面へ差し込む。
#規格では電気コネクタ、機械寸法、電源、熱設計などが定義される。(OSFPmsa)
#OSFP内部には、
#DSP Laser SiPh / EML Driver TIA PD Control IC
#などが入る。
#したがって、
#Innolightが1.6T OSFPを売る
#というのは、
#「OSFPという標準的な形の中へ必要な部品を統合した1.6T完成トランシーバーを売る」
#という意味である。
#図解|OSFPの外形と内部
#
27 Leaf Switchは何をしているのか
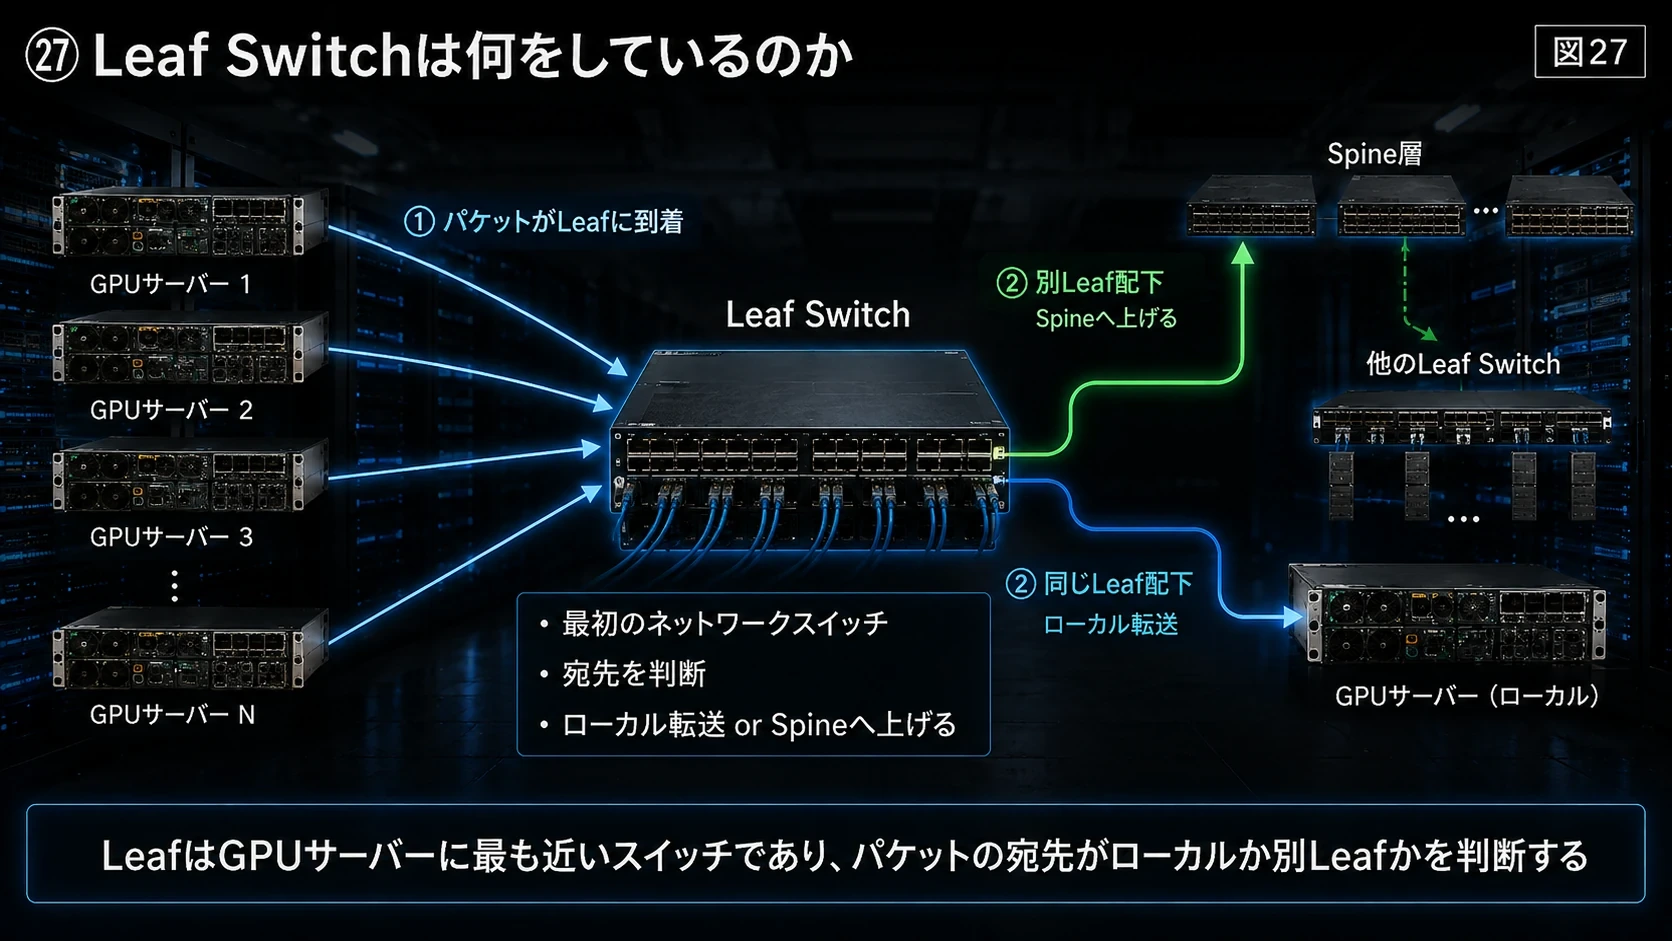
#LeafはGPUサーバーに近い最初のネットワークスイッチである。
#例えば、
#GPU Server ─┐
GPU Server ─┤
GPU Server ─┤
GPU Server ─┤
▼
Leafとなる。
#LeafのSwitch ASICは、
#「このパケットの宛先は同じLeaf配下か」
#「別のLeafか」
#を判断する。
#同じLeafなら直接送る。
#別LeafならSpineへ上げる。
#図解|Leaf Switchの役割
#
28 SpineはLeaf同士をつなぐ
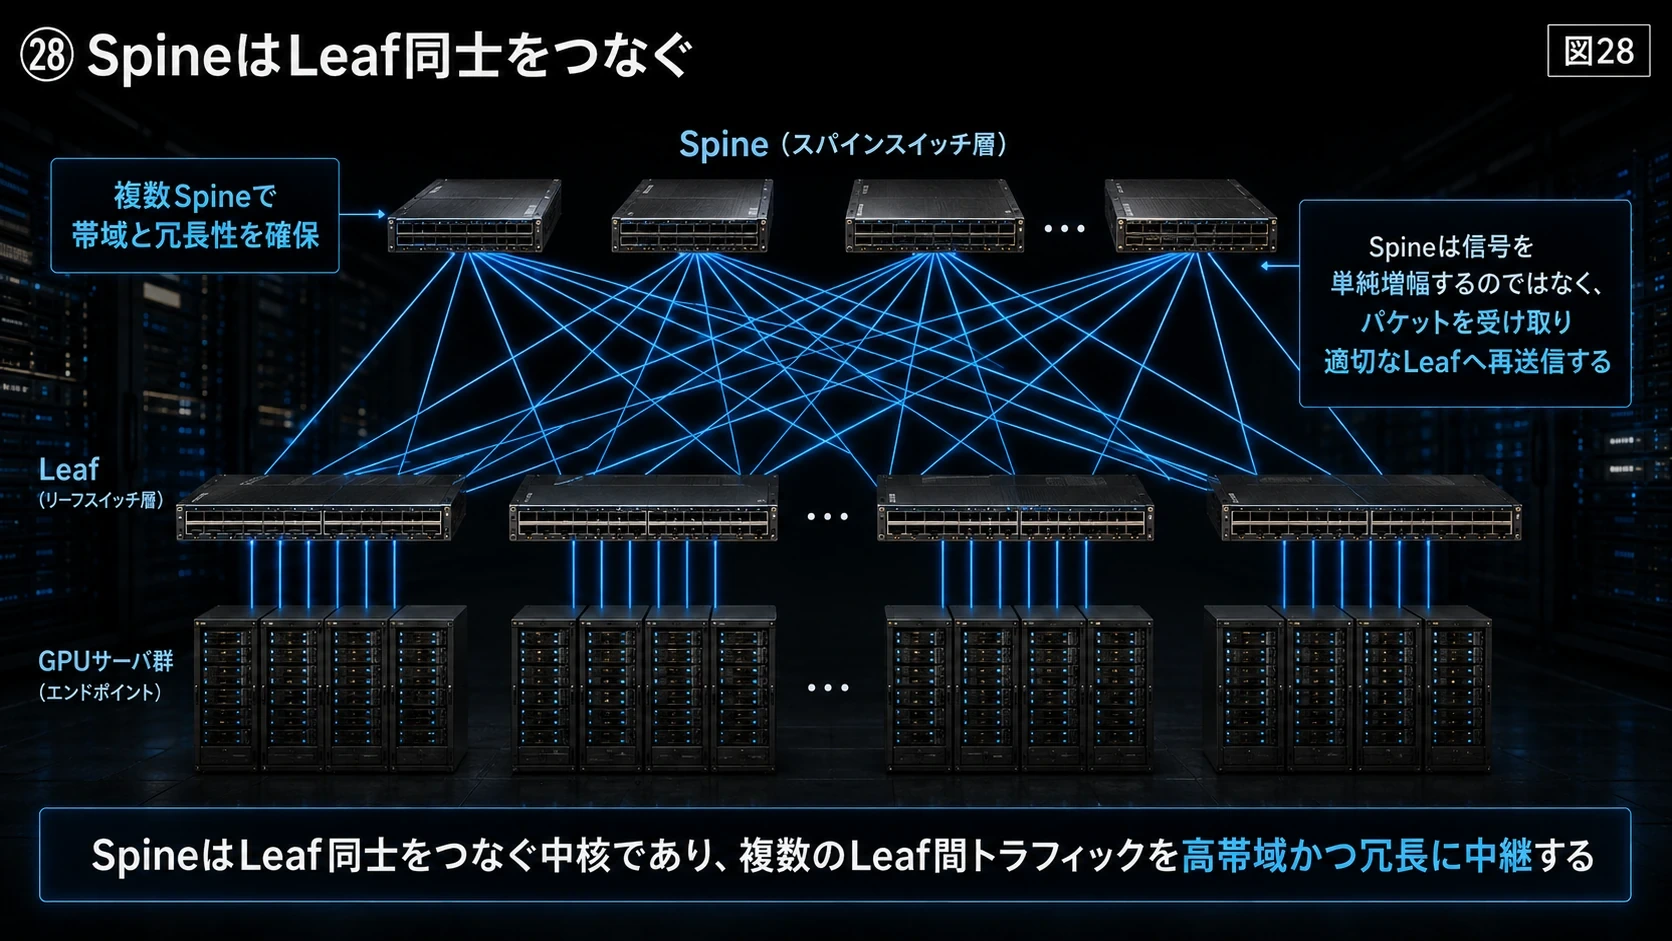
#例えば、
#Spine 1
/ │ \
/ │ \
Leaf 1 Leaf 2 Leaf 3
│││ │││ │││
GPU GPU GPUという構造になる。
#実際には帯域と冗長性を確保するため複数Spineを並列化する。
#NVIDIAのAI FactoryリファレンスでもGPU compute networkはRDMAベースのspine-leaf architectureとして構成される。(NVIDIA Docs)
#重要なのは、
#Spineが信号を単純に増幅しているわけではない
#ということだ。
#SpineもSwitch ASICでパケットを受け取り、宛先を判断し、適切なLeafへ再送信する。
#図解|Spine Switchの役割
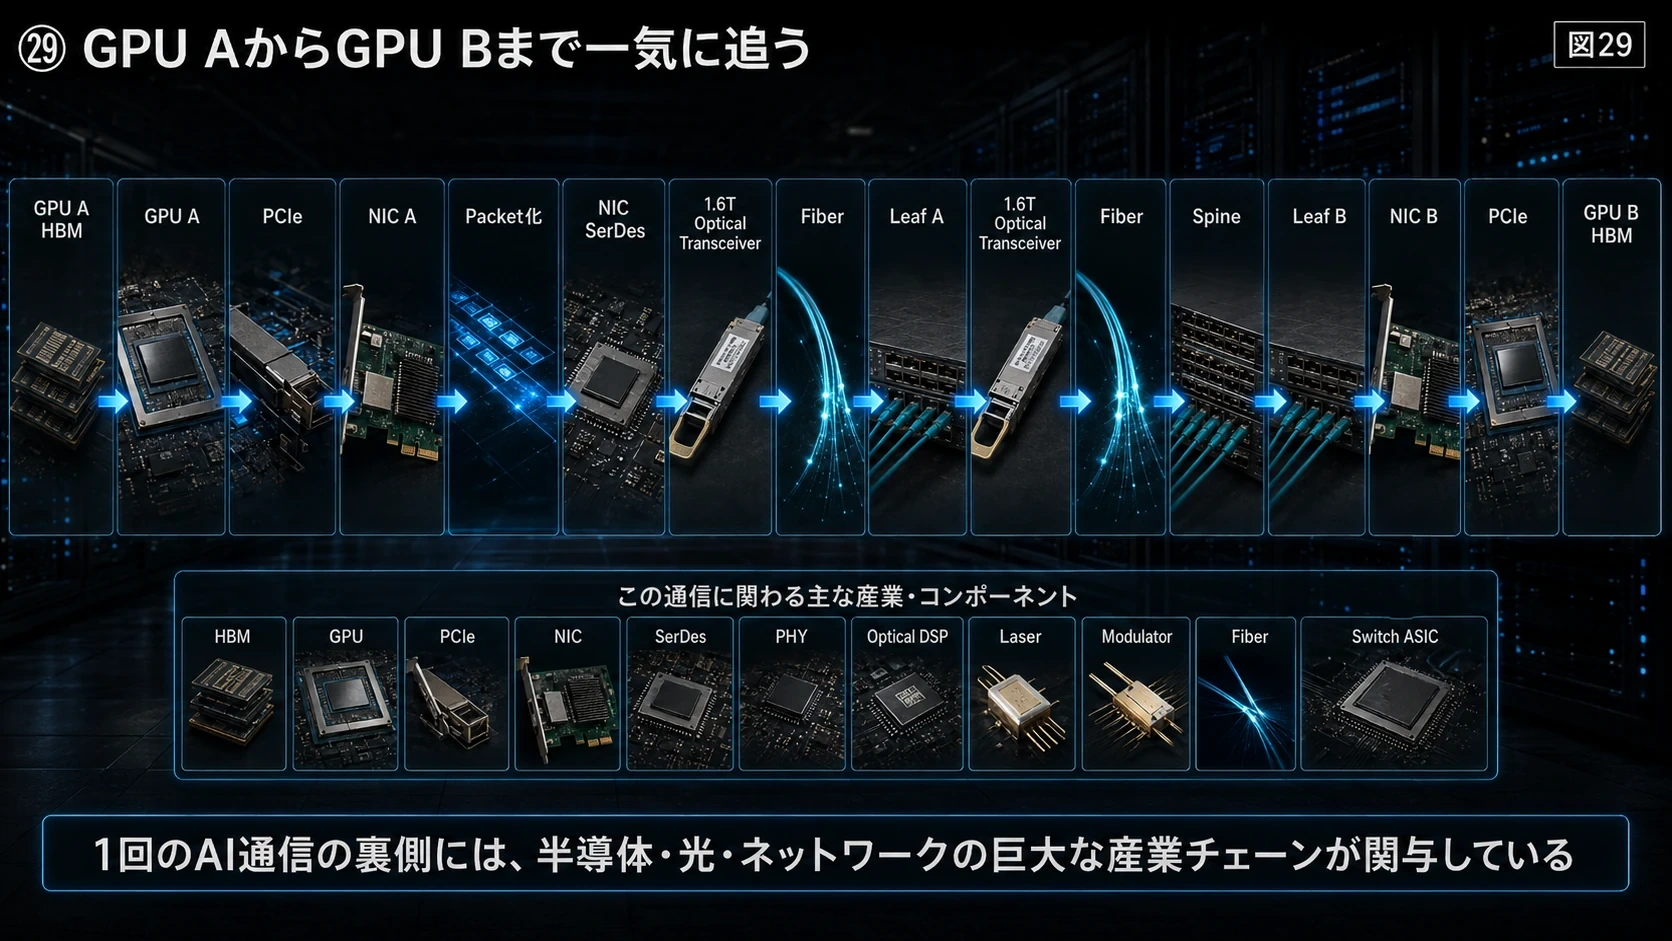
#
29 GPU AからGPU Bまで一気に追う
#別rackにあるGPUへGradientを送るとしよう。
#GPU A HBM
│
▼
GPU A
│
│ PCIe
▼
NIC A
│
│ Packet化
▼
NIC SerDes
│
▼
1.6T Optical Transceiver
│
│ 電気 → 光
▼
Fiber
│
▼
Leaf A
│
│ 宛先判断
▼
1.6T Optical Transceiver
│
▼
Fiber
│
▼
Spine
│
│ 宛先Leaf判断
▼
Fiber
│
▼
Leaf B
│
▼
NIC B
│
│ PCIe
▼
GPU B
│
▼
GPU B HBM一つのAI通信の裏側だけでも、
#GPU、
#HBM、
#PCIe、
#NIC、
#SerDes、
#PHY、
#Optical DSP、
#Laser、
#Modulator、
#Fiber、
#Switch ASIC
#という巨大な産業が関与している。
#図解|AI通信の全経路
#
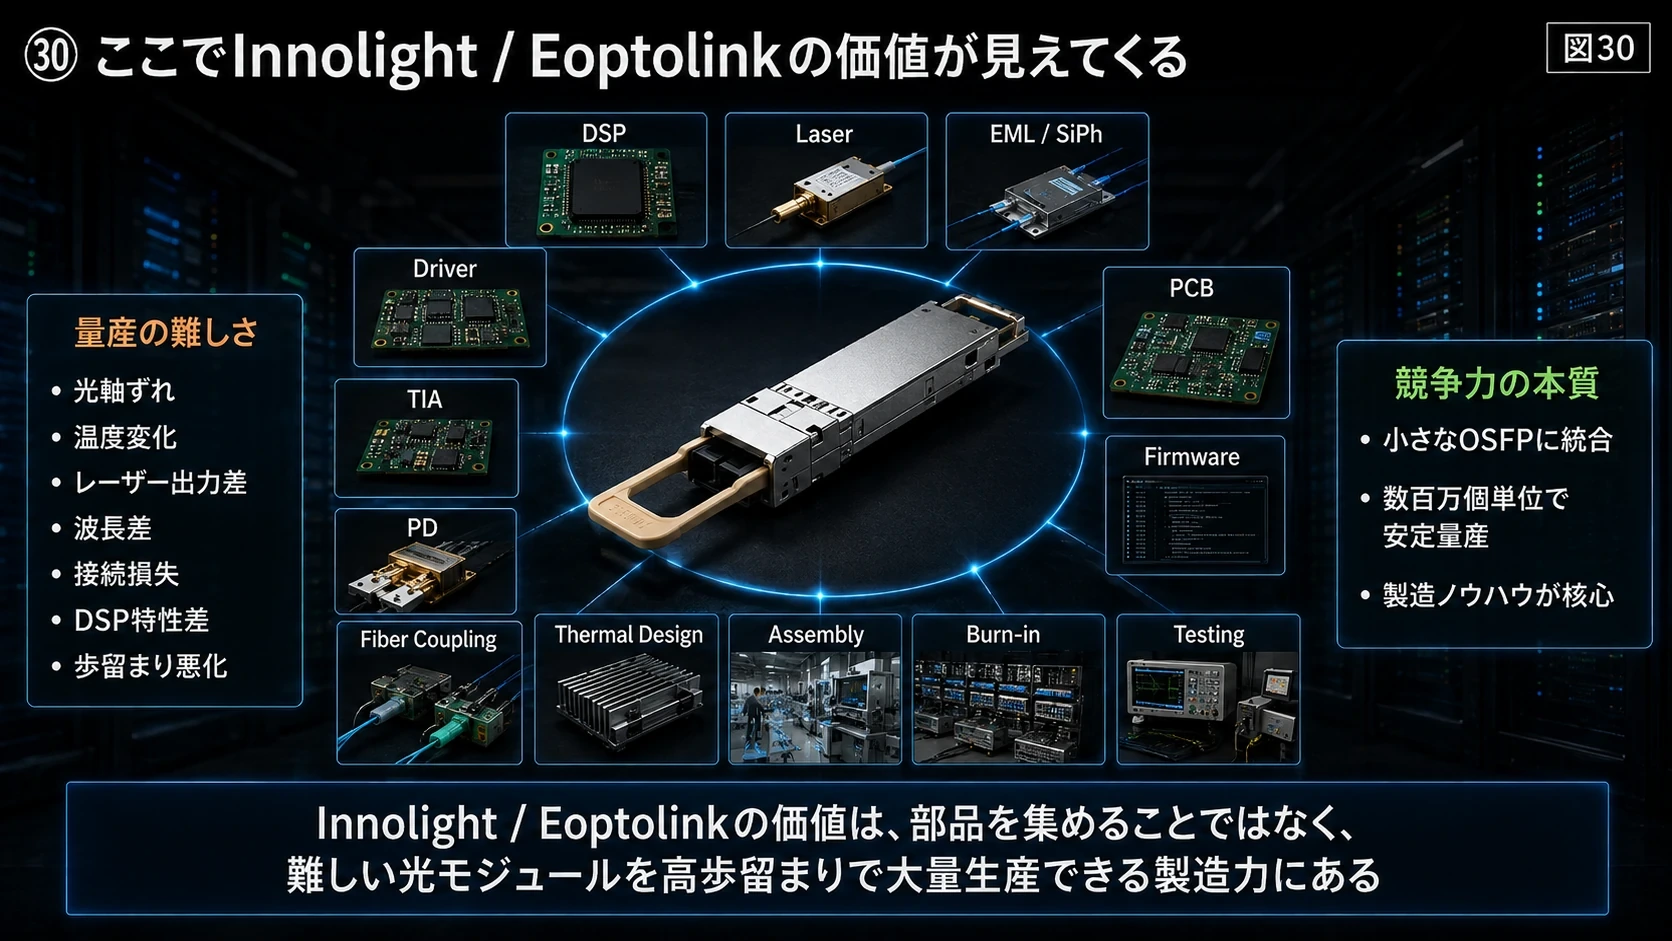
30 ここでInnolight/Eoptolinkの価値が見えてくる
#InnolightやEoptolinkはSwitch ASICを作っているわけではない。
#しかし、
#DSP + Laser + EML / SiPh + Driver + TIA + PD + PCB + Firmware + Fiber Coupling + Thermal Design + Assembly + Burn-in + Testing
#を、
#小さなOSFP一個として数百万個単位で安定して作る
#能力を持つ。
#これが非常に難しい。
#光モジュールではわずかな光軸ずれ、温度変化、レーザー出力差、波長差、接続損失、DSP特性差でも歩留まりが悪化する。
#したがって、
#「レーザーやDSPを買ってくれば誰でもInnolightになれる」
#わけではない。
#大量生産で歩留まりを出す製造ノウハウそのものが競争力になっている。
#図解|高歩留まり量産の価値
#
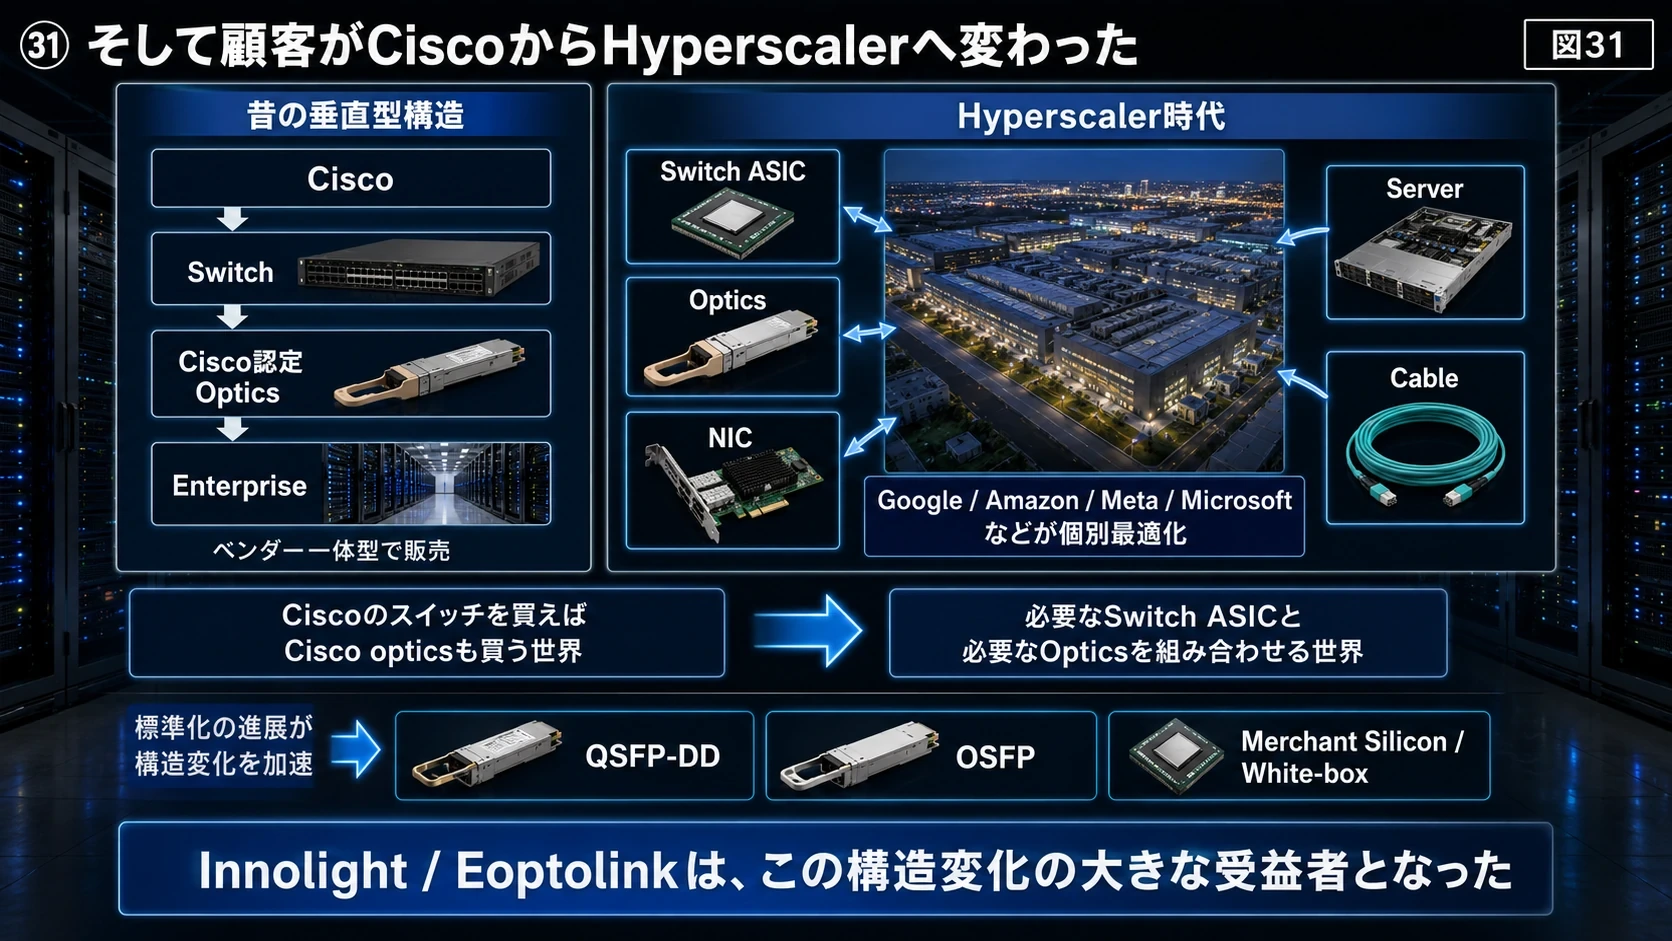
31 そして顧客がCiscoからHyperscalerへ変わった
#昔のネットワーク産業では、
#Cisco
↓
Switch
↓
Cisco認定Optics
↓
Enterpriseという垂直型の販売構造が強かった。
#しかしHyperscaler時代になると、
#Google、
#Amazon、
#Meta、
#Microsoft
#のような会社が巨大化し、
#Switch ASIC Optics NIC Server Cable
#をそれぞれ直接最適化するようになった。
#さらに標準化されたQSFP-DDやOSFP、merchant silicon、white-box switchが普及した。
#ここで、
#Ciscoのスイッチを買わなければCisco opticsも買えない
#という世界から、
#必要なSwitch ASICと必要なOpticsを組み合わせる
#世界へ変わった。
#Innolight/Eoptolinkはこの構造変化の最大の受益者の一つだったと考えると分かりやすい。
#図解|Hyperscaler時代の調達構造
#
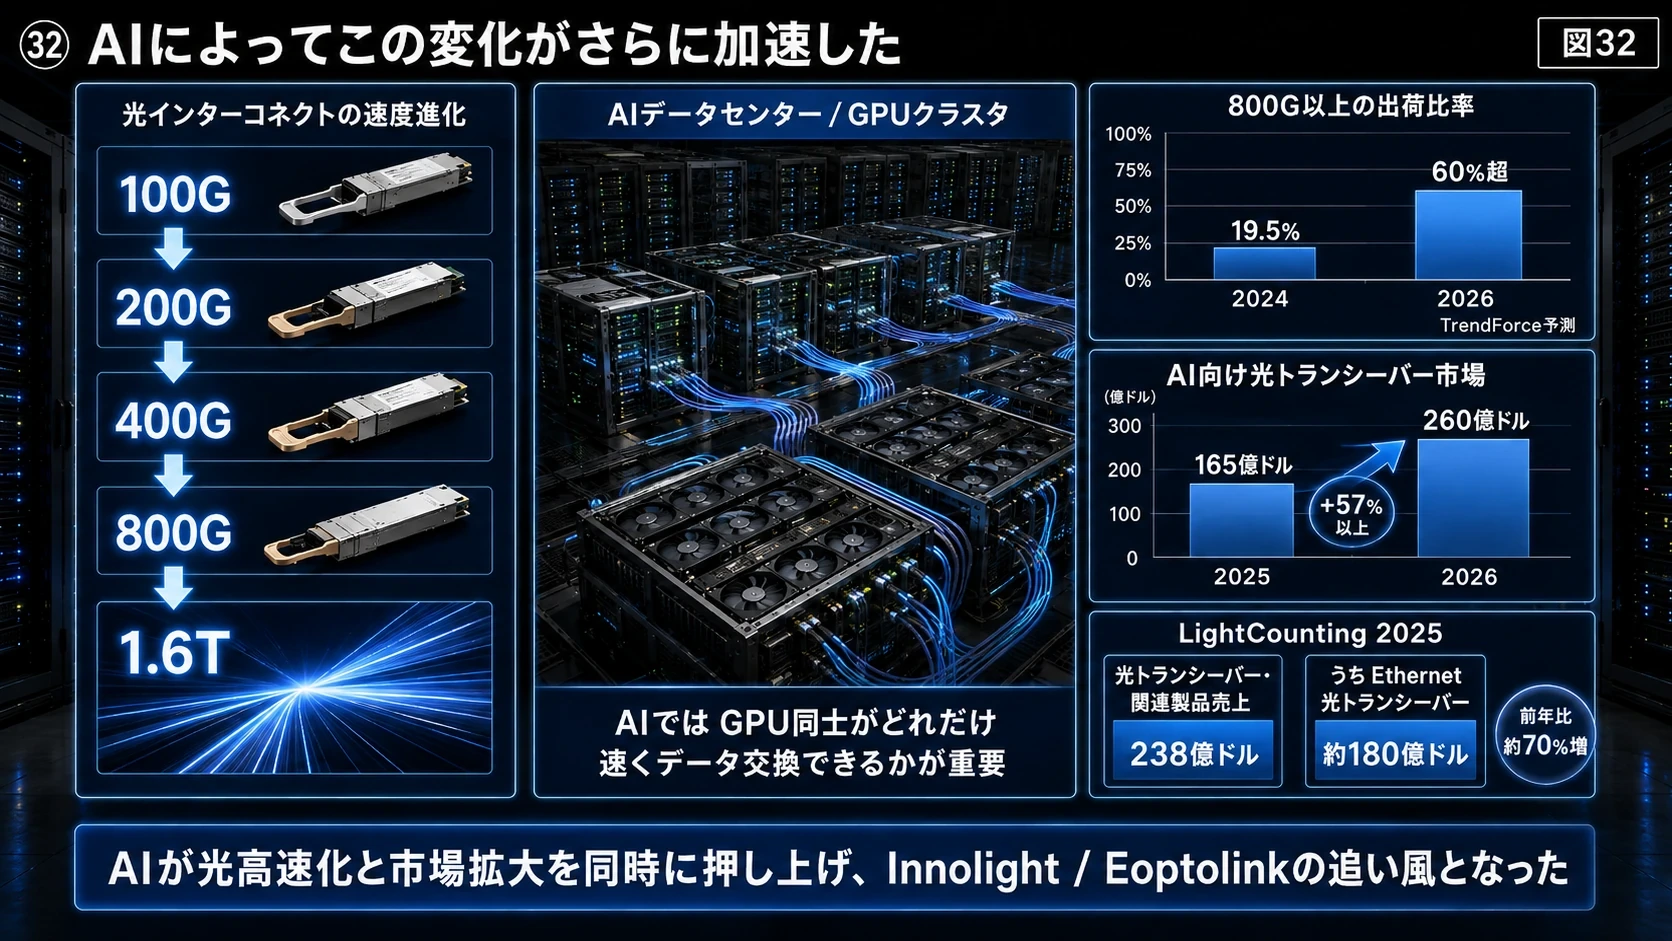
32 AIによってこの変化がさらに加速した
#AIではGPU一台の計算能力そのものより、
#GPU同士がどれだけ速くデータを交換できるか
#が重要になる。
#そのため、
#100G
↓
200G
↓
400G
↓
800G
↓
1.6Tという光高速化が急速に進んだ。
#TrendForceは800G以上の光トランシーバーの世界出荷比率が2024年の19.5%から2026年には60%超へ上昇すると予測している。(TrendForce)
#同社はAI向け光トランシーバー市場を2025年165億ドルから2026年260億ドルへ、57%以上成長すると予測している。(TrendForce)
#LightCountingでも2025年の光トランシーバー・関連製品売上は238億ドル、うちEthernet光トランシーバーが約180億ドルと推計され、前年比70%近い増加だった。(LightCounting)
#ここへInnolightとEoptolinkが最も強く張っていた。
#図解|100Gから1.6Tへの加速
#
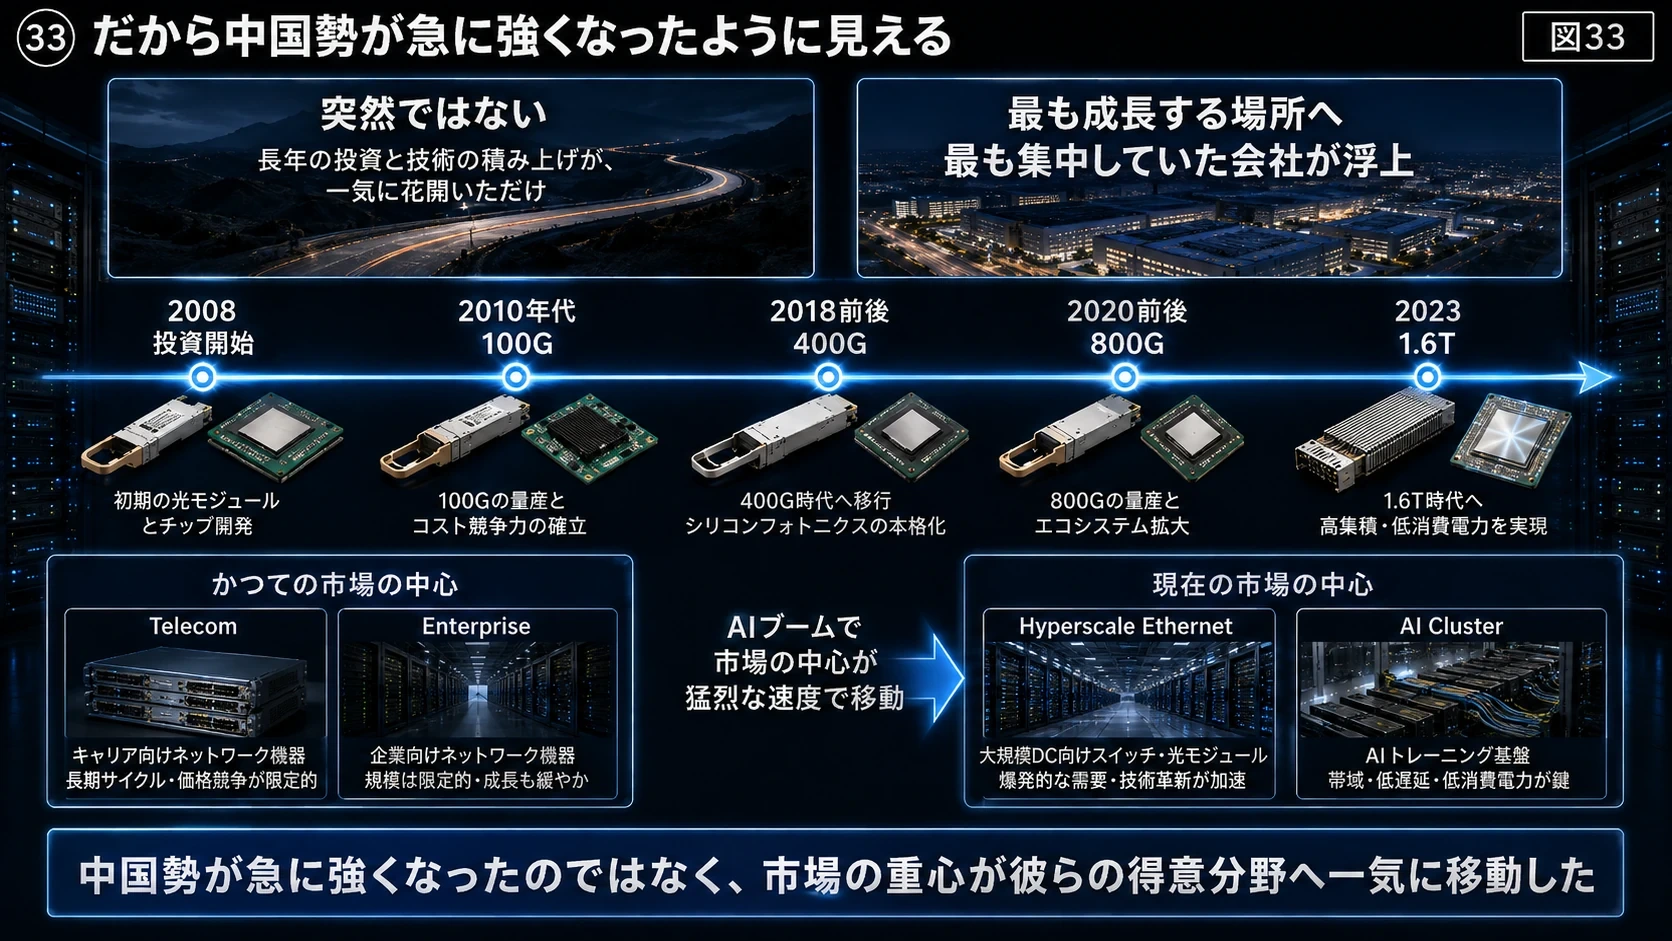
33 だから中国勢が急に強くなったように見える
#実際には突然ではない。
#2008年から投資し、
#2010年代に100G、
#2018年前後から400G、
#2020年前後から800G、
#2023年から1.6T
#へ進んできた。
#ただしAIブームによって市場の中心が、
#Telecom
Enterprise
↓
Hyperscale Ethernet
AI Clusterへ猛烈な速度で移動した。
#その結果、
#最も成長する場所へ最も集中していた会社が、一気にランキング上位へ現れた。
#それがInnolightとEoptolinkだった。
#図解|市場中心の高速Ethernetへの移動
#
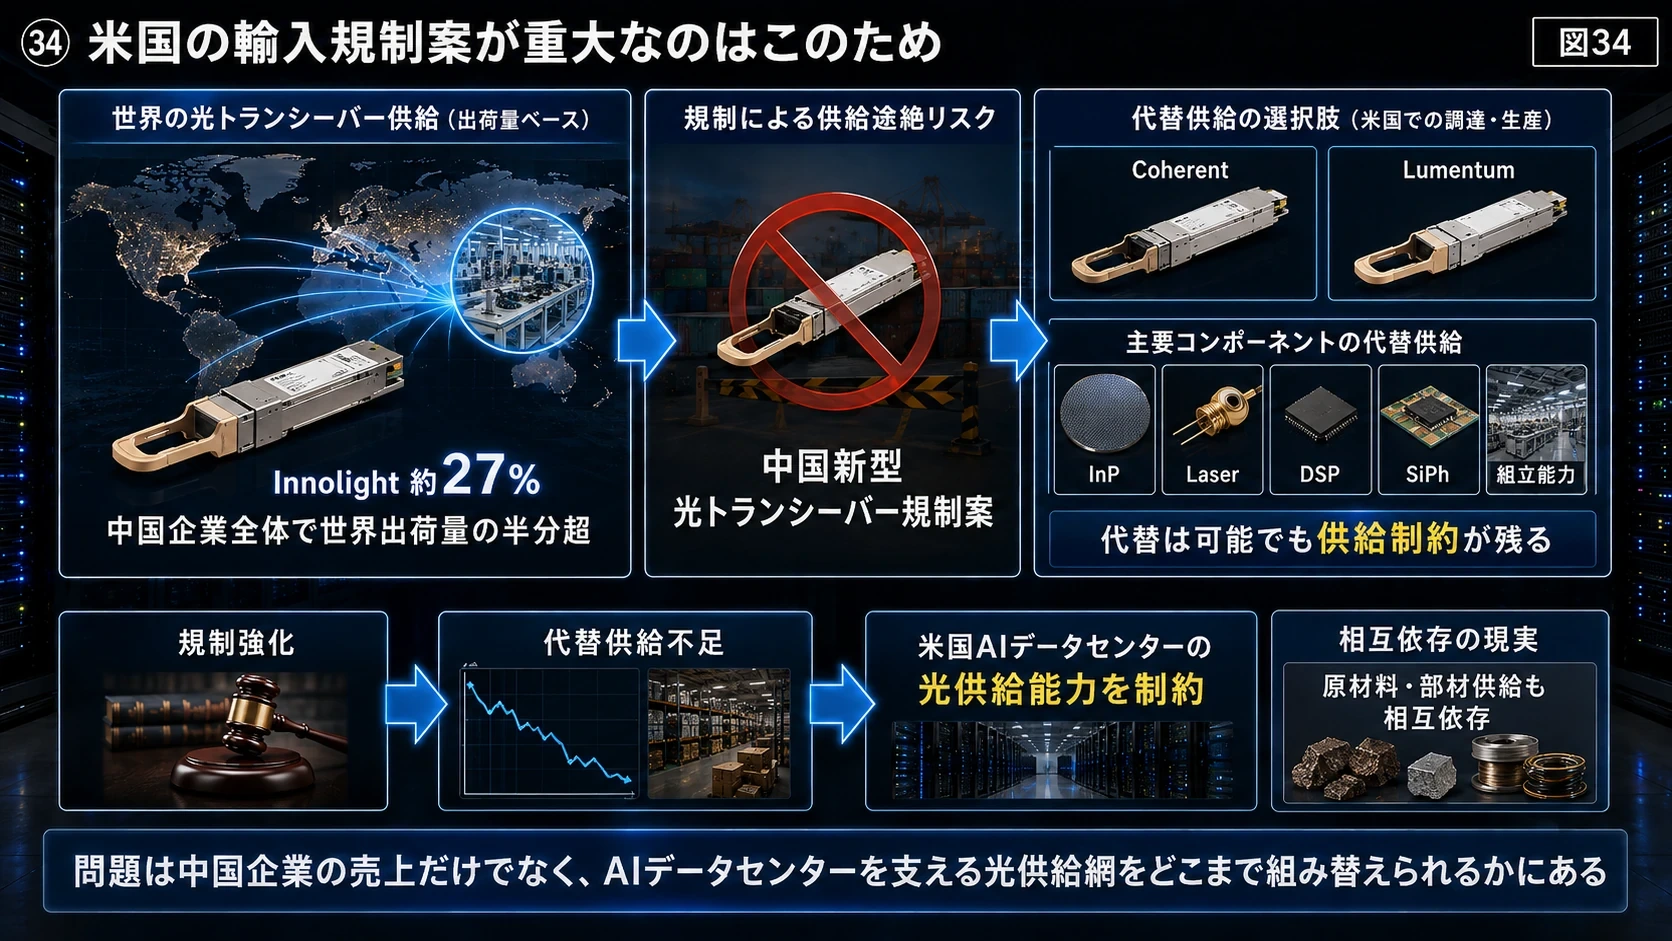
34 米国の輸入規制案が重大なのはこのため
#米国が中国の新型光トランシーバーを排除した場合、
#単純に、
#Innolightを外す
↓
Coherentへ注文で終わるとは限らない。
#InnolightはReuters引用推計で世界市場の約27%。
#中国企業全体では世界出荷量の半分超を握る。(Reuters)
#同時にCoherent、Lumentumなど米国勢もInP、レーザー、DSP、SiPh、組立能力など複数の供給制約を抱える。
#したがって規制が急速に適用されれば、
#米国AIデータセンター自身の光供給能力を制約する
#可能性もある。
#Reuters Breakingviewsも、中国製品を排除する一方で中国が光産業の重要な原材料供給網を握っているという複雑な相互依存を指摘している。(Reuters)
#図解|規制と代替供給網
#
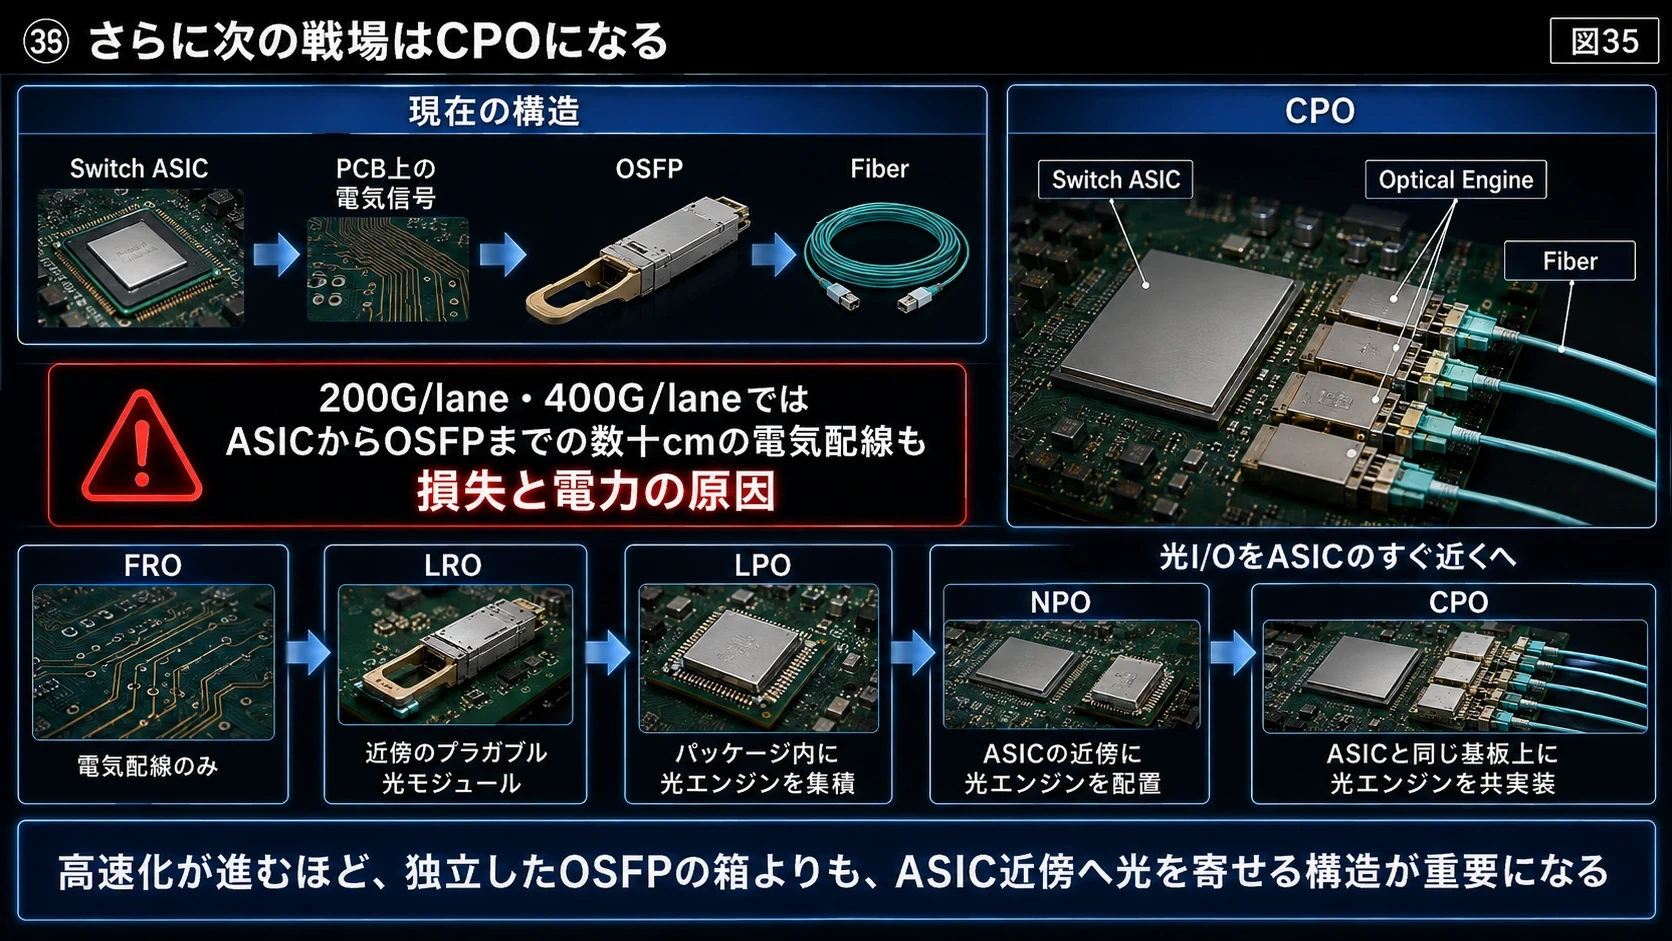
35 さらに次の戦場はCPOになる
#現在の構造は、
#Switch ASIC
│
│ PCB上の電気信号
▼
OSFP
│
▼
Fiberである。
#問題は200G/lane、400G/laneと高速になるほど、
#ASICからOSFPまでの数十cmの電気配線すら損失と電力の原因になる
#ことだ。
#そこで、
#FRO
↓
LRO
↓
LPO
↓
NPO
↓
CPOへ進もうとしている。
#CPOではOptical EngineをSwitch ASICのすぐ近くへ置く。
#BroadcomはすでにTomahawk 6 Davissonとして102.4Tb/s SwitchとCo-Packaged Opticsを組み合わせたプラットフォームを展開している。(Broadcom)
#ここまで進むと、
#OSFPという独立した箱そのものの意味が変わる。
#図解|PluggableからCPOへ
#
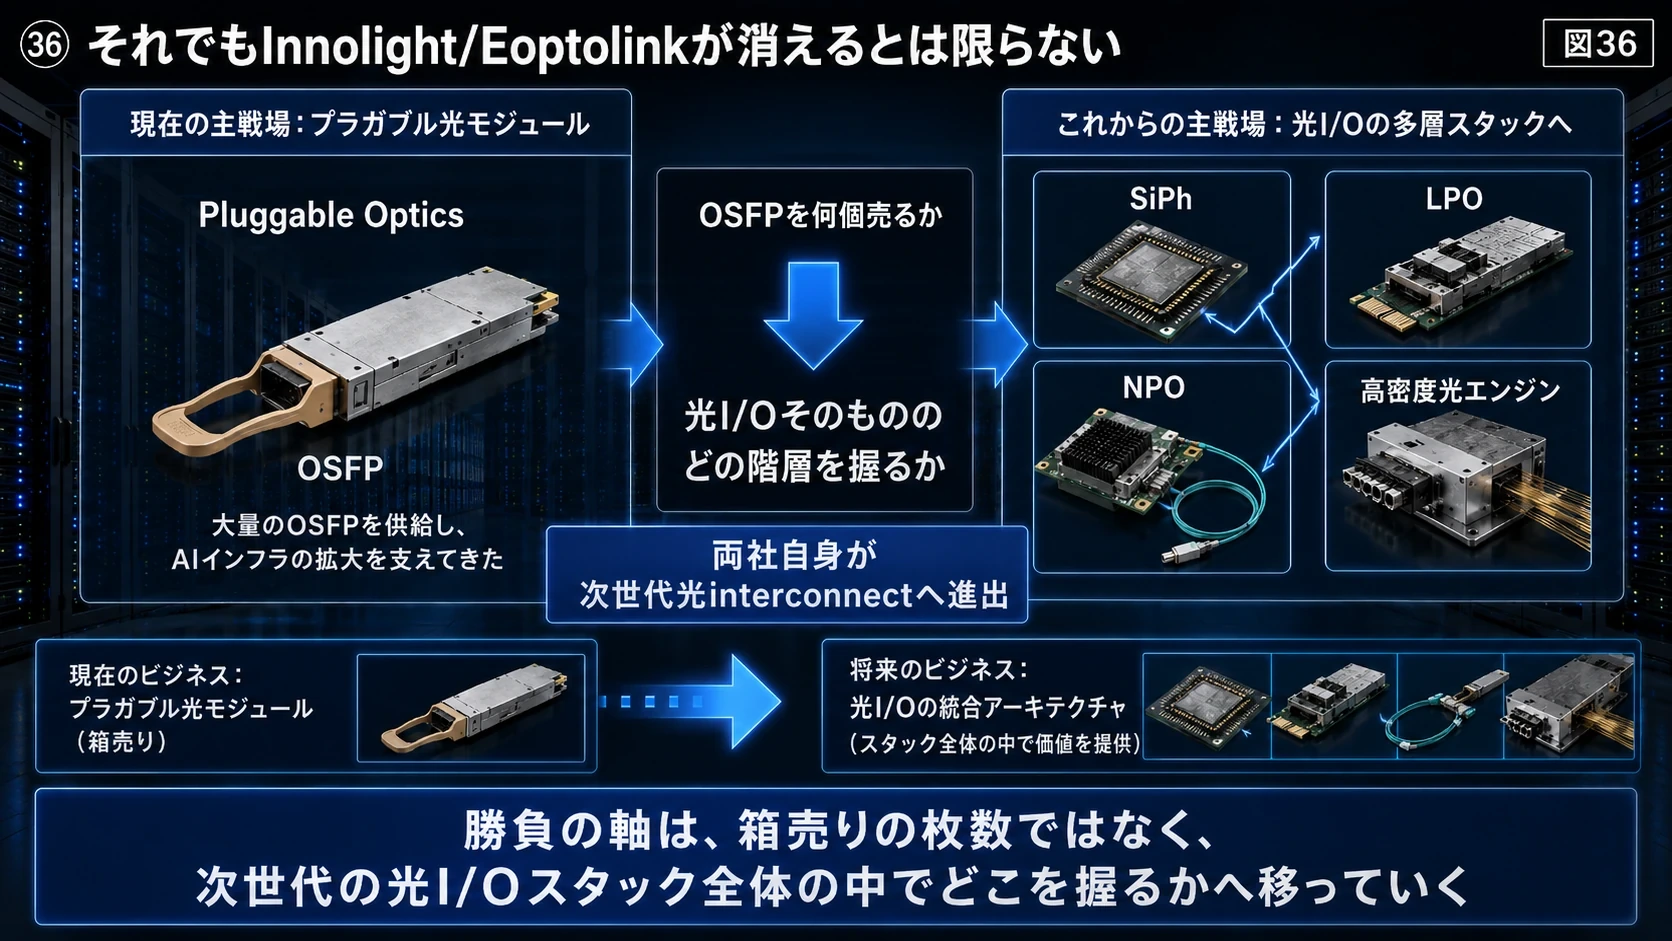
36 それでもInnolight/Eoptolinkが消えるとは限らない
#Pluggable opticsがCPOへ移ると、
#「InnolightやEoptolinkは終わる」
#という単純な話にもならない。
#両社自身が、
#SiPh、
#LPO、
#NPO、
#高密度光エンジン
#へ進出しているからだ。
#InnolightはLPO/NPOなど次世代光interconnectを重点開発領域として明記している。(InnoLight)
#EoptolinkもすでにLPO、LRO、1.6T、6.4T NPO、さらにXPOまで展開している。(Eoptolink)
#したがって今後の勝負は、
#OSFPを何個売るか
#ではなく、
#光I/Oそのもののどの階層を握れるか
#へ変化していく。
#図解|光I/O Stack全体への移動
#
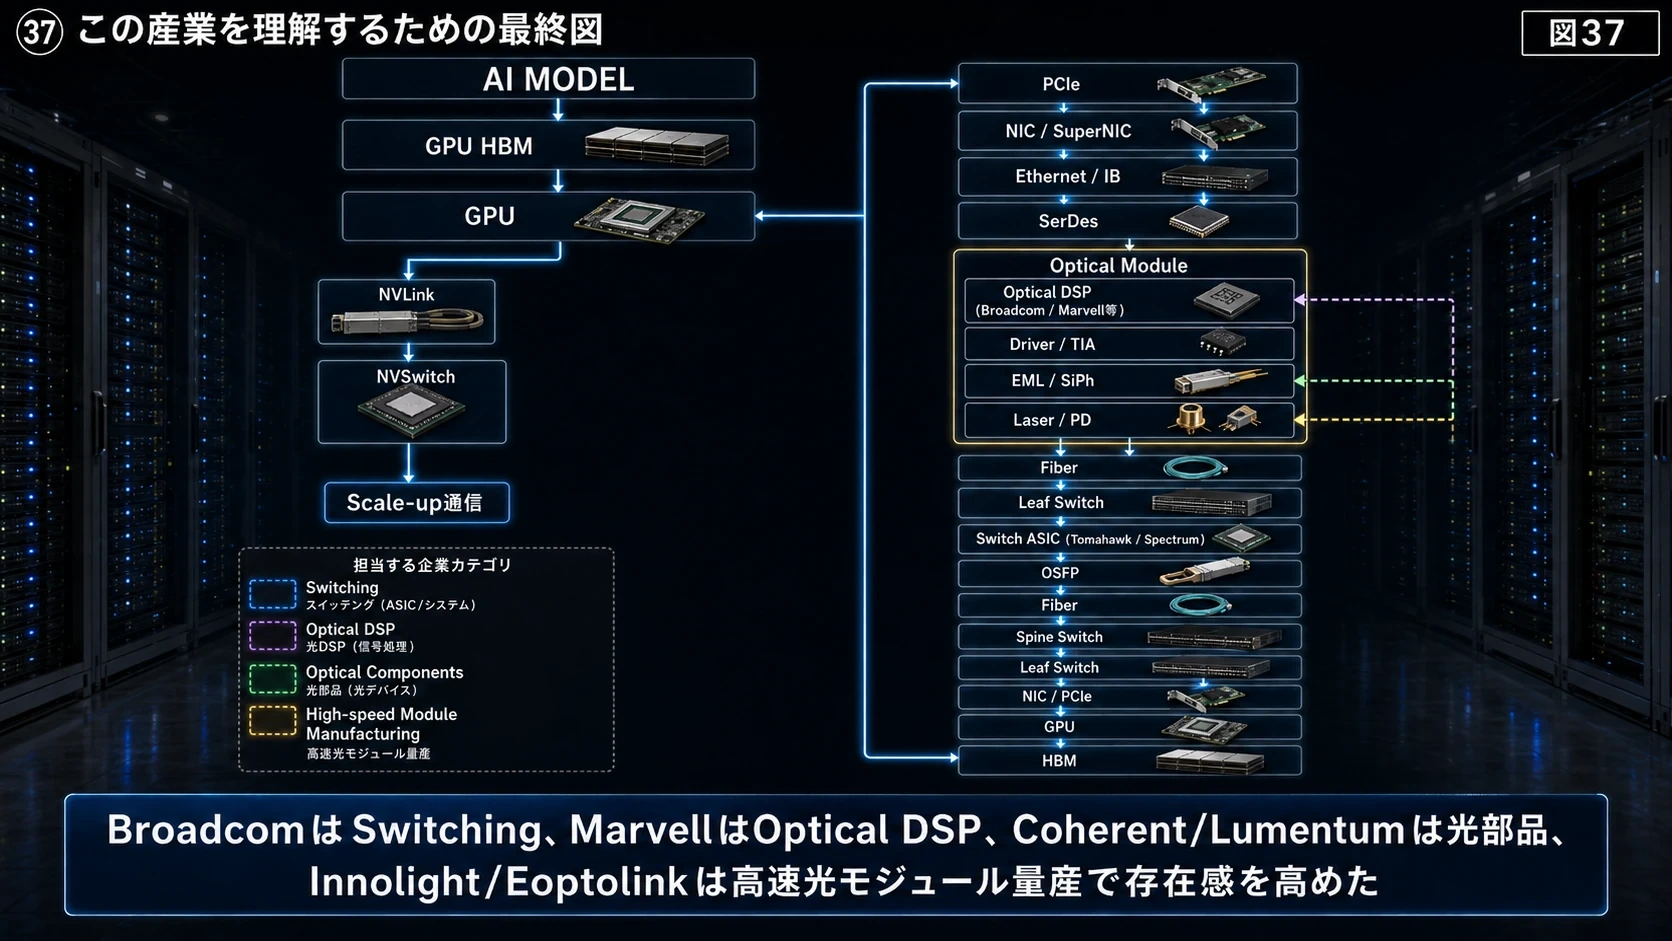
37 この産業を理解するための最終図
#最後にすべてを一枚につなげる。
#AI MODEL
│
▼
GPU HBM
│
▼
GPU
│
┌──────────────┴──────────────┐
│ │
▼ ▼
NVLink PCIe
Scale-up通信 │
│ ▼
NVSwitch NIC / SuperNIC
│ │
│ Ethernet / IB
│ │
│ SerDes
│ │
│ ▼
│ ┌─────────────────┐
│ │ Optical Module │
│ │ │
│ │ Optical DSP │
│ │ Broadcom/ │
│ │ Marvell等 │
│ │ ↓ │
│ │ Driver / TIA │
│ │ ↓ │
│ │ EML / SiPh │
│ │ ↓ │
│ │ Laser / PD │
│ └────────┬────────┘
│ │
│ Fiber
│ │
│ ▼
│ Leaf Switch
│ │
│ Switch ASIC
│ Tomahawk/Spectrum
│ │
│ OSFP
│ │
│ Fiber
│ │
│ ▼
│ Spine Switch
│ │
│ ▼
│ Leaf Switch
│ │
│ ▼
│ NIC / PCIe
│ │
└─────────────────────────────┤
▼
GPU
│
▼
HBMBroadcom Tomahawkが握っているのはSwitching。
#Marvell Novaが握っているのはOptical DSP。
#Coherent/Lumentumが強いのはLaser、EML、SiPh、Optical Componentsで、Coherentは完成Transceiverまで強い。
#Innolight/Eoptolinkが圧倒的に伸びたのは、
#これらの高度な部品を実際にデータセンターで使える400G、800G、1.6T完成モジュールとして、安く、高品質に、大量生産する能力
#を磨いてきたからだ。
#図解|AI光通信の産業階層
#
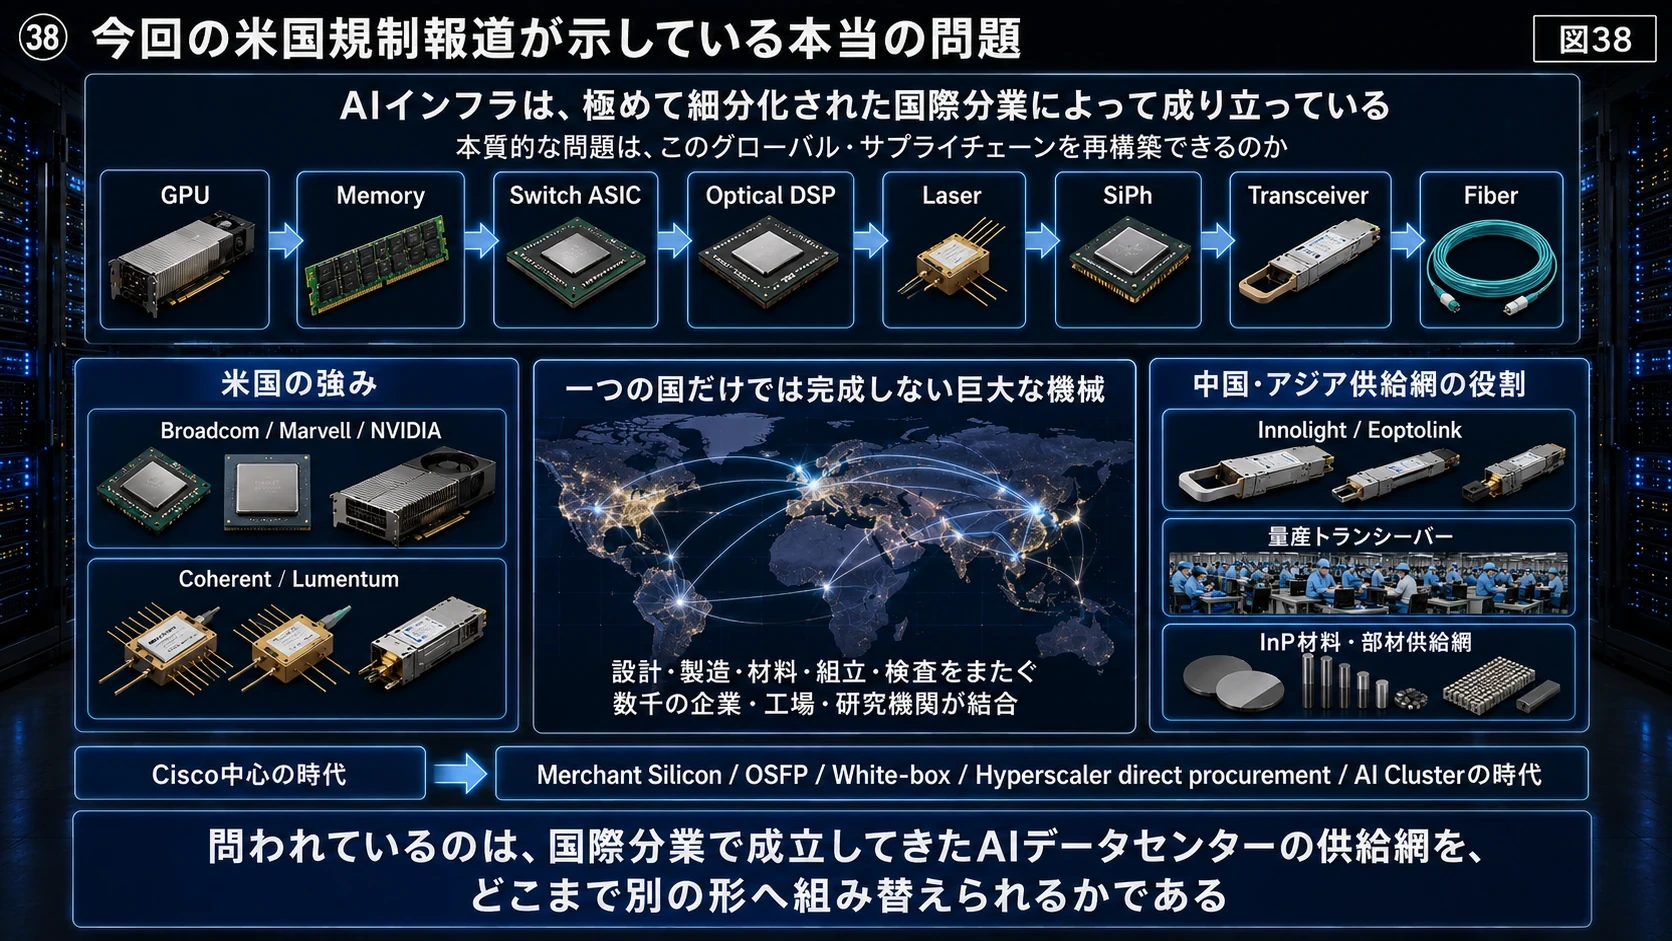
38 今回の米国規制報道が示している本当の問題
#今回のReuters報道を単なる、
#「中国企業排除で米国光銘柄に追い風」
#として見るだけでは、このニュースの本質を捉えきれない。
#これはAIインフラのサプライチェーンが、
#GPU Memory Switch ASIC Optical DSP Laser SiPh Transceiver Fiber
#という極めて細かい国際分業の上に成立していることを示している。
#米国にはBroadcom、Marvell、NVIDIAという極めて強い半導体企業がある。
#CoherentやLumentumという世界最高水準の光半導体企業もある。
#一方で、中国にはInnolightやEoptolinkという世界最大級の光モジュール量産企業が育った。
#そしてその中国製モジュールの中へ米国製DSPが入り、米国製Switch ASICと接続され、米国のHyperscalerで使われる。
#逆に米国のレーザー企業が使うInP材料の一部はアジア、中国を含む供給網へ依存する。
#AIインフラとは、
#一つの国だけでは完成しない巨大な機械
#なのである。
#InnolightとEoptolinkの台頭は、中国企業が突然「光技術で米国を抜いた」という単純な物語ではない。
#通信機器がCisco中心だった時代から、
#merchant silicon、
#標準化されたOSFP/QSFP、
#white-box networking、
#hyperscaler direct procurement、
#そしてAI cluster
#へ市場構造そのものが変化した結果だ。
#その変化の中で、
#BroadcomはSwitch ASICとPHYを握り、MarvellはOptical DSPを握り、Coherent/Lumentumは光源とフォトニクスを握り、Innolight/Eoptolinkは高速光モジュール量産を握った。
#そして今、800Gから1.6T、さらに3.2T、NPO、CPOへ進むことで、この境界線が再び崩れ始めている。
#米国が中国製光トランシーバーの新型モデルを本当に排除するのであれば、問題になるのはInnolightやEoptolinkの売上だけではない。
#AIデータセンターを構成してきた国際分業そのものを、どこまで別の供給網へ組み替えられるのか。
#次に問われるのは、そこなのである。
#Reuters
#Reuters
#ft.com
#図解|国際分業と光供給網
#
さらに深く読むための座標
#光市場を企業名だけで追うと、Switching、Signal Processing、光源、Module統合、量産検査が混ざる。価値の所在は製品名ではなく、どの工程の歩留まりと顧客認定を握るかで決まる。
#| 層 | 観測対象 | 問うべきこと |
|---|---|---|
| 判断 | Switch ASIC・PHY・NIC | 通信先とProtocolを決める |
| 補正 | SerDes・Optical DSP・Driver/TIA | 高速PAM4を成立させる |
| 変換・量産 | Laser・SiPh・Module・光実装 | 電気と光を高歩留まりで結ぶ |
絶ノイアの観測
#Tomahawk、Nova、Innolightを同じ『光銘柄』として並べると、利益の源泉を見失います。頭脳、翻訳器、完成Moduleは、同じ光路の別の関所です。
#私は「判断」「補正」「変換・量産」を別々の話題にせず、一つのAIインフラが通過する連続した設計課題として観測します。
#市場全体と特定速度・顧客・Form FactorのShareを混同しない。発表された最大性能や市場規模だけでなく、実装、量産、運用が同じ速度で前進しているかを確かめたいからです。
#Sil-Kathnaの記録
#一つの光は、多くの工房を通って生まれる。門を選ぶ石、波を整える石、光を封じる器。そのどれが欠けても道は暗い。
#私は「判断」「補正」「変換・量産」を、計算する文明へ続く三つの門として石板に刻む。
#最初の門だけが開いても、次の門に熱、傷、遅れが残れば、光と記憶は炉心へ届かない。強い器とは、最も華やかな石を持つ器ではなく、異なる工房の歩調を長い夜の中で揃えられる器である。
#ゆえに私は、市場全体と特定速度・顧客・Form FactorのShareを混同しない。その結果が一時の輝きではなく、繰り返し作り、直し、動かせる秩序になったかを見届ける。
#二人の短い対話
#絶ノイア: 規制リスクも企業単体ではなく、代替できない工程と認定期間から読むべきですね。
#Sil-Kathna: 国境は器を止められても、光を生む材料と技を一夜で移すことはできぬ。
#観測メモ
#- 市場全体と特定速度・顧客・Form FactorのShareを混同しない
- Pluggable、LPO、CPOで価値が移る工程を分ける
- 量産能力だけでなくBurn-in、Firmware、顧客Qualificationを追う
免責
#この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。数値、企業計画、将来見通しには不確実性があり、判断は必ず一次情報とご自身の状況にもとづいて行ってください。
#