AIデータセンター・ネットワークの基本入門
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
2bd141ad6707879bd14b207ba7bd6670b1739cc62e873750a608b2d8ae127736- 保存版のSHA-256
b8912cf48d8097fae70e606ed139d2631209b4fbdc1994d6a8998615da0d7c8f
外部証明の最終検査結果は詳細を開くと表示します。
NICの種類とつなぎ方/OSI参照モデル/スイッチとルーター/QSFP-DD・OSFP/CPO/Spectrum-X・Quantum-X/Tomahawk6/Marvell NOVA/NVLinkとの違い、「光化」とHBMの距離感まで
#この記事はnote向けに、基礎→図解→最新製品の順で“通しで読める”ように作りました。専門用語はその場で噛み砕いて定義します。#
#
\0. 全体像(いきなりイメージ)
#[GPU/CPUサーバ]─(PCIe)─[NIC/SmartNIC]──┐
│ ← ここで「電気→光」に変換(プラガブル光 or CPO)
[ 光ファイバ ]
│
[ スイッチ ]─────[ スイッチ ]─────[他サーバ/ストレージ]
│
[ ルーター ]──(他ネットワーク/インターネット)- NIC:PCIeに差してケーブルで繋ぐ
- スイッチ:NICに繋いだケーブルをスイッチで繋いで他サーバーと繋ぎネットワークを構築する(主にL2〜一部L3)、ルーターのような機能を持ったスイッチもある
- ルーター:他のネットワーク同士をつなぐ(L3)
- 光:NICポート/スイッチポートで電気⇄光を変換し、光ファイバで長距離・大容量化
#
\1. 用語のいまさら基礎
#- ToR(Top-of-Rack):ラック最上段などに置く集線スイッチ。各サーバのNICからToRへ張り、ToR同士を上位(Leaf/Spine)へ。
- NIC(Network Interface Card):
- 標準NIC…L2〜L4の定番オフロード(チェックサム、TSO/GRO、RSSなど)。
- CNA(Converged Network Adapter)…EthernetにストレージI/O(iSCSI/FCoE/NVMe-oF)を統合。
- SmartNIC / DPU…NIC上にCPU/アクセラレータを載せ、TLS/IPsec、仮想化、観測、時にL7処理まで肩代わり。
- QSFP-DD / OSFP(光モジュールの“差し込み口”の型):どちらも400G/800G世代で主役。OSFPの方が筐体が大きく熱余裕(≒許容電力)が高い傾向。代表的な目安としてQSFP-DDは~12W、OSFPは~15W級と言われます(実機はベンダ/世代で増減)。 (6COM)
#
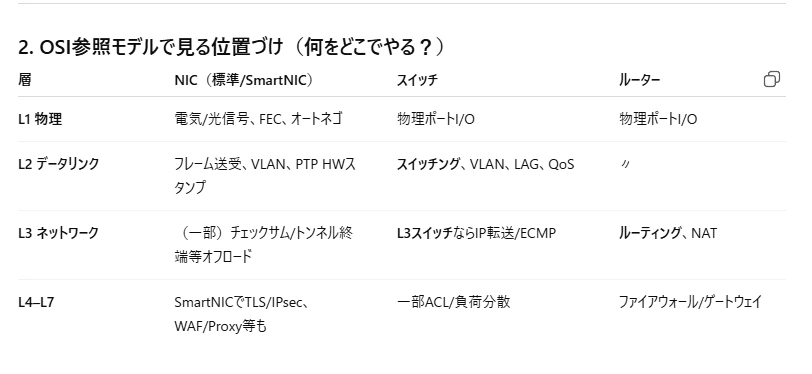
\2. OSI参照モデルで見る位置づけ(何をどこでやる?)
#
#
\3. つなぎ方(電気→光のポイント)
#プラガブル光(主流)
#前面パネルにQSFP-DD/OSFP等のプラガブル光モジュールを挿して“電気⇄光”を変換。光ファイバでToR/Leaf/Spineへ。 距離のだいたい:SR(〜70–150m)/DR(〜500m)/FR(〜2km)/LR(〜10km)/ZR(〜80km, DCI向けコヒーレント)。
#- SR = Short Reach(短距離・主にMMF。例:100m/150m級) NVIDIA Docs+1
- DR = Datacenter Reach(SMF 500 m)※100GBASE-DRなど。 CommScope+1
- FR = Fiber Reach(SMF 2 km。ベンダによって“Far Reach/Range”表記も) CommScope+1
- LR = Long Reach(SMF 10 km) NVIDIA Docs+1
- ZR = ZR(OIF 400ZR等):コヒーレントで80 km程度のDCI向け。 ciena.com
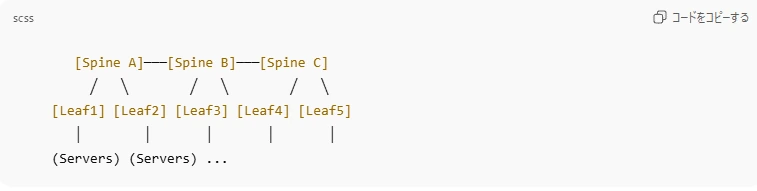
Leaf / Spine とは?
#データセンターで主流の2層(ツー・レイヤ)トポロジ
#Leaf(リーフ)=サーバにつながる“末端スイッチ”(ToR/アクセス層)。
#- Spine(スパイン)=Leaf同士を全結合でつなぐ“背骨スイッチ”(コア/アグリ層)。
- すべてのLeafがすべてのSpineに接続し、L3のECMPで均等分散&高速収束する。
CPO(Co-Packaged Optics:次の主役)
#スイッチASICの“すぐ横”に光エンジンを内蔵し、電気配線を極短にして**帯域密度↑・電力↓・信号品質↑**を狙う実装。OIFがフレームワーク文書で適用領域や設計要件を整理している。 (oiforum.com)
#プラガブル光とCPOの違い
#一言で
#- プラガブル光:前面パネルの“差し口”に着脱式カートリッジを挿す方式。
- CPO(Co-Packaged Optics):スイッチ/NICのASICに超近接して光トランシーバを同一パッケージ(あるいは同一基板上の極近距離)に統合する方式。
(プラガブル)
ASIC ──(長めの電気配線/基板/リタイマ)── [前面の光モジュール] ⇄ 光ファイバ

(CPO)
[ASIC][光エンジン群] ─(極短電気/直結)─ 光ファイバ ※前面モジュールなし3つの実装レベル(位置関係の違い)
#- Pluggable optics(従来主流)
- QSFP/OSFP など“差し替え式”。サービス性◎(故障時に現場交換)。
- ASIC〜前面モジュール間は高速電気配線が必要→信号損失・電力上昇・リタイマが課題になりやすい。
- 100/200/400/800G 世代の多くがこれ。最近は**LPO(Linear-drive)**でモジュール側DSPを省き省電力化する流れも。
- On-board/Near-packaged optics(中間形態)
- 基板上でASICの近くに光トランシーバを実装(ただし着脱式ではない)。
- 電気経路が短くなり、損失/電力を抑えやすいが、現場交換性は下がる。
- CPO(Co-Packaged Optics)
- 光エンジンをASICと同じパッケージ内(またはインターポーザ直結)に統合。
- 電気配線が最短になり帯域/電力/密度に有利(224G/lane 以降に特に効く)。
- ただしサービス性×(故障時は基板/ラインカードごと交換)、実装・熱設計・歩留まりが難しい。
どこで使われる?
#- スイッチ:ポート密度/消費電力が限界に近づく高速世代でCPOが有力候補。現行主流は依然プラガブル。
- NIC/SmartNIC:多くはプラガブル。将来の超高速世代でNPO/CPO検討の余地はあるが、現場交換性の観点でプラガブル優位が続く見込み。
それぞれの利点・弱点(要点)
#- プラガブル:交換・在庫運用が簡単/ベンダ選択肢が広い ←→ 電気配線が長く電力・信号品質のコストが増えがち。
- CPO:電力・帯域密度・到達で有利、前面ポートの混雑も回避 ←→ フィールド交換不可、実装難易度/サーマル/歩留まりの課題。
まとめ
#- プラガブル光モジュール ≠ CPO。
- いま一般的に使っている“差し込み式の光”はプラガブル、将来の超高速・超高密度向けにCPO(やその中間形態)が検討・導入されている、という位置づけです。
- いま(2025年)主流:プラガブル光(QSFP-DD/OSFP)。800G実用、1.6Tは20–30W級で立ち上がり。(OSFPmsa)
- 次に来る:CPO(Co-Packaged Optics)。スイッチ側から商用化が始まり、NVIDIAはIBが2025年内、Ethernetは2026年の提供計画を公表。(NVIDIA Corporation)
並べて比較(要点)
#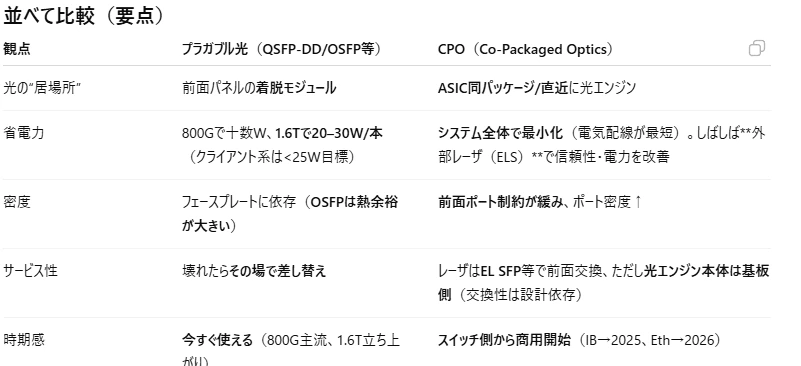
- 1.6Tプラガブルの目安:クライアント用途 <25W、DCIのコヒーレントで 35–40W とされる見積り。(OSFPmsa)
- OSFPとQSFP-DD:QSFP-DDは熱許容7–12W、OSFPは12–15W程度の設計ガイドがよく引用されます(世代/ベンダで差)。(HeyOptics)
- CPOの外部レーザ(ELS):前面ホットスワップで信頼性と保守性を上げる狙い(OIFのELSFP規格)。(oiforum.com)
直感メモ:プラガブル=整備性◎、CPO=電力/密度◎。世代が上がるほどスイッチ側からCPOが利きやすい。#
最近のトレンド(LPOも一言)
#- LPO(Linear Pluggable Optics):モジュール内のDSPを省くことで電力・遅延・コストを低減する流れ。OFC 2024/2025で各社デモ、資料ではDSP付き比で最大約50%省電力という言及も。用途は短〜中距離のデータセンター内リンクが中心。(eps.ieee.org)
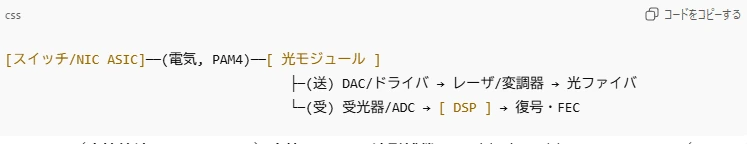
DSPとは 高速な電気/光リンクのひずみやノイズをデジタル処理で補正し、ビットを正しく復元・送出する頭脳 ネットワーキングでは光モジュール(QSFP-DD/OSFP 等)やコヒーレントモジュール、スイッチ/NICのPHYの中に入り、等化・誤り訂正・クロック回復などを超高速で行う
#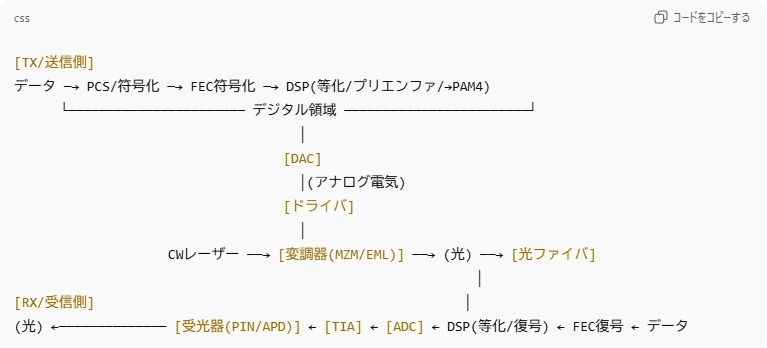
1) PAM4(Pulse Amplitude Modulation 4-Level)
#- 4段階の振幅で1シンボルあたり2bitを運ぶ方式。
- 例:100G/レーンなら53.125 GBd × 2bit = 106.25 Gb/s(生の線レート)。そこからFEC等のオーバーヘッドを引いて実効100Gに整える。
- メリット:レーン数を増やさずにスループットを二倍化。デメリット:S/Nが厳しい(レベル間隔が狭い)=等化・FECが重要。
2) 光モジュール(QSFP-DD/OSFP など)
#- スイッチ/NICのポートに挿す着脱式カートリッジ。中にDSP、DAC/ADC、ドライバ/TIA、レーザー、変調器、受光器などが詰まっている(LPOはDSPを省く)。
- “電気↔光”を変換し、光ファイバで遠くまで飛ばす。
3) DAC(Digital-to-Analog Converter)
#- DSPが作ったデジタル波形をアナログ電気信号に変える。
- PAM4の理想波形に近づけるための精密な変換器。
4) ドライバ(Laser/Modulator Driver)
#- 変調器を揺さぶるため、振幅(電圧/電流)を増幅する“パワーアンプ”。
- 伝送路の高周波特性に合わせ、プリエンファシス(高域持ち上げ)も併用。
5) レーザー(CWレーザ)
#- **連続光(Continuous Wave)**を出す光源。
- 変調器でこの光の**強度(IM-DD)や位相/周波数(コヒーレント)**を刻む。
6) 変調器(Modulator:EML/MZM/SiPh)
#- 光に情報を刻む部品。
- EML(電界吸収型変調器):レーザと一体。小型で短〜中距離に好適。
- MZM(Mach-Zehnder)/Siフォト:外付けでリニア特性◎、高速・長距離に強い。
7) 光ファイバ(SMF/MMF)
#- 光を通す“道”。SMF(単一モード)はDR/FR/LRなどの中距離〜長距離、MMF(多モード)はSRなど短距離で低コスト。
- 曲げ・接続損失・分散がS/Nを削るので、FECや等化で救う。
8) 受光器(Photodetector:PIN/APD)
#- 光を電流に変える“フォトダイオード”。
- PIN:低雑音で一般的。
- APD:内部増倍で感度↑(雑音・電圧要件は上がる)。
9) ADC(Analog-to-Digital Converter)
#- 受けたアナログ電気信号をデジタルに。
- その後、DSPが等化(FFE/DFE/CTLE)やタイミング回復(CDR)、PAM4復号を行う。
10) 復号(Decoding)
#- PAM4 → bitへの写像、タイミング復元、スライス判定、シンボル誤りの推定/補正などDSP処理の総称。
- コヒーレントでは、さらに位相/偏波までデジタル復元する(I/Q復調+DSP)。
11) FEC(Forward Error Correction:前方誤り訂正)
#- 送信側で冗長ビットを付与、受信側で誤りを自動訂正。
- PAM4のIM-DDでは主にRS-FEC(Reed-Solomon)(オーバーヘッドは数%台)。
- コヒーレントではより強力なSD-FEC(ソフト判定FEC)(オーバーヘッドは大きいが長距離が可能)。
#
ベンダー横断の「いま」(2024–2026)
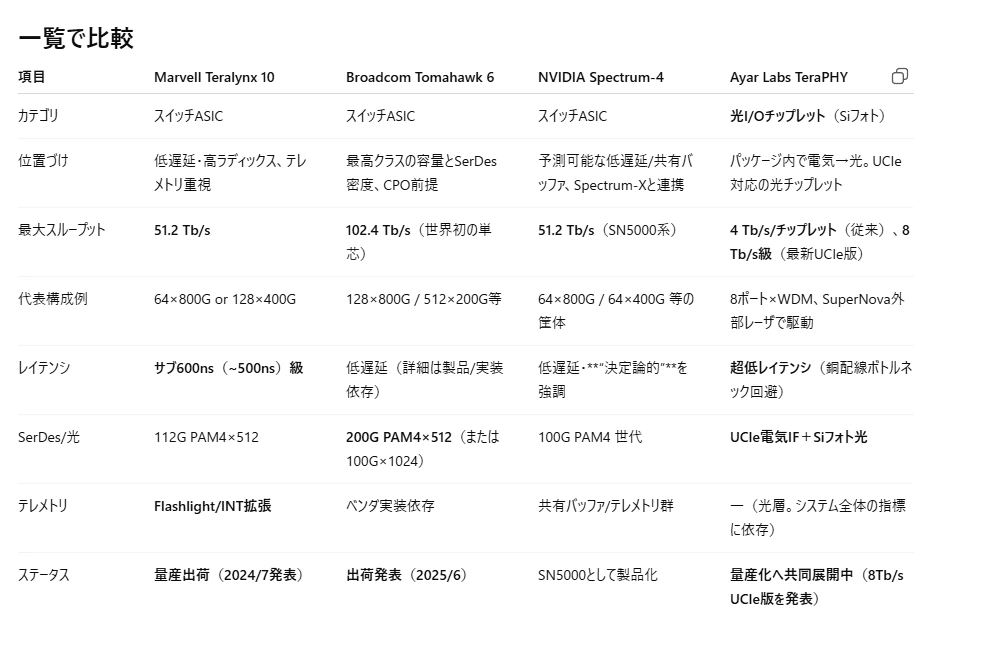
#NVIDIA(スイッチ×CPO)
#- CPO統合スイッチを公式発表。Quantum-X Photonics(InfiniBand)は2025年内、Spectrum-X Photonics(Ethernet)は2026年に提供予定。(NVIDIA Corporation)
- 一部報道/技術解説では、Spectrum-6世代で102.4Tb/sクラスや128×800Gなどの構成、液冷採用とともにCPO前提の設計像を紹介。(Tom's Hardware)
Broadcom(Tomahawkファミリ)
#- Tomahawk 6が単芯102.4Tb/sで出荷中。設計としてCPOオプションのサポートが強調され、ポート密度と電力の壁を越える世代に。(Broadcom Investors)
Marvell(NOVA=光DSP)
#- Nova(初代):1.6T光DSP(100G電気/200G光)GA、
Nova 2:1.6T光DSPで200G電気/200G光のフル200G/レーン対応を発表(サンプリング)。800G/1.6T時代のプラガブル/線形駆動を下支え。(Marvell)
- コヒーレントDSP:Orion(800G) & プラガブル:COLORZ 800(ZR/ZR+)
800G ZR/ZR+のQSFP-DD/OSFPを自社プラットフォームで提供。~1000–1200kmクラスのDCIを狙う。
- Marvell Teralynx 10(51.2T)
- 低遅延×高ラディックスでAIクラスタのLeaf/Spineに最適。Flashlight™など緻密なテレメトリやINT拡張がウリ。64×800G/128×400Gを1チップで構成可能、2024年に量産入り。
Ranovus × Jabil(CPO部材の量産体制)
#- ODIN光エンジンの**量産(マスプロ)**をJabilと発表。**CPO/NPO用“心臓部”**の供給体制が整う。(Ranovus)
AMD(ネットワークI/OとCPO周辺エコシステム)
#- ネットワーク側:Pensando DPUを継続強化(デュアル200G級、スイッチ組み込み事例も)。CiscoはSilicon One+AMD Pensando DPUの“スマートスイッチ”を発表。(AMD)
- 光I/Oエコシステム:Ayar Labsへの出資・協業の文脈で、**パッケージ内光I/O(CPO/光チップレット)の将来像にコミット。AyarはTeraPHY(UCIe対応)**等を推進し、Alchip/TSMCと量産に向けた取り組みも公表。(optics.org)
※AMD自身がCPOスイッチを出すわけではないが、DPU(NIC)と光I/Oのパートナー戦略でエコシステムに乗っている、という立ち位置。
#
参考リンク(一次情報中心)
#- NVIDIA:**Spectrum-X Photonics(2026)/Quantum-X Photonics(2025)**の公式発表。(NVIDIA Corporation)
- Tomahawk 6:102.4Tb/s出荷ニュース。(Broadcom Investors)
- Marvell NOVA/NOVA2:1.6T光DSP(Nova GA/Nova2 sampling)。(Marvell)
- OIF CPO/ELS:CPOフレームワーク/ELSFP実装合意。(oiforum.com)
- 1.6Tモジュール電力の目安:OSFP MSA/ベンダ技術資料。(OSFPmsa)
- AMD×Pensando/Ayar Labs:DPUと光I/Oの最新動向。(investor.cisco.com)
#
\4. 最新プロダクトで見る“いま”
#- NVIDIA CPOスイッチ
- Quantum-X Photonics(InfiniBand):2025年内に提供見込み(OEM経由)。
- Spectrum-X Photonics(Ethernet):2026年に提供。
公式ニュースリリースで発表・時期が明記されています。 (NVIDIA Corporation)
- Broadcom Tomahawk 6(スイッチASIC)
単芯102.4 Tb/sを出荷。“CPOサポート”を前提とする世代としてアナウンス。 (investors.broadcom.com)
- Marvell NOVA 2(PAM4光DSP)
1.6Tクラス/200G/レーン対応の光DSP。800G/1.6Tのプラガブル/線形駆動系を下支え。 (Marvell)
#ざっくり覚え方:「今日」はプラガブルが主流、「次」はスイッチ側からCPOが立ち上がる——その“心臓”が光DSP(例:NOVA)。#
#
\5. NVLink と Ethernet/InfiniBand の違い(役割と距離)
#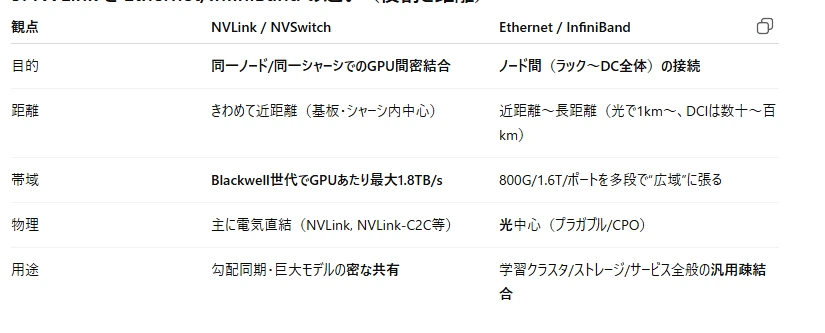
たとえ:NVLink=臓器を結ぶ“太い血管”、Ethernet/IB=都市をつなぐ“道路網”。 (NVLink帯域の代表値はNVIDIA公式の最新ページに明記) (NVIDIA)#
#
\6. 「光にする」とメモリ階層はこう見える(距離感の掴み方)
#近い(ns) 中くらい(µs未満〜数µs) 遠い(>数µs〜ms)
┌─────────┬───────────────────────┬───────────────────────────┐
│ ローカルHBM │ リモートHBM(NVLink/NVSwitch) │ さらに遠いメモリ(CXL/ネット越し) │
└─────────┴───────────────────────┴───────────────────────────┘
帯域:最大 帯域:とても大(ただし共有/輻輳に注意) 帯域:用途依存(RDMA/圧縮で工夫)
遅延:最小 遅延:ローカルより増(同期設計がカギ) 遅延:桁が上がる(配置戦略が命)- ローカルHBM…“一番近い冷蔵庫”。ここに一番頻繁に使うデータを置く。
- リモートHBM(同シャーシの他GPUのHBM)…NVLink/NVSwitchで“隣の部屋の冷蔵庫”。太いが取りに行くコストは増える。 (NVIDIA)
- さらに遠いメモリ(CXLメモリ、NVMe-oFキャッシュ、Ethernet/IB越しKVなど)…“廊下の向こうの倉庫”。光で距離は稼げるが遅延が桁で増えるので、頻度/粒度/耐遅延性でデータを住み分ける。
#
\7. 実機の“つなぎ方”テンプレ(AIクラスタ最小構成)
#[GPU×8 サーバ]──(800G: QSFP-DD/OSFP)──[ToR]
│ │
(シャーシ内 NVLink/NVSwitch) ├──[Leaf/Spine]──[ストレージ: NVMe-oF など]
└──(管理/同期: PTP)───────────────────────────────────┘- ケーブリング:〜500mならDR(SMF)、〜2kmならFR、ラック内短距離はDAC/AEC/AOC。
- 運用の要:PTP(時刻同期)、ECN/PFC(輻輳制御)、DDM/DOM(光パワー監視)。
- 将来:スイッチ側CPOへ置き換え→ポート密度↑/電力↓(NVIDIA CPOスイッチはIBが先行、Ethは2026)。 (NVIDIA Corporation)
#
\8. “数字”で掴む現在地(2025年基準)
#- スイッチASIC:Broadcom Tomahawk6=102.4 Tb/sを単芯で達成(出荷中)。CPO対応世代。 (investors.broadcom.com)
- NVIDIA CPOスイッチ:Quantum-X Photonics(2025年内)/Spectrum-X Photonics(2026年)。 (NVIDIA Corporation)
- 光DSP:Marvell NOVA 2=1.6T/200Gレーン。Nova(初代)は100G電気/200G光構成でGA、Nova2はサンプリング。 (Marvell)
- NVLink(Blackwell):GPUあたり最大1.8TB/sのNVLink帯域を公式掲示。 (NVIDIA)
#
サムネ pixai sunflower
#