AIDCは本当に余るのか――GWでは見えない「AI Factoryの質」を測る
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM 光接続 電力・給電 AI推論 AIエージェント
この資料を根拠にした分析カード(試験中): QAC-GW――用途をそろえて実効計算能力を見る
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
c199b46ce7d5f3677ac3bc354e4e8f2257c3d122e75a6e71fb33760041826b55- 保存版のSHA-256
057e1aac066b22be18ffdfff315cc39bb12efcc15ba2f5d7534b1d28812a9069
外部証明の最終検査結果は詳細を開くと表示します。
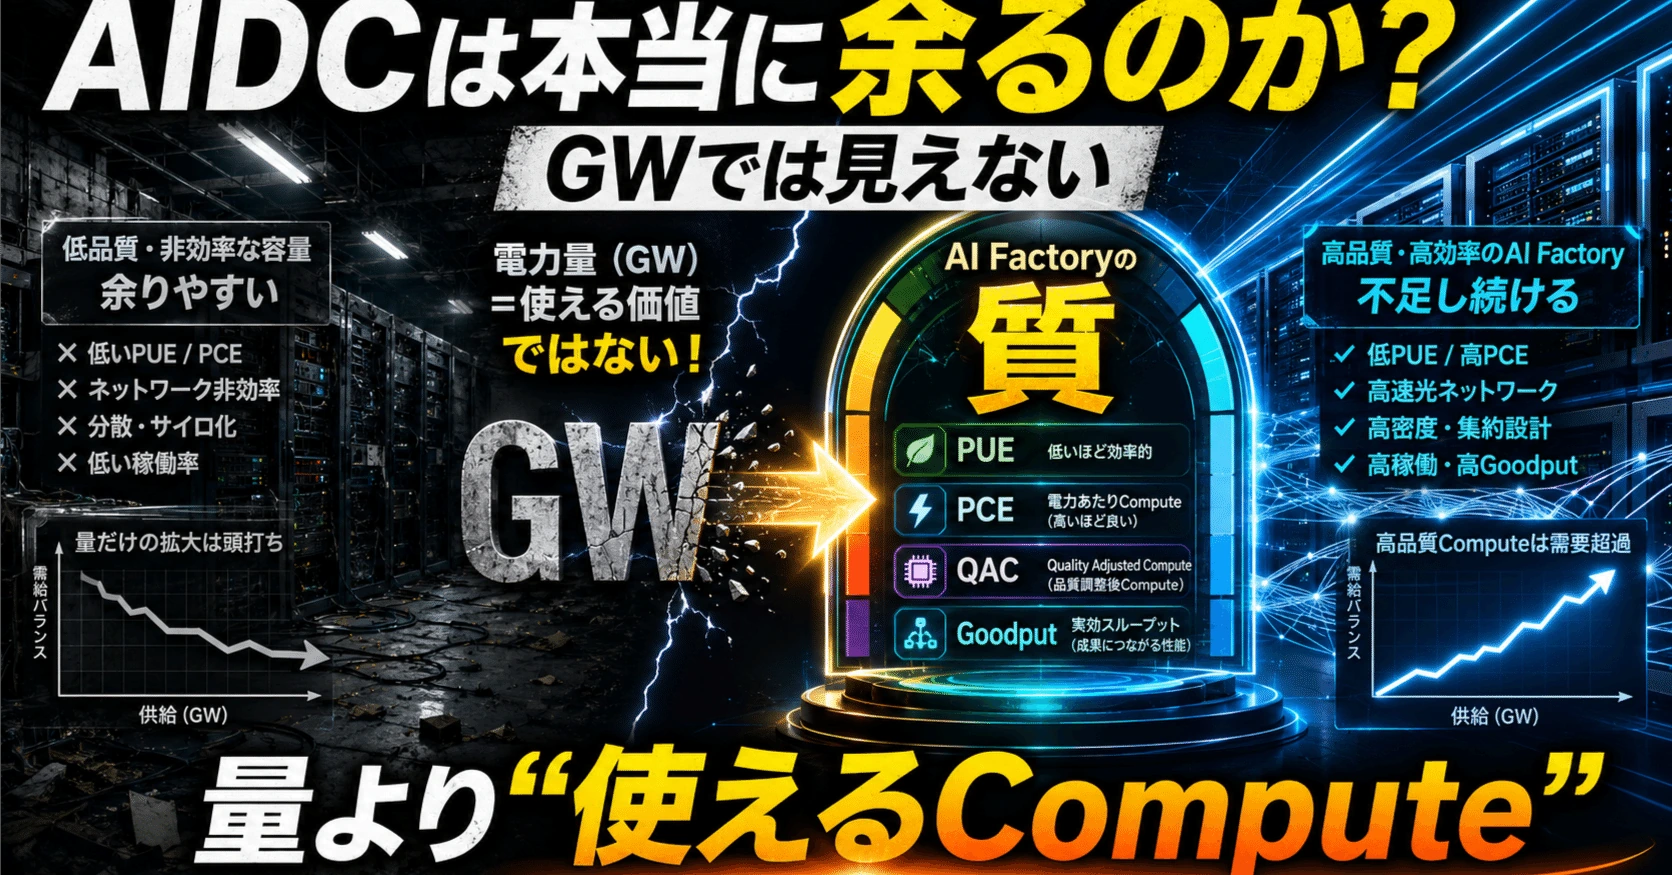
AIDCは本当に余るのか――GWでは見えない「AI Factoryの質」を測る
#1GWの電力から、どれだけの「使えるCompute」「売れるCompute」「知能」を作れるのか
#AI Data Centerについて考えるとき、最もよく使われる数字がある。
#GW。
#「2030年までに50GW建つ」
#「100GWのPipelineがある」
#「この企業は10GWを確保する」
#こうした数字は非常に分かりやすい。
#しかし、本当にこれだけでAIDCの供給過剰や不足を判断できるのだろうか。
#8月14日の記事では、金融市場が約80GW規模のAI InfrastructureをFinanceできる一方、2030年までに実際にOnlineにできるのはBaseで45~50GW程度ではないか、と考えた。
#https://note.com/atom_/n/n9fd1147469e2
#しかし、その分析をさらに進めると、もう一つ問題が出てくる。
#50GWのAIDCがあったとして、その50GWは本当に同じ50GWなのか。
#答えは、おそらく違う。
#同じ1GWでも、
#最新のRubin級GPUを大量に載せ、
#HBMを十分に持ち、
#高速なScale-Up/Scale-Out Fabricがあり、
#Schedulerが最適化され、
#巨大Customer Baseを抱え、
#24時間近い高稼働率でCloudとして販売できる1GWと、
#旧世代GPUが分散して並び、
#Networkが弱く、
#GPUが断片化し、
#利用率も低く、
#外部へ販売するAPIやBillingすら十分でない1GWでは、
#生産できる「AI知能」の量が全く違う。
#これはNon-AI Data Centerでも昔から起きていた。
#Amazon AWSの100MWと、普通の企業が自社保有する100MWは同じではない。
#CPUもStorageも電気も存在する。
#しかしAWSはそのComputeを仮想化し、細かく切り分け、世界中の需要を集約し、EC2、S3、Database、Serverless、Security、Marketplaceへ変換して売る。
#一方、企業DCではServerが余っている時間が長くても、他社へ売ることはできない。
#つまり、
#電力容量と経済的Compute能力は別物である。
#AI時代には、この差がさらに大きくなる。
#今回は「GW」という単位をもう一段分解し、
#本当に使えるAI Factoryとは何なのか。
#そして、
#現在、世界には実質的に何GW分のAI Factoryが存在するのか。
#さらに、
#2030年には何GWまで増やせるのか。
#を考えてみる。
##
1.まず2030年219GWを正しく読む
#McKinseyの最新モデルでは、世界Data Center需要は、
#2025年:
#82.3GW
#から、
#2030年:
#219.0GW
#へ拡大すると予測されている。
#しかし219GW全部がAIではない。
#2030年の内訳は、
#となる。
#つまり2030年のAI部分は、
#155.5GW
#である。
#特にInferenceが20.9GWから93.3GWへ、年率約35%で拡大する。2030年にはInferenceだけで世界Data Center需要の40%以上を占める。(McKinsey & Company)
#2026年6月のMcKinseyの別分析では、現在側の目安としてTraining約31GW、Inference約31GWという水準が示されている。
#したがって2026年現在、世界ではおおむね、
#約55~62GW相当のAI workload
#が既に存在していると見ることができる。(McKinsey & Company)
#しかし、ここからが問題である。
#この60GWを、
#「60GWの高品質AI Factoryがある」
#と読んではいけない。
##
2.GWとは、そもそも「AI性能」ではない
#GWはPowerである。
#1GWとは10億W。
#つまり、
#「どれだけの電力を同時にIT設備へ流せるか」
#を示しているに過ぎない。
#例えば二つのData Centerがあるとする。
#A:
#1GW 最新GPU 高速HBM CPO/高速Optics 優秀なScheduler 高Utilization
#B:
#1GW 旧GPU 弱いNetwork 低いUtilization 分散したCluster
#両方とも帳簿上は、
#1GW
#である。
#しかしTokens/secは全く違う。
#Training Timeも違う。
#Cloudとして販売できるGPU-hourも違う。
#Revenueも違う。
#つまり今後必要になるのは、
#GWを「Computeの質」で補正する考え方
#である。
##
3.最初の標準指標――PUE
#Data Centerでは古くから、
#PUE
#Power Usage Effectiveness
#が使われる。
#式は、
#である。
#PUE 1.5なら、Data Centerへ150MW入れて、IT equipmentに100MW使っているイメージである。
#PUE 1.2なら120MWで100MWをITへ届けられる。
#当然後者が効率的である。
#しかしAI時代になると、PUEだけでは全く足りない。
#Uptime Institute自身も2026年、AI規模のInfrastructureでは、PUEは依然重要だが「確保した電力のうち、そもそも何%をITへ構造的に割り当てられるのか」を示していないと指摘している。(Uptime Institute Blog)
#そこで出てきたのが、
#PCE
#である。
##
4.PCE――確保した電力の何%がComputeになるのか
#Power and Compute Effectiveness。
#Airsysが提唱し、Uptime Instituteも紹介している新しい考え方である。
#概念的には、
#を見る。
#例えば1GWのUtility接続を確保したとしても、
#Redundancy、
#UPS、
#Cooling、
#Pump、
#Electrical distribution
#などを考えると、全1GWをServerへ使えるわけではない。
#PCEは、
#「1GW契約したが、そのうち何MWを継続的にITへ渡せるのか」#
を見る指標である。(Uptime Institute Blog)
#これはGWを見る上でかなり重要になる。
#しかしPCEでも、
#「そのIT Powerが何を計算しているか」
#までは分からない。
##
5.AIではAccelerator比率を見る必要がある
#Data CenterのIT Loadには、
#CPU、
#Storage、
#Networking、
#Memory、
#Accelerator
#がある。
#同じ500MWのIT Powerでも、
#GPU/XPUが100MWしかないData Centerと、
#400MWあるData Centerでは、
#AI能力が全く違う。
#そこで次に必要なのが、
#Accelerator Power Share
#である。
#概念的には、
#を見る。
#この段階で、
#「Data Center GW」
#から、
#「AI Compute GW」
#へ近づいていく。
##
6.それでもまだ足りない――GPU世代が違う
#さらに問題がある。
#100MWのH100。
#100MWのB200。
#100MWのRubin。
#同じ100MWでも性能は同じではない。
#MLCommonsによると、AI inferenceのperformance/Wは長期的に劇的に改善している。
#Trainingも同様で、同じ電力から得られるAI performanceは世代更新によって何十倍という単位で改善してきた。(MLCommons)
#つまり、
#2024年の1GWと2030年の1GWは別の「Compute量」
#である。
#ここで私は独自指標を導入したい。
##
7.独自指標①――QAC-GW
#Quality-Adjusted Compute GW
#日本語にすれば、
#「品質調整後Compute GW」
#である。
#私は概念的に、
#QAC-GW
#を、
#として考える。
#これは業界標準ではなく、本稿独自の分析指標である。
#例えば、
#1GWのAI IT Powerがあっても、
#旧世代Hardwareで0.6、
#Fabricが弱く0.8、
#Software efficiency 0.8、
#Utilization 60%
#なら、
#となる。
#帳簿上は1GWでも、
#実際の仕事量としては、
#0.23 QAC-GW相当
#しかない。
#逆に最新AI Factoryなら0.8以上まで持っていけるかもしれない。
##
8.推論では「Tokens/sec」だけでも不十分
#Inferenceでは一般に、
#Tokens/sec
#が使われる。
#しかしこれにも罠がある。
#巨大Batchを組み、Userを長時間待たせればSystem Throughputは上げられる。
#だから重要なのは、
#System TPS
#全体で何Token/sec生成できるか。
#TPS/User
#1User当たり何Token/sec出せるか。
#TTFT P95
#95%のUserが最初のTokenを受け取るまで何msか。
#Concurrency
#何Userを同時に処理できるか。
#である。
#MLPerf Endpointsは2026年から、まさにこの4項目を同時に比較するbenchmarkを提供している。(MLCommons)
#100万tokens/sec出せても、
#TTFTが30秒ならRealtime Chatとしての価値は低い。
#つまりInferenceでは、
#「SLAを守った状態で何Token出せるか」
#が重要になる。
##
9.独自指標②――Goodput/MW
#そこでInference用には、
#Goodput Tokens/sec/MW
#を見る。
#例えば、
#など一定SLAを満たしたRequestだけを数え、
#それをMWで割る。
#すると、
#単なるGPU台数
#ではなく、
#実際にUserへ提供できるInference量
#を比較できる。
#AIDCを見るなら、
#Tokens/sec/GW
#より、
#SLA-compliant Tokens/sec/GW
#の方がはるかに重要である。
##
10.Trainingでは全く違うComputeが必要になる
#TrainingではRealtime Responseは不要である。
#必要なのは、
#巨大Modelを、
#巨大Cluster全体で、
#できるだけ短時間に、
#目標品質まで学習させること。
#MLPerf Trainingが測っているのも、
#Target QualityまでのWall-clock Time
#である。(MLCommons)
#そこで重要になるのが、
#MFU
#Model FLOPs Utilization。
#理論Peak FLOPSのうち、
#実際にModel計算へ何%使えているかを見る。
#NVIDIAの定義でも、
#Achieved Compute ÷ Peak Hardware Capability
#である。(NVIDIA Docs)
#GPUが理論上100の性能を持っていても、
#Network待ち、
#Pipeline bubble、
#Memory stall、
#Synchronization、
#Checkpoint
#でMFU 40%なら、
#Modelは40しか利用していない。
##
11.Trainingでは「巨大な一枚岩」であることが価値になる
#1万GPUを持っていても、
#100ヶ所へ100GPUずつ分かれていたら、
#1万GPU Trainingはできない。
#したがってTrainingでは、
#Contiguous Cluster Size
#が非常に重要になる。
#同世代GPU。
#同一Fabric。
#高速Network。
#同時予約可能。
#これが必要である。
#だから、
#1GWのTraining-ready Capacity
#と、
#1GWの一般Inference Capacity
#は完全な代替物ではない。
#McKinseyもTrainingを巨大高密度Campus型、Inferenceを低Latency・Metro/near-Metro型へ分化すると見ている。(McKinsey & Company)
##
12.Non-AI Computeも同じ問題を昔から抱えていた
#これはAIだけの特殊現象ではない。
#Synergy Researchによれば、2025年末時点で世界Data Center Capacityの、
#Hyperscale:
#48%
#Non-hyperscale Colocation:
#20%
#Enterprise On-premise:
#32%
#となった。
#2018年にはOn-premiseが56%を占めていた。
#さらに2031年にはHyperscaleが、
#67%
#まで増える見通しである。(Synergy Research Group)
#なぜこうなったのか。
#AWSやGoogle Cloudの方が同じServerを有効活用できるからである。
#Demand aggregation。
#Virtualization。
#Autoscaling。
#Spot pricing。
#Serverless。
#Storage pooling。
#Global scheduling。
#これによって、
#1台のServerから得られる経済価値が高い。
#AIでも同じ集約が起きている。
##
13.独自指標③――CS-GW
#次に必要なのが、
#Cloud-Sellable GW
#略して、
#CS-GW
#である。
#QAC-GWが、
#「実際に仕事として使えるCompute量」
#を表すのに対し、
#CS-GWは、
#「外部CustomerがCloudとして実際に購入できるCompute」
#を表す。
#例えばMetaが1GWの超高性能AI Factoryを持っていても、すべてMeta社内で使っているなら、
#Global Useful Computeとしては1GW。
#しかしPublic Cloud市場におけるCS-GWは0である。
#逆にAWS、Azure、GCP、OCI、CoreWeaveなら外部へ販売できる。
#これは非常に大きな違いである。
##
14.Cloudとして使えるにはHardwareだけでは足りない
#Cloudには、
#Scheduler、
#Virtualization、
#Isolation、
#Container、
#Storage、
#Security、
#Networking、
#Identity、
#API、
#Billing、
#Monitoring、
#Regional routing、
#Failure recovery
#が必要になる。
#つまり、
#GPUが並んでいるだけでは、
#Cloudではない。
#Oracleでは2026年度に1.2GW超をCustomerへDeliveryし、Global GPU Utilizationは97.5%に達したと説明している。(Oracle Blogs)
#これはHardwareを持つこと以上に、
#需要を集約して空きを次のCustomerへ即座に売る能力
#が重要であることを示している。
##
15.独自指標④――Economic Compute GW
#さらに一段進める。
#最終的に企業に必要なのは、
#Computeそのものではない。
#Computeから利益を生むこと
#である。
#そこで、
#Economic Compute GW
#を考える。
#例えば、
#Economic Output/GW
#を、
#とする。
#さらに、
#NOPAT/GW
#FCF/GW
#を見れば、
#1GWの電力をどれだけEconomic Valueへ変換しているか分かる。
##
16.同じ1GWでもAWSと普通のDCでは別物になる
#普通のColocationでは、
#電力、
#Rack、
#Cooling、
#Space
#を提供してCustomerから料金を取る。
#しかしAWSは、
#電力
#↓
#Server
#↓
#Virtualized Compute
#↓
#Database
#↓
#Storage
#↓
#Bedrock
#↓
#Security
#↓
#Marketplace
#までValue Chainを伸ばす。
#Amazonの2026Q2 AWS Operating Incomeは166億ドルに達している。(SEC)
#Google Cloudも同四半期、
#Revenue 247.7億ドル、
#Operating Income 88.1億ドル、
#Revenue growth 82%
#に達した。
#Gemini APIは1分間に220億Tokenを処理するところまで成長している。
#つまりBig Cloud企業は、
#「Computeを売る会社」ではなく、
#「電気をSoftware Revenueへ変換する精製所」
#になっている。
##
17.現在世界に「本当に使えるAIFactory」は何GWあるのか
#では本題に入る。
#2026年現在のAI workloadは、おおむね55~62GW相当と推定できる。
#しかし私はこれをそのままAI Factory能力とは見ない。
#本稿では便宜上、現在のAI IT capacityを三層に分ける。
#これは公式市場統計ではなく、McKinseyのAI workload規模、SynergyのHyperscale構成比、現在の主要AI operatorのInfrastructure状況から組んだ本稿独自モデルである。
#これを合計すると、
#現在の実効的AI Factory能力
#約35~45 QAC-GW
#中央値なら、
#約40 QAC-GW
#程度ではないかと考える。
##
18.しかしFrontier-gradeとなるとさらに減る
#40GWすべてで巨大Frontier Modelを学習できるわけではない。
#Frontier Trainingには、
#最新GPU/XPU、
#巨大HBM、
#高速Scale-Up、
#高速Scale-Out、
#巨大Contiguous Cluster
#が必要になる。
#そこでさらに絞れば、
#Frontier-grade QAC
#は、
#約20~30GW相当
#程度ではないかと推定する。
#さらに外部企業が自由に購入できるPublic Cloudまで限定すると、
#約12~20GW
#程度。
#最新世代Accelerator+巨大連続Clusterという条件まで付ければ、
#約8~15GW
#くらいまで小さくなる可能性がある。
#つまり、
#「世界に60GWのAI Computeがある」
#という数字と、
#「企業が今すぐ借りられるFrontier-grade Compute」
#には数倍の差がある。
##
19.これはMemoryと全く同じ構造である
#Memory全体を見ればDRAMは大量にある。
#しかしAIが欲しいのは、
#HBM4。
#HBM4E。
#Custom HBM。
#である。
#だから、
#DRAM全体では供給があるのにHBMだけ不足する。
#AIDCでも同じことが起こる可能性が高い。
#Powerはある。
#DCもある。
#GPUもある。
#しかし、
#最新Accelerator、
#HBM、
#高速Fabric、
#低Latency地域、
#Cloud-ready Scheduler
#を全部満たした、
#「高級AIDC」
#だけが足りない。
##
20.AIDCにも品質階層が生まれる
#私は今後AIDCをこのように見る。
#重要なのは、
#S級が古くなってもゼロ価値にはならない
#ことである。
##
21.古いAIDCは「下の市場」へ流れていく
#現在Frontier TrainingをしているGB300/B200級Clusterも、数年後には最先端ではなくなる。
#しかしCompute能力が消えるわけではない。
#McKinseyも、旧Hardwareは細分化された同時workloadなどへ再利用できると指摘している。(McKinsey & Company)
#つまり、
#Frontier Training
#↓
#Large-model Fine-tuning
#↓
#Batch Inference
#↓
#Small-model Training
#↓
#Academic Research
#↓
#Startup
#↓
#個人AI
#という二次流通が起こり得る。
#これはGPU版中古車市場のようなものになる。
##
22.「AIDCが余る」とは、無価値になることではない
#ここは非常に重要である。
#例えば2029年にRubin世代が大量に余ったとする。
#価格は下がる。
#Rental Priceも下がる。
#しかしその結果、
#大学研究室。
#Small AI Lab。
#個人Developer。
#ゲームAI。
#Scientific Computing。
#地域Cloud。
#など、これまで高すぎて利用できなかったCustomerへ降りてくる。
#つまり、
#AI ComputeのDemocratization
#が起こる。
#これはMemoryが安くなると、
#16GB→32GB、
#1TB→2TB
#へ搭載量が増えるのと同じである。
##
23.ただし「Cloud化されていること」が条件になる
#旧AIDCの価値を残す最大条件は、
#Cloudability
#である。
#1万枚の旧GPUを持っていても、
#自社内部専用Network。
#独自Scheduler。
#外部接続なし。
#Billingなし。
#Security isolationなし。
#なら、個人や研究者へ簡単には貸せない。
#一方AWS、GCP、Azure、OCI、CoreWeaveのようなCloudに載っていれば、
#最新GPU instance:
#高価格
#旧GPU instance:
#安価格
#として同じCustomerへ販売できる。
#つまり、
#Cloud SoftwareそのものがHardware残存価値を高める。
##
24.これこそCloud競争で昔から起きてきたこと
#Non-AI Data Centerでも同じだった。
#Enterprise Serverは、使われなくなれば遊休資産になった。
#Cloud Serverは、別のCustomerへ売れる。
#だから資本はHyperscalerへ集中した。
#SynergyによればHyperscaleの世界Capacity shareは2025年末48%。
#2031年には67%へ上昇する予想である。(Synergy Research Group)
#AIでも同じ方向へ進む可能性が高い。
#ただしAIでは、
#GPU世代、
#HBM、
#Fabric
#による品質差がさらに大きいため、
#この競争はもっと激しくなる。
##
25.2030年にはPhysical AI Capacityは155GWへ
#McKinseyモデルでは2030年のAI需要は、
#Training:
#62.2GW
#Inference:
#93.3GW
#合計:
#155.5GW
#になる。(McKinsey & Company)
#現在の55~62GWから考えると、
#約2.5倍。
#しかし2025→2031にはHyperscale share自体も48%→67%へ増える予測である。
#つまり単にGWが増えるだけでなく、
#平均的な「1GWの質」も改善する
#可能性が高い。
##
26.2030年のQAC-GWを推定する
#現在の物理AI GWからUseful QAC-GWへの変換率を、
#おおむね、
#60~70%
#程度と本稿では置いた。
#2030年には、
#AI専用設計、
#Liquid Cooling、
#800VDC、
#高速Optics、
#better Scheduling、
#Cloud consolidation
#によって、
#70~80%
#程度まで改善できると仮定する。
#すると、
#80%なら、
#124GW。
#つまり2030年には、
#約110~125 QAC-GW
#程度の「有用AI Factory」を作れる可能性がある。
#これはもちろん本稿独自モデルである。
##
27.しかしDemandはQACの改善以上に増える可能性がある
#ここでToken問題が入ってくる。
#現在、1人当たりの正確なToken Consumption/dayは公開されていない。
#しかしOpenAIのEnterprise Signalsでは、2026年6月時点でCodexが企業顧客のCodex+ChatGPT Output Tokenの64%を占める。
#AI利用上位10%企業のTokens/Userは一般企業の、
#8.3倍
#まで開いている。(OpenAI)
#OpenAI社内でも、
#Research:
#56倍
#Customer Support:
#32倍
#Engineering:
#27倍
#Legal:
#13倍
#へMedian Output Tokensが約7か月で増えた。(OpenAI)
#つまり、
#UsersだけではなくTokens/Userが増えている。
##
28.Claude Codeでも同じ現象が確認できる
#Anthropicによる約23.5万人、40万Sessionの分析では、Claude Code Userは平均、
#週20時間
#利用している。
#しかもDebug中心から、Deployment、Data Analysis、Document generationなど、よりEnd-to-EndなAgentic Workへ利用が拡大している。(Anthropic)
#人間の質問回数がAI需要を決める時代から、
#AI Agentが何時間働いているか
#へ変わり始めている。
##
29.10億人がAgentを使った場合
#ここからは予測ではなく、規模感を見るScenarioである。
#仮にPrimary AI AgentのToken Activityに対して、
#他AI Service:
#2.5倍
#Compute-equivalent率:
#10%
#Rubin基準:
#約1.5M compute-equivalent tokens/s/MW
#Feynman:
#Rubin比2倍効率
#と置く。
#すると、
#ここでの10Mは「全AI Service合計」ではなくPrimary Agent使用量とし、他Serviceを2.5倍補正している。
#この前提そのものには大きな不確実性がある。
#しかし桁を見るには役立つ。
##
30.3B人×10MならFeynmanでも約29GW
#2030年代にAI利用人口が30億人まで広がり、
#平均Primary Agent Activityが1000万Token/dayまで行けば、
#FeynmanをRubinの2倍効率としても、
#約29GW
#の平均IT Loadになる。
#これだけなら155GWのAI容量で十分に見える。
#しかしこれは、
#Human-facing Agent系だけ
#である。
##
31.そこへTrainingが62GW加わる
#McKinseyは2030年にTrainingだけで、
#62.2GW
#を予測している。(McKinsey & Company)
#Training効率は当然改善する。
#しかしFrontier Modelが増え、
#企業独自Model、
#国家Model、
#Scientific Model、
#Physical AI Model
#まで増える。
#だからEfficiency向上にもかかわらずTraining需要自体が伸びる予測になっている。
##
32.企業利用は「人口」で上限が決まらない
#さらに企業Agentがある。
#人間1人に、
#Sales Agent。
#Coding Agent。
#Legal Agent。
#Research Agent。
#Security Agent。
#Customer Support Agent。
#が付く。
#そしてAgent同士が会話する。
#OpenAIでは既にAgentic AIが企業Output Tokensの64%を占め、LegalやSalesでCodex userが急増している。(OpenAI)
#つまり将来は、
#Human Users
#より、
#Software Workers
#の数の方が重要になる可能性がある。
##
33.研究用途も24時間動く
#Research AIはChatと性質が違う。
#Paper search。
#Simulation。
#Code execution。
#Hypothesis generation。
#Verification。
#Agentが止まる理由がない。
#OpenAI内部でResearchのMedian Codex Outputが56倍になったのは象徴的である。(OpenAI)
#Scientific AIは、
#Drug discovery、
#Material science、
#Semiconductor、
#Fusion、
#Weather、
#Physics
#へ広がる。
#人間が寝ている間もComputeは動く。
##
34.Physical AIはToken表の外からやってくる
#さらに問題なのがPhysical AIである。
#RobotのEdge Inferenceを全部AIDCで処理するわけではない。
#しかしRobot開発には、
#3つのComputer
#が必要になる。
#NVIDIAは、
#Training Computer
#Simulation Computer
#Edge Deployment Computer
#というThree-Computer Architectureを示している。(NVIDIA)
#Robotを一台作るだけでも、
#Cloud Training。
#Simulation。
#Synthetic Data。
#Policy Evaluation。
#が必要になる。
##
35.Simulationが巨大なAIDC需要を作る
#Physical AIでは現実世界だけで十分なTraining Dataを集めることが難しい。
#そのためSimulation内で、
#Millions of scenarios
#を回す。
#NVIDIAはIsaac Sim/Cosmosなどを使い、数百万ScenarioでRobotをTraining・Validationする構造を示している。(NVIDIA)
#Cosmos 3もTextだけではなく、
#Vision、
#Video、
#Sound、
#Action
#まで統合したWorld Foundation Modelへ進んでいる。(NVIDIA Newsroom)
#これは普通のText TokenとはCompute densityが違う。
#つまり今回のToken表に、
#Physical AI Simulationはほぼ含まれていない。
##
36.Physical AIの兆候はすでに出ている
#2026年前半だけで、中国では4万台超のHumanoidが出荷されたとの推計があり、中国勢が世界出荷の大部分を占めている。
#業界では2027~28年前後にRobotの「ChatGPT Moment」が来る可能性を語る企業も出ている。(Reuters)
#まだAIDC需要の中心ではない。
#しかし2030年需要を考えるとき、
#無視できない追加曲線
#になる。
##
37.では2030年に何が不足するのか
#私は「AIDC全部が不足する」とは考えない。
#むしろ、
#高級Computeから不足する
#可能性が高い。
#第一に、
#Frontier Training-ready GW
#巨大Contiguous Cluster。
#最新GPU。
#HBM。
#高速Scale-Up。
#高速Scale-Out。
#ここは最も供給が難しい。
#第二に、
#Premium Inference GW
#最新Inference Hardware。
#低Latency。
#巨大KV Cache。
#高速Memory。
#Metro connectivity。
#ここもAgentic AIで需要が急増する。
#第三に、
#Public Cloud Sellable GW
#Hardwareだけでなく、
#Cloud Software、
#Scheduler、
#Security、
#Billing、
#Customer Base
#が必要。
#これも簡単には作れない。
##
38.一方、古いAIDCは余る可能性がある
#例えば2029年に、
#H100。
#B200。
#GB200。
#が最上級ではなくなる。
#このClassではPrice Warが起きる可能性がある。
#しかし、
#余る = 捨てる
#ではない。
#価格が下がり、
#Student。
#Researcher。
#Startup。
#Individual Developer。
#Small Enterprise。
#へ降りる。
#現在、GPU時間が高すぎて実験できない研究も、旧世代AIDCが安価なCloudとして提供されれば可能になる。
#これはむしろAI Innovationを加速する可能性がある。
##
39.つまりAIDC市場はMemory市場に似てくる
#Memoryでも、
#HBM4E:
#超高価・不足。
#DDR5:
#一般用途。
#DDR4:
#安価な用途。
#NAND:
#さらに大容量低価格。
#と階層化する。
#AIDCも、
#Frontier AI Factory:
#超高価・不足。
#Mainstream AI Cloud:
#十分高価。
#Legacy AI Cloud:
#安価。
#Conventional DC:
#Non-AI。
#という階層になる。
#そしてPremium Tierが下へ降りるたびに、
#新しい需要が開拓される。
##
40.だから「AIDCが余るか」は一つのYes/Noでは答えられない
#例えば世界全体で150GWあっても、
#Frontier Trainingは不足。
#Realtime Inferenceも不足。
#旧GPU Batch Computeは余剰。
#Enterprise on-premiseは低Utilization。
#という状態が同時に起きる。
#つまり、
#Aggregate GW Surplus
#と、
#Premium Compute Shortage
#は両立する。
#これはHBM不足とDRAM市場が同時に存在するのと同じである。
##
41.2030年に最も重要になる指標
#今後私はAIDCを見るなら、
#単純なGWの横に最低でも、
#を置いた方がよいと思う。
##
42.最終的には「GW」ではなくこの式になる
#AIDCの実力は、
#である。
#さらにCloudとしての価値なら、
#を加える。
#経済価値なら、
#まで必要になる。
#つまり最後には、
#AI Factory Value
#は、
#MW × Useful Compute/MW × Utilization × Monetization
#へ収束する。
##
43.ここでAWS型と普通のDCの差が出る
#Amazon、Google、Microsoftの強さは、
#電力をたくさん持っていることだけではない。
#最後まで変換できること
#である。
#Power
#↓
#Compute
#↓
#Virtualized Compute
#↓
#Cloud Product
#↓
#Customer Workload
#↓
#Recurring Revenue
#↓
#Cash Flow
#まで持っていける。
#一方、普通のData Centerは、
#Power
#↓
#Server
#の段階で止まる。
#だから同じ1GWでもEconomic Outputが何倍も違う。
#これはNon-AI Cloudで20年かけて証明されてきた。
#そしてAI Cloudでも同じ競争が始まっている。
##
44.Oracleは「Utilization」でこの世界を象徴している
#OracleはFY2026だけで1.2GW超をCustomerへDeliveryした。
#さらにGPU utilizationは97.5%。
#加えて大型AI契約ではCustomerがGPU代を前払いしたり、GPUそのものをOracleへ供給する契約が合計750億ドル規模まで拡大している。(Oracle Blogs)
#これは、
#GWを増やす
#だけでなく、
#1GWをどれだけ高回転で使うか
#が競争になることを示している。
##
45.xAIも1.4GWを既に商品化し始めた
#SpaceX/xAIの2026Q2では、
#Nameplate Compute:
#1.4GW。
#AI Solutions & Infrastructure Revenue:
#22億ドル/Quarter。
#AI revenue全体:
#25.6億ドル/Quarter。
#まで増えた。(Q4cdn)
#単純年率換算なら、1GW当たりのAI Solutions売上は約63億ドル相当になる。
#まだOperating Lossは大きい。
#しかし、
#「1GWを売上に変える能力」
#そのものは既にかなり高い。
##
46.だからAIDC競争は「電力確保競争」だけではない
#第一段階:
#土地を確保する。
#第二段階:
#電力を確保する。
#第三段階:
#GPUを置く。
#しかし本当の競争はその後である。
#第四段階:
#Computeを効率的に動かす。
#第五段階:
#Customerを埋める。
#第六段階:
#高margin Softwareをattachする。
#第七段階:
#旧世代Computeも安価に再販売する。
#ここまでできるOperatorが、
#長期的に勝つAI Factory Operator
#になる。
##
47.AIDCは「発電所」より「製油所」に近い
#私はAI Factoryを発電所だけで例えるのは少し違うと思う。
#むしろ、
#Refinery
#に近い。
#Input:
#Electricity。
#Intermediate Product:
#Compute。
#Final Product:
#Tokens。
#さらに、
#Code。
#Research。
#Ads。
#Search。
#Software。
#Robot Intelligence。
#へ加工する。
#高性能なRefineryほど、
#同じ原油から高価値製品を多く作れる。
#AIDCも同じである。
##
48.2030年に155GW作れても安心ではない
#155GWのAI Physical Capacityが出来たとする。
#しかしUseful conversionが70%なら、
#約109GW。
#80%でも124GW。
#そこからFrontier-quality。
#Cloud sellable。
#Low-latency regional capacity。
#を考えるとさらに減る。
#一方で、
#Inferenceだけで93.3GW。
#Training 62.2GW。
#さらにAgentic AI。
#Research。
#Enterprise AI。
#Physical AI。
#が乗る。
#すると、
#「155GW建つから余る」
#とは到底言えない。
##
49.逆に、全部が不足するとも限らない
#重要なのはここである。
#2028~30年には旧世代AI Computeが大量に生まれる。
#そこではPrice Competitionが起こる可能性がある。
#したがって、
#Premium AI Computeは不足。
#Commodity AI Computeは安くなる。
#という世界があり得る。
#これはMemoryと非常によく似ている。
##
50.そして安くなったComputeがまた需要を増やす
#旧GPU Cloudが1/5の値段になれば、
#これまで100万円かかったExperimentが20万円になる。
#University。
#Startup。
#Individual。
#が利用できる。
#Fine-tuningが増える。
#Synthetic Data生成が増える。
#Researchが増える。
#そうすると旧世代Computeまでまた埋まり始める。
#つまり、
#ComputeにもJevons Effectがある。
##
51.AIDCは簡単には「ゴミ」にならない
#GPUは陳腐化する。
#しかしData Centerには、
#Grid Connection。
#Substation。
#Cooling。
#Fiber。
#Powered Land。
#が残る。
#前回の記事で最も希少だと考えた、
#「2030年までに通電できる1MW」
#そのものは残る。
#Hardwareを入れ替えれば新しい用途へ使える。
#だからAI Factoryの残存価値は、
#GPUの中古価格だけでは測れない。
##
52.これが「Finance Bubble」への緩衝材にもなる
#もちろん投資しすぎれば危険である。
#旧GPU価格下落。
#Rental price低下。
#Debt burden。
#Credit spread拡大。
#は起こり得る。
#しかしData CenterそのものにPowered Landとして価値があれば、
#別GPUへ換装。
#Inferenceへ転用。
#Research Cloudへ転用。
#Non-AI HPCへ転用。
#できる。
#したがって、
#GPU世代交代 = AIDC価値ゼロ
#ではない。
##
53.むしろ「Cloud化出来ないAIDC」の方が危険
#本当に危ないのは、
#専用Customer向けに作ったが、
#そのCustomerが消え、
#Hardwareも旧式。
#Networkも特殊。
#外部Customerへ売るSoftwareもない。
#というAIDCである。
#つまり今後Residual Valueを決めるのは、
#Powered Land
#だけでなく、
#Cloudability
#でもある。
##
54.今後最も価値が高いAI Factoryとは何か
#私は、
#最新GPUがあるFactory
#だけでは不十分だと思う。
#強いAI Factoryは、
#Power。
#Cooling。
#HBM。
#Fabric。
#Scheduler。
#Cloud software。
#Customer demand。
#Capital。
#を全部持つ。
#これらを合わせて初めて、
#1GWが「知能生産能力」になる。
##
55.結論――AIDCは「GW」から「知能生産能力」で測る時代へ
#これまでData Center市場は、
#MW。
#GW。
#Rack数。
#Server数。
#で語られてきた。
#それは間違いではない。
#しかしAI Factoryでは、
#それだけでは本質を捉えられなくなっている。
#同じ1GWでも、
#どのHardwareか。
#どのMemoryか。
#どのFabricか。
#どのSoftwareか。
#何%稼働しているか。
#Trainingに使えるか。
#Realtime Inferenceに使えるか。
#Cloudとして販売できるか。
#そして最終的に、
#何Tokenを、何ドルへ変換できるか。
#で価値が変わる。
##
56.だから「AIDCは余るのか」という問いを変える必要がある
#本当の問いは、
#「どのClassのAIDCが余るのか」
#である。
#旧世代Batch Computeは余るかもしれない。
#Enterprise GPUは低Utilizationかもしれない。
#しかしFrontier Training Clusterは不足するかもしれない。
#低Latency Agentic Inferenceも不足するかもしれない。
#Public Cloudとして販売できるRubin級Computeも不足するかもしれない。
#世界全体ではGWが余っているのに、
#欲しいComputeだけない。
#という状態は十分あり得る。
#Memory市場で、
#DRAMはあるのに、
#HBMだけない。
#という状態と全く同じである。
##
57.そして高級Computeが量産されれば、市場は下へ広がる
#Frontier Computeが次世代へ移れば、
#昨日の高級品が今日の普及品になる。
#普及品が安くなれば、
#Research。
#Startup。
#Student。
#Personal AI。
#へ降りる。
#その需要によって旧世代Data Centerも使われ続ける。
#だから、
#AI Compute Supplyが増えることはDemandの終わりではない。
#むしろ、
#Intelligenceの価格が下がり、新しい市場が開くこと
#を意味する可能性がある。
##
58.世界は既にこの方向へ動いている
#OpenAIではAgentic useがChatを上回り始めた。
#Frontier企業のTokens/Userは一般企業の8倍を超えた。
#Claude Code Userは週20時間Agentを動かしている。
#Physical AIはTraining・Simulation・Edgeという三つのComputeを必要とする。
#一方、Data Center側ではHyperscalerへの集約が進み、世界Capacityの半分近くを占めるまでになった。
#つまり、
#Computeを持つだけでは勝てない。
#Computeを使い切り、売り切る能力が必要になる。
#その競争はAI以前からCloud市場で20年続いてきた。
#AWSが勝った理由。
#Google Cloudが追い上げた理由。
#AzureがEnterpriseに強い理由。
#それと同じ競争が、
#今度は、
#数十GW、数百GWのAI Factoryで起き始めている。
##
59.2030年の本当のKPI
#2030年に見るべき数字は、
#「世界に200GWのDCがある」
#ではない。
#「AIで155GW使っている」
#だけでもない。
#見るべきなのは、
#何GWがAI-readyなのか。
#何GWがFrontier-readyなのか。
#何GWがCloud-sellableなのか。
#1GWから何Token/secを作れるのか。
#そのTokenを何ドルへ変えられるのか。
#である。
#そして私はこのために、
#QAC-GW
#Quality-Adjusted Compute GW
#CS-GW
#Cloud-Sellable GW
#Goodput/MW
#Revenue/GW
#NOPAT/GW
#FCF/GW
#を見るべきだと思う。
##
60.AIDCの本当のScarcityは「電力」よりさらに狭い
#前回の記事で、
#資金は物理供給より先に到着した。#
と書いた。
#そして希少になるのは、
#「2030年までに通電できる1MW」#
だと考えた。
#今回さらに先へ進めるなら、
#本当に希少なのは、
#「2030年までに通電され、最新AIを高効率で動かし、Cloudとして売ることができる1MW」
#なのだと思う。
#ただ電気が来ているだけではない。
#GPUがあるだけでもない。
#HBMがあるだけでもない。
#そこから、
#実用Computeを作り、
#Customerへ届け、
#Revenueへ変える。
#その能力まで含めた1MW。
#それこそが、
#AI Factory時代の本当の生産能力なのかもしれない。
#そしてこの尺度で世界を見ると、
#「AIDCを作りすぎて余る」という従来の問いは少し違って見える。
#確かに一部のComputeは余るだろう。
#古いComputeは安くなる。
#しかし安くなったComputeは次の市場へ流れる。
#一方、最も高品質なComputeは、Agent、Research、Training、企業AI、Physical AIによって再び不足する。
#そうしてAI Infrastructureは、
#高級Compute不足
#↓
増産
↓
旧世代価格低下
↓
新規需要創出
↓
さらに高級Compute不足という階段を上り続ける可能性がある。
#これは単なるData Center建設Boomではない。
#電力そのものを、より高密度な「知能」へ変換していく産業競争
#なのである。
#特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#