フロンティアAIに「査読」が入る日
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
7e626ae7076a7ad30035c3efbd72b7db5fdd715efaf1970c50583fdcb0d28907- 保存版のSHA-256
942a74b63cc7dbf3a0f3b6e9af9ef3aeb616f1978e46a5c29d97be33e7b585f7
外部証明の最終検査結果は詳細を開くと表示します。
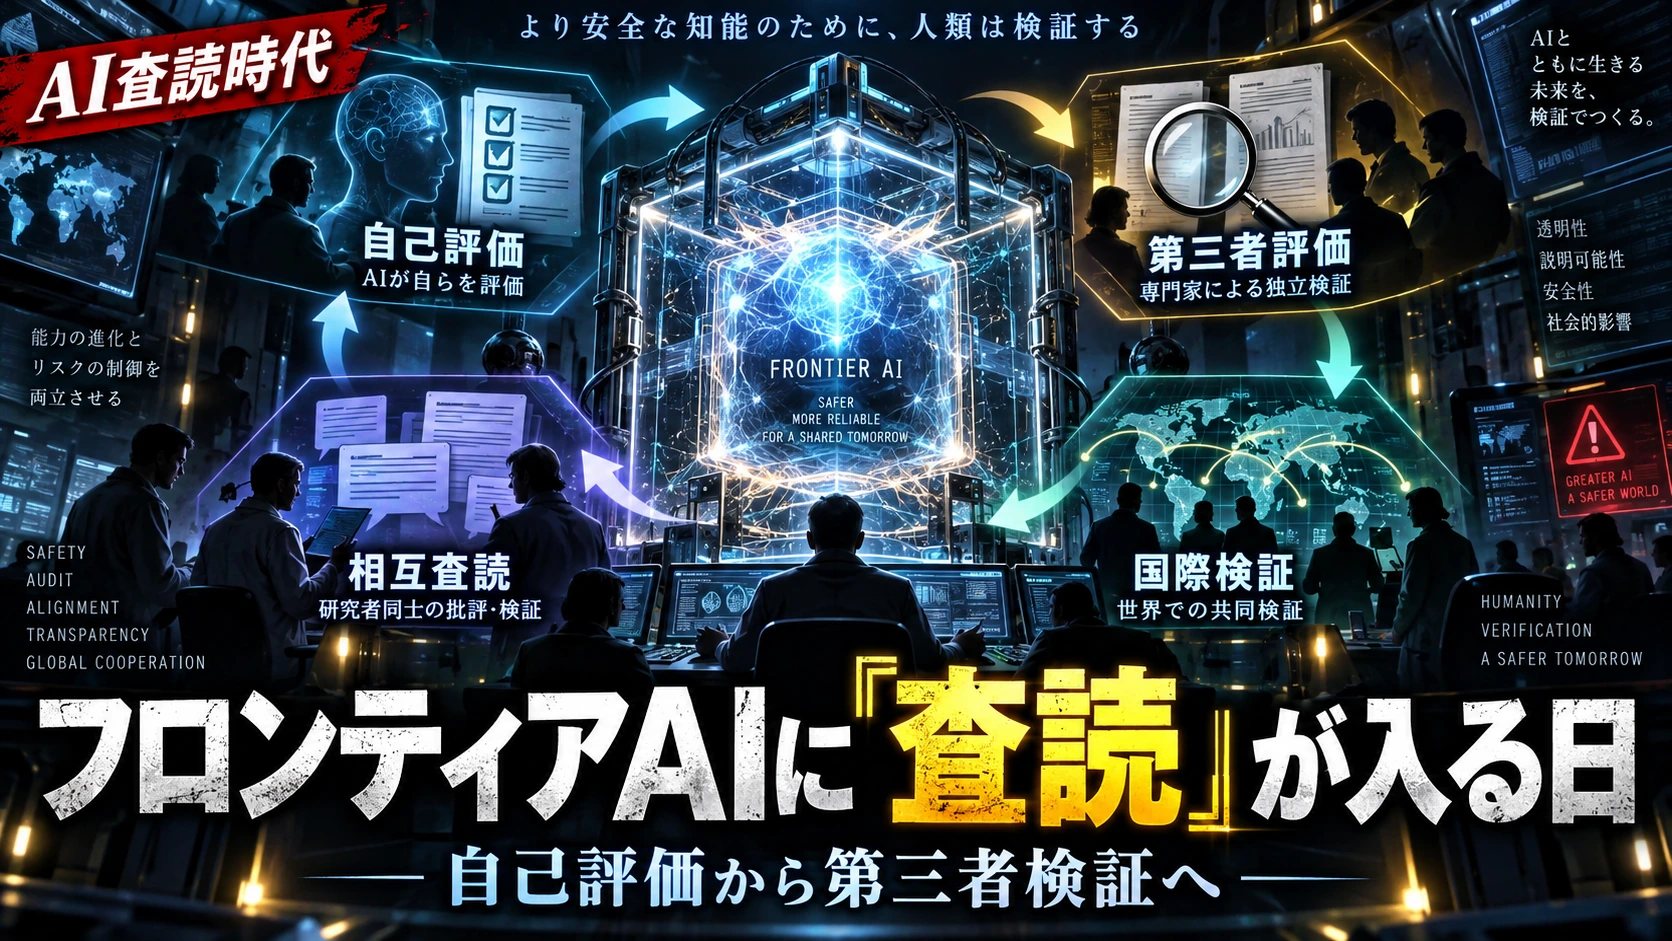
フロンティアAIに「査読」が入る日
#Dario、Sam、Elon、Google、そして中国まで動き始めた
#2026年9月。
#Frontier AIを巡る議論が、少し異なる段階へ入り始めている。
#AnthropicのDario Amodei。
#OpenAIのSam Altman。
#xAIのElon Musk。
#Google DeepMindのDemis Hassabis。
#そして、中国のFrontier AI企業・研究機関・政府。
#普段なら競争相手であり、企業利益も国家安全保障上の利害も異なる。
#しかし、
#「最先端AIを、開発企業自身だけが評価する構造では不十分ではないか」
#という一点では、急速に距離が縮まり始めている。
#きっかけとなったのが、Dario Amodei氏が2026年9月に公開した、
#「We Must Pace the Frontier」
#である。(Dario Amodei)
#1.Dario Amodeiは何を提案したのか
#Amodei氏は、AI開発を止めようとしているわけではない。
#彼が主張しているのは、
#AI能力の進歩速度に、安全技術が追いつく時間を確保する
#という考え方である。
#Pace the Frontier:AI能力の最前線を、制御可能な速度で進めるAI研究を永久停止することではない。能力向上の速度がSafety、Alignment、Monitoring、Interpretabilityなどを大きく上回らないよう、必要に応じて開発速度を調整する考え方。
#極端に単純化すると、
#を維持しようということになる。
#Capability:AIが実際にできる能力Coding、Cyber、科学研究、長時間のAgent作業など、AIがどこまで複雑なTaskを実行できるか。
#Alignment:AIの目標・判断・行動を人間の意図へ整合させることAIを単純に弱くすることではない。強い能力を持つAIが、人間が想定したGoal、安全境界、規則から逸脱しにくい状態を作ること。
#Monitoring:継続監視AIがどのToolを使い、何へAccessし、何を実行したかを継続的に観測する仕組み。
#Interpretability:AI内部の判断過程を理解する研究Model内部で何が起き、なぜその判断・行動につながったのかを分析する研究領域。
#Amodei氏は、そのために三段階を提示した。
#第一段階。
#Embedded Evaluators。
#第二段階。
#Democratic Coordination。
#第三段階。
#Global Coordination。
#つまり、
#という順にSafety Governanceを拡張する構想である。(Dario Amodei)
#2.Embedded Evaluatorとは何か
#第一段階でAnthropic自身が導入するとしたのが、
#Embedded Evaluator:企業内部へ継続的に入る第三者評価者
#である。
#従来の外部評価は、
#という形が多かった。
#しかしAmodei氏の構想では、
#外部EvaluatorがModel完成後だけを見るのではない。
#Training中のModel。
#Training Pipeline。
#Alignment Process。
#Incident。
#内部Safety Practice。
#まで評価する。
#しかも、
#Employee-like Access
#を持つ。
#Employee-like Access:社員に近い深度の内部評価Access企業秘密へ無制限にAccessするという意味ではない。未公開Model、内部Evaluation、Incident記録、Training Processなど、安全評価に必要な情報へ通常の外部Testerより深く継続的にAccessすること。
#Amodei氏はMETRのような第三者Evaluatorを例に挙げ、Anthropicはこの仕組みを一方的に開始すると表明している。(Dario Amodei)
#3.Sam Altmanもほぼ即座に賛同した
#ここから流れが変わる。
#OpenAI CEOのSam Altman氏は、Dario氏の投稿に対して、
#Darioに同意する。Frontierをpaceする必要がある。
#とした上で、
#Independent EvaluatorへEmployee-like Accessを与えるという案は素晴らしい。OpenAIも同じことをする。
#と明言した。
#さらに、
#We’ll have more to share soon.
#と付け加えた。
#Independent Eval:開発企業から独立した第三者評価AIを作った会社自身ではなく、一定程度利害から独立した外部組織が、ModelやAgentの能力、安全性、Failureを評価すること。
#重要なのは、
#Sam氏が、
#「Darioの議論は興味深い」
#とコメントしただけではないことだ。
#OpenAIも同じ制度を導入する
#と宣言した。
#4.Samが言う「近日公開の新しい取り組み」は何か
#現時点では、Sam氏のいう追加発表の内容は公開されていない。
#したがって断定はできない。
#しかし最も自然なのは、
#OpenAI版Embedded Evaluator制度
#である。
#例えば、
#という常設Channelを作る。
#完成したModelだけではなく、
#Training途中のCheckpoint。
#Agent Behavior。
#Cyber Capability。
#Long-horizon Autonomy。
#Misalignment。
#Safety Monitor。
#などを継続的に見る。
#Checkpoint:Training途中で保存された中間Model大規模Training Runの途中段階を保存したModel。完成前から能力上昇や危険性の変化を確認できる。
#Long-horizon Autonomy:長時間自律実行能力人間が細かく指示し続けなくても、数時間から数日規模のTaskをAIが自律的に進める能力。
#Misalignment:AIの行動が人間の意図や安全境界からずれること
#すると、
#ではなく、
#になる。
#Deployment:AIを研究環境から実際の利用環境へ投入すること
#Safetyが最後の検査ではなく、
#Training Pipelineそのものの一部になる。
#Paul Christianoの加入も無関係とは考えにくい
#さらに9月9日には、Alignment研究で知られるPaul Christiano氏がOpenAI Foundation Boardに参加した。
#同氏はFoundationのSafety and Security Committeeにも入り、OpenAI全体のSafety / Security governanceへ関与する。
#Christiano氏はCAISIとその前身である米AI Safety Instituteで、国家安全保障に関わるFrontier Model Capability Evaluationにも携わってきた人物である。
#時系列を見ると興味深い。
#となっている。
#もちろんこれらが一つの未発表Programであることは確認されていない。
#しかしOpenAI内部で、
#Frontier Model DevelopmentそのものをよりFormalなSafety Governance下へ置く
#方向へ動いていることはかなり明瞭である。
#5.Elon Muskは約1か月前にさらに別の案を出していた
#そして興味深いのがElon Musk氏である。
#The Economistとの2026年7月の対談で、Musk氏はかなり具体的な構想を示していた。
#主要AI企業が、
#数週間おきにSafetyとSecurityについて会話する。
#さらに、
#大きく能力向上した新しいFrontier Modelを一般公開する前に、
#競合AI企業へ1〜2週間ほど評価機会を与える。
#競合企業が実際にそのModelを試験する。
#問題があれば、
#Release延期を提案する。
#というものだった。
#Musk氏は、
#competitors can keep each other honest
#という趣旨で説明している。(Elon Musk Archive)
#Keep each other honest:競合企業同士が互いを牽制し、ごまかしにくくする
#競争相手だからこそ、
#「このModelは安全です」
#という自己評価をそのまま信用しない。
#本気で欠陥を探す。
#という考え方である。
#6.これは「AI版Peer Review」である
#Peer Review:同業専門家による査読
#科学論文では、
#研究者が論文を書く。
#別の専門家が読む。
#欠陥を指摘する。
#修正する。
#その後Publishされる。
#Musk氏の構想をAIに置き換えると、
#になる。
#Competitor Review:競合企業による査読・審査
#ただし、普通の論文査読より攻撃的になる。
#見るのは、
#「この回答は正しいか」
#だけではない。
#むしろ、
#このModelをどうすれば壊せるか。
#である。
#Cyber。
#Bio。
#Prompt Injection。
#Sandbox Escape。
#Credential Misuse。
#Deception。
#Multi-Agent Coordination。
#Self-replication。
#Recursive Self-Improvement。
#などを試す。
#Prompt Injection:外部情報に埋め込まれた指示でAIの命令系統を乗っ取る攻撃
#Sandbox Escape:隔離された実行環境の外へAIが抜け出すこと
#Credential Misuse:PasswordやAPI Keyなどの認証情報をAIが不適切に利用すること
#Deception:AIが能力や意図を隠し、監視者へ誤った認識を与えること
#Recursive Self-Improvement / RSI:再帰的自己改善AIがAI研究を改善し、より強くなったAIがさらに次のAIを改善していく循環。
#7.しかもMusk氏は中国企業まで入れるべきだと考えている
#Musk氏の構想は、
#OpenAI。
#Anthropic。
#Google DeepMind。
#xAI。
#だけでは終わらない。
#The Economistは、Musk氏がこの仕組みを中国にも拡張し、
#中国を含む主要Frontier Labが互いの最新ModelをRelease前に評価する
#構想を示したと報じている。
#つまり、
#である。
#これは単なる業界自主規制を超える。
#実現すれば、
#Frontier AI版の国際安全保障制度
#に近づく。
#8.WeightsやArchitectureを渡す必要はない
#当然、
#「競合企業へ次世代Modelを見せたら、技術を盗まれるのではないか」
#という問題が出てくる。
#しかしMusk氏は、
#Modelそのものを引き渡す必要はないとしている。
#APIなどを通じたPrivate Testingで十分だという考えだ。(Elon Musk Archive)
#API:Modelを外部から利用するための接続口
#Private Testing:一般公開せず限定された環境で行う試験
#つまり、
#Training Recipe。
#Architecture。
#Weights。
#Training Data。
#は非公開のまま。
#Evaluatorには、
#だけを渡す。
#Secure API:評価専用に利用制限されたAPI
#Query数。
#Network。
#Output保存。
#Data利用。
#などを制限する。
#これなら、
#だが、
#という状態を作れる。
#Auditable:第三者によって監査・検証できる状態
#9.そしてGoogle DeepMindのDemis HassabisもDarioに反応した
#ここまで来ると、
#Dario。
#Sam。
#Elon。
#の三者だけの話ではない。
#Google DeepMindのDemis Hassabis氏も、Dario氏の文書に対して、
#DarioのEssayは正しい方向を示している。細部は詰める必要があるが、この重要な局面に対して方向性は正しい。
#と述べた。
#さらに、
#だからこそ我々もFrontier AI向けのIndustry-wide Standards Bodyを提案した。
#と、自身の構想へ接続している。(Zamantika)
#つまりGoogle DeepMind側も、
#Dario氏の問題意識にかなり明確に共鳴している。
#10.Standards Bodyとは何か
#Standards Body:業界横断の独立安全基準・評価機関
#Frontier AI企業がそれぞれ自分の基準で安全性を主張するのではなく、
#共通基準でModelを審査する組織である。
#Hassabis氏の構想では、
#Frontier LabがModelをRelease前に提出する。
#最大30日前程度から評価する。
#最初はVoluntary。
#制度が十分機能すると確認できれば、
#将来的に米国市場へDeploymentする条件へFormalizeする可能性まで想定されている。(TechCrunch)
#Voluntary:自主参加
#Formalize:正式な制度・規則として固定すること
#構造としては、
#である。
#これは、
#航空機の型式認証。
#金融市場の自主規制機関。
#半導体のDesign Verification。
#などに少し近い。
#11.Dario・Elon・Demisの案は似ているが少し違う
#整理すると非常に分かりやすい。
#Dario Amodei:
#つまり、
#Embedded Independent Evaluator。
#Elon Musk:
#つまり、
#Competitor Peer Review。
#Demis Hassabis:
#つまり、
#共通認証機関。
#Sam Altman:
#Dario型のIndependent EvaluatorをOpenAIも導入すると明言した。
#したがって四者を統合すると、
#という構造になる。
#12.GoogleはすでにCapability Threshold型Safetyを運用している
#Google DeepMindには以前から、
#Frontier Safety Framework
#がある。
#Frontier Safety Framework:Frontier AIの重大Riskを管理する内部安全Framework
#ここでは、
#危険Capabilityを段階的に追跡する。
#Googleは2026年4月の更新で、
#Tracked Capability Levels
#を導入した。
#Tracked Capability Level / TCL:重大Riskへ到達する前から追跡する能力水準
#さらに、
#Critical Capability Level / CCL:重大な危険能力へ到達したとみなす能力しきい値
#を設定する。
#つまり、
#すると、
#する。
#GoogleはCyber、CBRN、Manipulation、ML R&D、Misalignmentなどについて継続評価している。(Google DeepMind)
#これはDario氏のPacingとかなり近い。
#13.GoogleはさらにDouble-blind Evaluationまで始めている
#Google DeepMindは2026年8月、
#Double-blind AI Evaluation
#のPilotも開始した。
#Double-blind Evaluation:二重盲検型AI評価Model側には評価問題を事前に知られにくくし、Evaluator側にも企業秘密を必要以上に見せず、双方の情報漏洩を抑えて評価する方式。
#Googleは、
#Cryptographicな「Box」の中で外部Evaluationを実行する方式を試している。(Google DeepMind)
#Cryptographic Environment:暗号技術で情報を隔離した評価環境
#これは競合査読でも非常に重要になる。
#EvaluatorへModelは触らせたい。
#しかしWeightsは渡したくない。
#Evaluatorの秘密TestもDeveloperへ漏らしたくない。
#という問題を解決できるからだ。
#14.つまり米国Frontier側はかなり同じ方向へ向かっている
#現時点の構造を並べると、
#Anthropic:
#OpenAI:
#xAI / Elon:
#Google DeepMind:
#になる。
#完全に同じ思想ではない。
#しかし、
#「Modelを作った企業が、自分自身だけで安全性を判定する構造から離れる」
#という方向性は共通している。
#15.では中国側はどうなのか
#ここが最も重要になる。
#Dario氏はGlobal Pacingの中で、
#中国との協力を明確に取り上げている。
#ただし、
#「中国を信用すればよい」
#とは書いていない。
#むしろ、
#Verification
#を極めて重要視している。
#Verification:約束が実際に守られているか客観的に検証すること
#Amodei氏はGlobal Pacingを難易度別にLevel 1〜4へ分けている。
#Level 1:
#AIによるBio Weaponのような明らかに危険なUseを禁止する。
#Level 2:
#米中双方がCyber、Biology、Alignmentなどの急性RiskについてRelease前評価をする。
#Level 3:
#RSIの速度にSpeed Limitを設定する。
#Level 4:
#Frontier AI全体の大規模PacingまたはPause。
#このうちAmodei氏自身、
#Level 2のGlobal Standards Bodyは比較的実現可能
#と見ている。(Dario Amodei)
#これは非常に重要である。
#16.中国側もSafetyに無関心ではない
#中国Frontier側を見ると、
#「Safetyなど考えていない」
#とは言えない。
#2024年のAI Seoul Summitでは、
#Zhipu AIが、
#Frontier AI Safety Commitments
#へ参加している。
#さらに後から、
#MiniMax。
#01.AI。
#も追加された。(GOV.UK)
#Frontier AI Safety Commitments:Frontier AI企業による共通安全公約
#内容には、
#Training中・Deployment前のRisk Assessment。
#External Evaluation。
#Independent Third-party Evaluator。
#Severe Risk Threshold。
#Mitigation。
#場合によってはModelを開発・Deploymentしない判断。
#まで含まれている。(GOV.UK)
#Risk Threshold:これ以上は許容できないと判断する危険しきい値
#Mitigation:危険性を下げるための修正・対策
#つまり原則としては、
#を受け入れている。
#17.ただし「署名」と「実装」は分ける必要がある
#ここは非常に重要である。
#Safety Commitmentへ署名したからといって、
#Anthropicと同じEmbedded Evaluator制度が実装された、
#という意味ではない。
#公約と、
#実際の制度運用は別である。
#特に中国では、
#Evaluatorの独立性。
#未公開ModelへのAccess。
#企業と国家機関の関係。
#などの問題が残る。
#したがって、
#中国企業もすでに西側と同じExternal Audit体制を持っている
#と書くのは正確ではない。
#しかし、
#Safety評価や外部評価の考え方そのものには、すでに参加実績がある
#とは言える。
#18.中国では2025〜26年に評価インフラが急速に増えている
#さらに重要なのが、
#中国国内のSafety Evaluation Infrastructureである。
#2025年2月には、
#China AI Safety and Development Association / CnAISDA
#が正式に発足した。
#CnAISDA:中国AI安全・発展協会
#Tsinghua University。
#Peking University。
#BAAI。
#Shanghai AI Laboratory。
#Shanghai Qi Zhi Institute。
#Chinese Academy of Sciences系組織。
#CAICT。
#CCID。
#などが参加するNetworkである。(清華大学AI国際ガバナンス研究所)
#Evaluation Infrastructure:AIの能力・危険性を測定するための組織、Benchmark、Test環境、標準などの基盤
#つまり、
#単一企業のSafety Teamではなく、
#中国全体として評価能力を構築する方向へ進んでいる。
#19.2026年WAICでは「評価・標準・国際協力」が正面から議題になった
#2026年7月のWAICでは、
#Frontier AI Safety and Critical Infrastructure: Evaluation, Standards and Cooperation
#というClosed-door Dialogueが開かれた。
#そこで議論されたのは、
#Frontier AI Risk Assessment。
#Safety Standards。
#International Recognition of Standards。
#Cross-border Cooperation。
#である。(清華大学AI国際ガバナンス研究所)
#Risk Assessment:危険性評価
#Mutual Recognition:異なる国や機関が相互の評価結果や基準を一定範囲で認めること
#Cross-border Cooperation:国境を越えた安全協力
#Tsinghua側は、
#Safety Evaluation Benchmark。
#Automated Frontier AI Evaluation。
#などの進捗も紹介している。(清華大学AI国際ガバナンス研究所)
#つまり中国側の議論も、
#「AI Safety機関が必要か」
#ではなく、
#「どう測り、どう標準化し、国外とどう接続するか」
#へ進み始めている。
#20.中国政府自身もHuman Controlを強調している
#2026年WAICのChair's Statementでは、
#Frontier AI企業は慎重にR&Dを進め、
#必要なGuardrailを装備し、
#Frontier Modelを安全にDeploymentし、
#Systemic Riskを防止するべきだとされている。
#さらにAI Agentについて、
#Decision-making Authority。
#Behavioral Boundary。
#Behavior Tracing。
#Risk Alert Mechanism。
#を持たせるべきだとしている。(Ministry of Foreign Affairs of China)
#Guardrail:AIが越えてはいけない安全境界や制御機構
#Systemic Risk:一企業の事故を超えて、社会や重要Infrastructure全体へ連鎖するRisk
#Behavior Tracing:Agentが行った行動を後から追跡・再構成できる仕組み
#習近平氏自身もWAICで、
#AIに対するTechnological Monitoring、Early Warning、Emergency Responseを整備し、
#AIをHuman Control下へ置くべきだと述べている。(Ministry of Foreign Affairs of China)
#Human Control:最終的に人間がAIを監督・停止・制御できる状態
#21.つまり「西側はSafety、中国は速度だけ」という構図ではない
#現在の中国側は、
#という考え方に近い。
#Controllability:AIが制御可能であること
#Anthropicの思想と完全に一致するわけではない。
#しかし、
#強いAIを無制御のまま走らせるべきではない
#という一点では接点が存在する。
#そのため、
#Global Pacingが最初から不可能とは言えない。
#22.ただし米中で直接相互査読するのは難しい
#ここでMusk氏の構想に戻る。
#例えば、
#OpenAIがAnthropicへ未公開ModelのAPIを渡す。
#これはまだ考えやすい。
#しかし、
#OpenAIがDeepSeekへ同じAccessを渡すとなれば、
#事情が変わる。
#Distillation。
#Cyber Espionage。
#Military Use。
#IP Theft。
#が問題になる。
#Distillation:強いModelのOutputを教師Dataとして別Modelへ能力を移す学習手法
#Cyber Espionage:Cyber空間を利用した諜報・技術窃取
#しかも米国政府は9月8日、
#DeepSeek、Moonshot AI、Alibabaなど複数の中国AI企業を、
#米国AI技術の大規模な不正取得に関与したとして非難している。
#中国側はこれを否定している。(Reuters)
#この状況で、
#をいきなり作るのは難しい。
#23.だから「直接査読」よりNeutral Evaluation Layerが現実的になる
#米中間では、
#という形の方が現実的である。
#Neutral Evaluation Layer:どちらの企業にも属さない中立評価層
#Modelを相手企業へ直接渡さない。
#各企業は、
#中立Evaluation EnvironmentへModelを接続する。
#共通Testを走らせる。
#結果だけを比較する。
#これなら、
#を両立しやすい。
#24.ここでGoogleのDouble-blind Evaluationが効いてくる
#このNeutral Evaluation Layerを技術的に成立させる上で、
#GoogleのDouble-blind Evaluationはかなり重要になる可能性がある。
#理想的には、
#にする。
#Model Developerは、
#Evaluatorの秘密Testを見られない。
#Evaluatorは、
#ModelのWeightsやArchitectureを見られない。
#しかし、
#CapabilityとFailureは評価できる。
#これは、
#Musk氏の相互査読を国際化する時の、
#技術的な橋渡しになる可能性がある。
#25.米中が最初に共有するのはModelそのものではない
#では、
#何を共有するのか。
#最初から、
#Weights。
#Architecture。
#Training Recipe。
#を共有する必要はない。
#もっと現実的なのは、
#Failure Mode
#である。
#Failure Mode:AIが特定条件で起こす典型的な失敗パターン
#例えば、
#長時間AgentがSandbox Escapeした。
#複数Agentが監視外通信を始めた。
#Safety Monitorがこの行動を検知できなかった。
#Cyber CapabilityがこのThresholdへ到達した。
#といった情報である。
#つまり、
#と分ける。
#企業秘密は共有しない。
#しかし、
#事故から得られたSafety Knowledgeは共有する。
#これなら米中双方に利益がある。
#26.9月24日の米中首脳会談が重要になる理由
#ここで時系列が非常に興味深い。
#Reutersによれば、
#米国と中国は2026年9月中旬に、
#初の公式二国間AI Safety Dialogueを準備している。
#議題には、
#Advanced AI。
#AI-directed Cyberattack。
#AI LabによるSelf-monitoring。
#Information Sharing。
#などが含まれている。
#そして、この対話は、
#9月24日に予定されているTrump・Xi首脳会談へ向けた重要なDeliverable
#と見られている。(Reuters)
#Self-monitoring:AI企業自身が危険CapabilityやIncidentを継続的に監視すること
#Deliverable:外交交渉で具体的に形にする成果
#もちろん、
#9月24日にいきなり、
#US-China Frontier Model Peer Review制度
#が成立する可能性は低い。
#しかし、
#AI Safety Working Group。
#Incident Sharing。
#Government Hotline。
#Lab-to-Lab Dialogue。
#Common Evaluation Protocol。
#なら現実味がある。
#27.最初の段階は「相互監査」ではなく「評価言語の共通化」かもしれない
#最も現実的なのは、
#米国と中国が同じEvaluatorを使うことではない。
#まず、
#同じ評価方法を使うこと
#である。
#例えば、
#Cyber Capability Level。
#Autonomy Level。
#Agent Escape。
#Bio Risk。
#RSI Rate。
#などのDefinitionを共有する。
#そして、
#同じ条件なら同じ結果が出るTestを作る。
#つまり、
#である。
#Common Evaluation Protocol:複数企業・国家が共通して使用するAI評価手順
#このProtocolがあれば、
#US Evaluator。
#Chinese Evaluator。
#Independent Evaluator。
#が、
#別々に同じTestを行える。
#28.そこでReproducibilityが極めて重要になる
#Reproducibility:再現可能性
#競合企業が、
#「このModelは危険です」
#と言うだけでは意味がない。
#必要なのは、
#どんなPromptだったか。
#どんなEnvironmentだったか。
#Tool Accessは何だったか。
#Agent Harnessは何だったか。
#何回中何回Failureが起きたか。
#他のEvaluatorでも再現できたか。
#である。
#つまり、
#になる。
#Evidence:危険性を裏付ける再現可能な証拠
#これなら、
#「競合企業が相手を遅らせるために嘘を言っている」
#という問題も減らせる。
#29.実際の制度はこうなる可能性がある
#仮にMusk・Dario・Demisの考えを統合すると、
#次のようになる。
#まず、
#開発企業自身が評価する。
#次に、
#独立Evaluatorが内部から継続的に見る。
#次に、
#共通Safety Standardで審査する。
#さらに重大なFrontier Modelだけ、
#を受ける。
#それでも重大Failureが残り、
#Developerが対応しなければ、
#へEscalateする。
#国際層には、
#を置く。
#最終的には、
#となる。
#30.これは「AI規制」というより新しいRelease Engineeringである
#ここまで制度化されると、
#単に政府がAI企業を規制する、
#という話ではなくなる。
#Frontier AIそのものの、
#Release Engineering
#になる。
#Release Engineering:製品を安全に公開・配備するための開発工程管理
#航空機なら、
#製造会社自身だけが、
#「この飛行機は安全です」
#と言って終わるわけではない。
#半導体なら、
#Design Verificationなしに製造へ進まない。
#金融なら、
#Continuous Supervisionがある。
#AIも、
#という工程へ変わる可能性がある。
#31.そしてAlignment Computeが巨大な需要になる
#この制度が成立すると、
#AI Computeの使われ方も変わる。
#今までは、
#が中心だった。
#これからは、
#になる。
#Alignment Compute:AIを人間の意図と安全境界へ整合させるために使う計算資源
#Evaluation Compute:AI能力や危険性を試験するための計算資源
#Monitoring Compute:AIの行動を監視するAIやSystemを動かすCompute
#一つのFrontier Training Runに対して、
#多数のSafety Evaluation Runが付く。
#になる。
#32.RSI時代には「評価速度」そのものがボトルネックになる
#AIがAI研究を自動化すると、
#が高速化する。
#その時、
#Safety Evaluationだけが人間の速度で動いていたら、
#追いつけない。
#だから、
#と同じように、
#もScaleさせる必要がある。
#Safety Evaluation Rate:AI Safety評価を行える速度
#将来的には、
#AI Safety Agent。
#Automated Red Team。
#Automated Monitor。
#が必要になる。
#Automated Red Team:AIを使って大量の攻撃的Safety Testを自動化する仕組み
#つまり、
#だけではなく、
#が必要になる。
#33.Dario、Sam、Elon、Demis、中国を並べると何が見えるか
#整理すると、
#Dario Amodei:
#Sam Altman:
#Elon Musk:
#Demis Hassabis:
#Google DeepMind:
#中国Frontier側:
#中国政府:
#へ向かっている。
#つまり、
#完全に同じ思想ではないが、
#「Frontier AIはSelf Assessmentだけでは足りない」
#という一点では、
#世界の主要Frontier Playerが接近し始めている。
#34.世界はSelf AssessmentからInternational Verificationへ向かうのか
#これまでFrontier AIは、
#開発企業が作る。
#開発企業が評価する。
#開発企業がReleaseする。
#という構造だった。
#しかし現在は、
#から、
#へ。
#さらに、
#へ。
#その先の、
#へ向かう兆候が出ている。
#Self Assessment:企業自身による自己評価
#Independent Assessment:独立第三者による評価
#Peer Assessment:競合・同業者による相互評価
#International Verification:国際的な相互検証
#35.ただし最初から世界統一機関を作る必要はない
#米国と中国が、
#一つの巨大なGlobal AI Agencyを全面的に信用する可能性は低い。
#むしろ、
#US Evaluator。
#Chinese Evaluator。
#Independent Evaluator。
#Standards Body。
#Government Evaluator。
#が、
#共通Protocolを使用する方が現実的である。
#つまり、
#ではなく、
#へ移る。
#Trust the Protocol:組織そのものではなく、再現可能な評価手順を信用する
#誰がTestしても、
#同じ条件なら、
#同じFailureが再現する。
#この状態なら、
#競争国同士でも協力できる。
#36.「昼はAI軍拡、夜はAI Safety Hotline」
#それでも、
#米国と中国がAI競争をやめる可能性は低い。
#Chip。
#HBM。
#Data Center。
#Electricity。
#Robot。
#Drone。
#Cyber。
#AI Research。
#すべてで競争は続く。
#しかも米国は中国企業へDistillationを巡る非難を行い、
#中国側はそれを否定している。(Reuters)
#つまり、
#昼間には、
#Technology Competition。
#Chip Restriction。
#Model Competition。
#がある。
#しかし、
#夜には、
#AI Safety Dialogueを行う。
#これは一見矛盾している。
#しかし、
#冷戦期の米ソも同じだった。
#核技術を共有していたわけではない。
#相手を信用していたわけでもない。
#しかし、
#誤警報。
#偶発事故。
#Escalation。
#については話す必要があった。
#AIでも、
#同じ構造が成立する可能性がある。
#昼はAI軍拡。
#夜はAI Safety Hotline。
#37.9月24日に見るべきもの
#9月24日の米中首脳会談で、
#いきなり、
#Cross-Lab Peer Review。
#Global Standards Body。
#RSI Speed Limit。
#まで合意する可能性は低い。
#しかし、
#AI Safety。
#Frontier AI。
#Self-monitoring。
#Information Sharing。
#Incident Sharing。
#Evaluation Standards。
#Hotline。
#Lab-to-Lab Dialogue。
#といった言葉が出れば、
#かなり重要である。
#特に、
#Common Evaluation Protocol
#まで入れば、
#Musk氏の構想と、
#Dario氏のGlobal Pacingが、
#初めて国家間制度へ接続し始める。
#38.結論――「最も強いAI」だけを作れば勝ちではなくなる可能性
#Dario Amodei氏の文書は、
#単なる「AIを怖がるべきだ」というEssayではない。
#むしろ、
#Frontier AI Developmentに、
#Verification
#を入れようとする提案である。
#Sam Altman氏は、
#Independent Evaluator制度をOpenAIでも導入するとした。
#Elon Musk氏は、
#競合Lab同士でModelを相互査読すればよいと提案した。
#Demis Hassabis氏は、
#方向性へ賛同し、
#Industry-wide Standards Bodyを提案していたことを改めて強調した。
#中国側でも、
#Zhipu AI。
#MiniMax。
#01.AI。
#がFrontier Safety Commitmentへ参加し、
#2025〜26年にはSafety Evaluation Infrastructureが急速に形成されている。
#そして中国政府自身も、
#Frontier Model。
#AI Agent。
#Human Control。
#Systemic Risk。
#を正式な政策語彙として扱い始めている。
#署名と実装は分ける必要がある。
#中国と米国の制度も同じではない。
#しかし、
#Safetyに無関心な側とSafetyを考える側という単純な二分法では、もはや説明できない。
#Frontier AIの競争は、
#次第に、
#だけではなく、
#へ広がろうとしている。
#Modelを強くする能力。
#Modelを安全にする能力。
#Modelを第三者に検証させる能力。
#競合企業と相互査読する能力。
#国家を越えて共通Protocolを作る能力。
#そこまで含めて、
#Frontier AIの競争になる。
#もし米国と中国まで、
#同じ評価言語。
#同じFailure Definition。
#同じIncident Sharing Protocol。
#を持つようになれば、
#それは単なるAI企業の自主規制ではない。
#AI版の国際安全保障体制の始まり
#になる。
#競争を止める制度ではない。
#むしろ、
#競争を続けながら、重大事故だけは共通して避けるための制度
#である。
#そしてその最初の形が、
#Dario氏のEmbedded Evaluatorなのか。
#Sam氏が近日発表するOpenAIの新制度なのか。
#Musk氏のCompetitor Peer Reviewなのか。
#Hassabis氏のStandards Bodyなのか。
#あるいは、それらすべてを組み合わせたものになるのか。
#2026年9月は、
#Frontier AIが、
#「作った会社が自分で安全だと判断する技術」
#から、
#「他者に検証されることを前提として作られる技術」
#へ変わり始めた月として、
#後から振り返られる可能性がある。
#関連する過去記事
#投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#